Семантическая сегментация с Ultralytics YOLO#
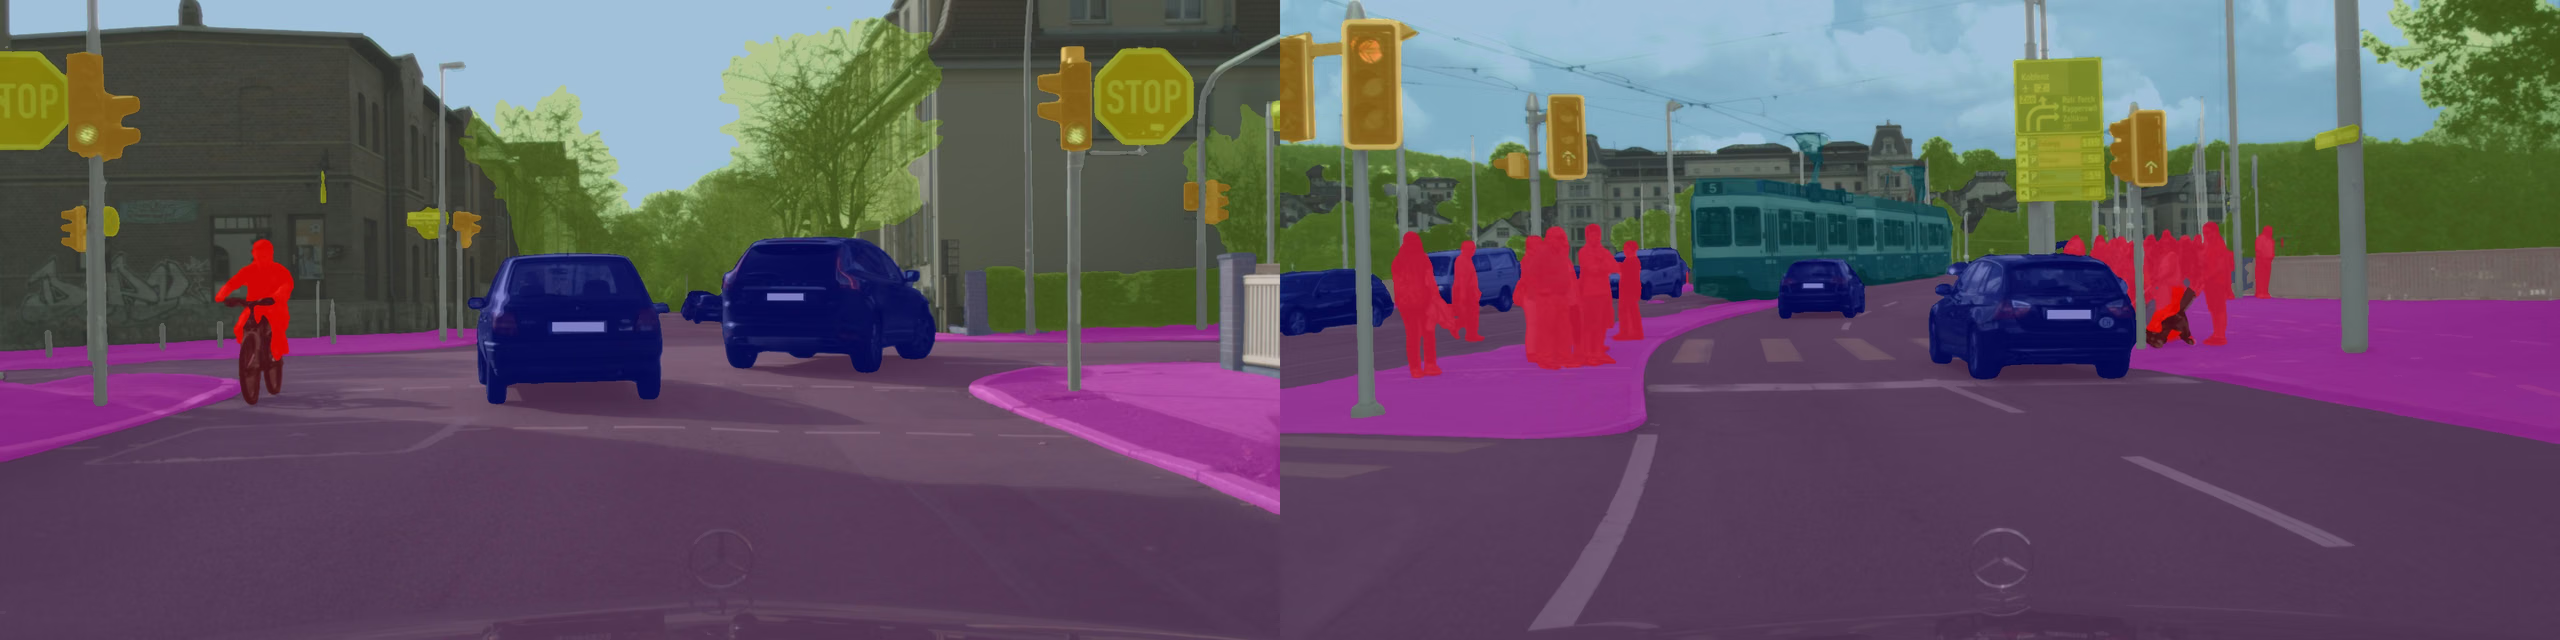
Семантическая сегментация назначает метку класса каждому пикселю изображения и создает плотную карту классов, охватывающую всю сцену. В отличие от сегментации экземпляров, которая разделяет отдельные объекты, семантическая сегментация объединяет все пиксели одного класса независимо от количества отдельных объектов.
Смотри: Семантическая сегментация с Ultralytics YOLO26 | Краткое руководство
Модель семантической сегментации выдает одну карту классов высотой и шириной с изображение, где значение каждого пикселя соответствует предсказанному ID класса. Поэтому семантическая сегментация подходит для анализа сцен, например в задачах автономного вождения, обработки медицинских изображений и картографирования земного покрова.
Для семантической сегментации используй task=semantic или задачу CLI yolo semantic. Файлы моделей семантической сегментации YOLO26 имеют суффикс -sem, например yolo26n-sem.pt.
Модели#
Ниже представлены предварительно обученные на наборе данных Cityscapes модели YOLO26 Semantic.
Модели автоматически загружаются из последнего релиза Ultralytics при первом использовании.
| Модель | размер (пиксели) | mIoUval | Скорость RTX3090 PyTorch (мс) | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- Значения mIoUval рассчитаны для одной модели и одного масштаба на валидационной выборке Cityscapes.
Воспроизвести результат можно с помощьюyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - Метрики скорости усреднены по изображениям валидационной выборки Cityscapes с использованием экземпляра RTX3090.
Воспроизвести результат можно с помощьюyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - Значения Params и FLOPs указаны для объединенной модели после
model.fuse(), которая объединяет слои Conv и BatchNorm. Предварительно обученные контрольные точки сохраняют полную архитектуру обучения, поэтому их значения могут быть выше.
Ниже представлены предварительно обученные на наборе данных ADE20K модели YOLO26 Semantic.
| Модель | размер (пиксели) | mIoUval | Скорость RTX3090 PyTorch (мс) | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- Значения mIoUval рассчитаны для одной модели и одного масштаба на валидационной выборке ADE20K.
Воспроизвести результат можно с помощьюyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640, заменивyolo26n-sem-ade20k.ptна нужную контрольную точкуyolo26*-sem-ade20k.pt. - Метрики скорости усреднены по изображениям валидационной выборки ADE20K с использованием экземпляра RTX3090.
Воспроизвести результат можно с помощьюyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640, заменивyolo26n-sem-ade20k.ptна нужную контрольную точкуyolo26*-sem-ade20k.pt. - Значения Params и FLOPs указаны для объединенной модели после
model.fuse(), которая объединяет слои Conv и BatchNorm. Предварительно обученные контрольные точки сохраняют полную архитектуру обучения, поэтому их значения могут быть выше.
Предварительные результаты mIoU на Cityscapes смотри в анонсе предстоящего YOLO27.
Обучение#
Обучи YOLO26n-sem на наборе данных Cityscapes8 в течение 100 эпох с размером изображения 1024. Полный список доступных аргументов смотри на странице Configuration.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-sem.yaml")  # создать новую модель из YAML
model = YOLO("yolo26n-sem.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # создать модель из YAML и перенести веса

# Обучить модель
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Полное описание режима train смотри на странице Train. Модели семантической сегментации также можно обучать в облаке с помощью Ultralytics Platform.
Формат датасета#
Для семантической сегментации используются одноканальные изображения масок, обычно в формате PNG, где значение каждого пикселя обозначает ID класса. Пиксели со значением 255 считаются «игнорируемыми» и исключаются из вычисления функции потерь. В YAML-файле набора данных нужно указать пути к изображениям и соответствующим каталогам масок. Наборы данных с полигональной разметкой YOLO используются для обучения напрямую, а маски создаются на лету (см. раздел Можно ли использовать данные сегментации экземпляров ниже). Подробности о формате смотри в руководстве по наборам данных для семантической сегментации. Поддерживаются, в частности, Cityscapes и ADE20K. Управлять наборами данных для семантической сегментации и размечать их можно с помощью Ultralytics Platform.
Валидация#
Проверь точность обученной модели YOLO26n-sem на наборе данных для семантической сегментации. Явно укажи data, чтобы при валидации использовался нужный YAML-файл набора данных.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-sem.pt")  # загрузить официальную модель
model = YOLO("path/to/best.pt")  # загрузить пользовательскую модель

# Валидировать модель
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # среднее пересечение по объединению
metrics.pixel_accuracy # общая точность по пикселямПредсказание#
Используй обученную модель YOLO26n-sem для предсказаний на изображениях.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-sem.pt")  # загрузить официальную модель
model = YOLO("path/to/best.pt")  # загрузить пользовательскую модель

# Получи предсказания с помощью модели
results = model("https://ultralytics.com/images/bus.jpg")  # получи предсказание для изображения

# Обратись к результатам
for result in results:
    semantic_mask = result.semantic_mask.data  # карта классов, форма (H,W), целочисленный тип данных выбирается в зависимости от количества классов
Полное описание режима predict см. на странице Предсказание.
Результаты работы#
При семантической сегментации YOLO возвращает один объект Results для каждого изображения. Каждый результат содержит одну плотную карту классов для всего изображения, а не список масок объектов. Пиксели с одинаковым предсказанным классом имеют один и тот же ID класса, даже если они принадлежат разным объектам.
| Атрибут | Тип | Форма | Описание |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Плотная карта классов. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | Идентификаторы классов; тип данных выбирается в зависимости от количества классов. |
result.masks | - | - | Маски экземпляров отсутствуют. |
result.boxes | - | - | Боксы/оценки уверенности экземпляров отсутствуют. |
Описание полей Results, специфичных для каждой задачи, см. в разделе Результаты предсказаний по задачам.
Семантическая сегментация предсказывает плотную карту классов, а затем изменяет ее размер до размеров исходного изображения для визуализации и дальнейшего использования. Поэтому очень тонкие объекты — например, дорожная разметка, линии на площадке, столбы или провода — могут выглядеть ступенчатыми, если вывод выполняется при значительно меньшем imgsz, чем разрешение исходного изображения. Если границы выглядят зубчатыми, сначала повторно проверь нативную модель PyTorch .pt, используя большее значение imgsz, например 1024, 1280 или ближайшее практичное значение к размеру исходного изображения. Используй экспортированные модели, только убедившись, что результат .pt приемлем, поскольку при входных изображениях с низким разрешением невозможно восстановить мелкие детали, отсутствующие на предсказанной карте классов.
Сегментация экземпляров и семантическая сегментация#
| Аспект | Сегментация экземпляров (task="segment") | Семантическая сегментация (task="semantic") |
|---|---|---|
| Цель предсказания | Сегментировать каждый обнаруженный объект отдельно | Назначить каждому пикселю один ID класса |
| Поле результата | result.masks | result.semantic_mask |
| Основные данные | result.masks.data | result.semantic_mask.data |
| Форма | (N,H,W) | (H,W) |
| Значения пикселей | Значения бинарной маски: 0 или 1 | ID классов: 0, 1, 2, ... |
| Тип данных | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Объекты одного класса | Сохраняются как отдельные экземпляры | Объединяются в одну область класса |
| Полигоны | Да, через result.masks.xy и result.masks.xyn | По умолчанию полигоны не формируются |
| Боксы и оценки уверенности | Да, через result.boxes | Нет боксов и оценок уверенности для отдельных экземпляров |
| Типичное применение | Подсчет, отслеживание, обрезка, измерения на уровне объектов | Плотная разметка сцен, проезжая часть, земной покров, области на медицинских изображениях |
Экспорт#
Экспортируй модель YOLO26n-sem в другой формат, например ONNX, CoreML и т. д.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-sem.pt")  # загрузить официальную модель
model = YOLO("path/to/best.pt")  # загрузить пользовательскую модель

# Экспортировать модель
model.export(format="onnx")
Доступные форматы экспорта YOLO26 для семантической сегментации перечислены в таблице ниже. Экспортировать модель можно в любой формат с помощью аргумента format, например format='onnx' или format='engine'. На экспортированных моделях можно сразу выполнять предсказания или валидацию, например yolo predict model=yolo26n-sem.onnx. После завершения экспорта для твоей модели будут показаны примеры использования.
| Формат | Аргумент format | Модель | Метаданные | Аргументы |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-sem_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None по умолчанию возвращает исходные выходные данные для внешней NMS. Укажи nms=False, чтобы выбрать доступную голову без NMS; неподдерживаемые форматы используют собственный путь вывода. Элементы nms выше обозначают форматы, в которые можно встроить NMS с помощью nms=True.
Полное описание export смотри на странице экспорта.
Часто задаваемые вопросы#
Чтобы обучить модель семантической сегментации YOLO26 на пользовательском датасете, подготовь PNG-маски, в которых значение каждого пикселя соответствует ID класса (0, 1, 2, ...), а пиксели со значением 255 игнорируются во время обучения. Создай YAML-файл датасета, указывающий на каталоги с изображениями и масками, а затем обучи модель:
Примерfrom ultralytics import YOLO # Загрузи предварительно обученную модель семантической сегментации YOLO26 model = YOLO("yolo26n-sem.pt") # Обучить модель results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=1024)Другие доступные аргументы смотри на странице Configuration.
Сегментация экземпляров и семантическая сегментация — это задачи на уровне пикселей, но они различаются одним важным аспектом:
- Семантическая сегментация присваивает метку класса каждому пикселю, но не различает отдельные объекты одного класса. Например, все автомобили на изображении имеют одну и ту же метку класса.
- Сегментация экземпляров распознает каждый отдельный объект и создает для него отдельную маску, даже если объекты относятся к одному классу.
Семантическая сегментация лучше всего подходит для задач понимания сцены, таких как автономное вождение и картирование земного покрова, а сегментация экземпляров предпочтительна, когда важно считать или отслеживать отдельные объекты.
Да. Если в датасете используются полигональные метки Ultralytics YOLO (один
.txtна изображение), не указывайmasks_dirв YAML-файле датасета и убедись, что рядом с изображениями в корневом каталоге датасета нет папкиmasks/(ее наличие само по себе включает режим PNG-масок, даже еслиmasks_dirне задан). Затем загрузчик на лету преобразует полигоны в семантические маски для каждого изображения. Для многоклассовых датасетов (N > 1) дополнительный классbackgroundавтоматически добавляется вnames. Для одноклассовых датасетов (N == 1) обучение остается одноклассовым: объявленный класс становится1в маске, а непокрытые пиксели получают значение0. Подробности смотри в руководстве по датасетам для семантической сегментации.Ultralytics YOLO26 включает готовые конфигурации для нескольких датасетов семантической сегментации:
- Cityscapes: городские уличные сцены с 19 классами, широко используемые в исследованиях автономного вождения.
- ADE20K: крупномасштабный датасет для парсинга сцен, содержащий 150 классов.
Можно также использовать любой пользовательский датасет с разметкой в виде PNG-масок, где значения пикселей соответствуют ID классов.
Проверь предварительно обученную модель семантической сегментации YOLO26 с помощью YAML-файла датасета, используемого для оценки:
Примерfrom ultralytics import YOLO # Загрузи предварительно обученную модель model = YOLO("yolo26n-sem.pt") # Валидировать модель metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Эти шаги позволят получить метрики проверки, например среднее пересечение над объединением (mIoU) и точность по пикселям — стандартные показатели качества семантической сегментации.
Экспортируй модель семантической сегментации YOLO26 в формат ONNX с помощью команд Python или CLI:
Примерfrom ultralytics import YOLO # Загрузи предварительно обученную модель model = YOLO("yolo26n-sem.pt") # Экспортировать модель в формат ONNX model.export(format="onnx")Подробности об экспорте в различные форматы смотри на странице Export.