Экспорт Qualcomm QNN
Qualcomm AI Engine Direct, также называемый QNN, — это среда выполнения Qualcomm для NPU Hexagon процессоров Snapdragon и Dragonwing. Экспорт модели Ultralytics YOLO26 с помощью format="qnn" создает yolo26n_qnn.onnx — модель ONNX, единственный узел которой содержит контекстный бинарный файл QNN, скомпилированный с весами INT8 и 16-битными активациями для поколения Hexagon Tensor Processor (HTP), выбранного аргументом name. Экспорт выполняется на твоем компьютере с помощью ONNX Runtime; учетная запись или устройство Qualcomm не нужны.
Краткий обзор#
| Свойство | Описание |
|---|---|
Аргумент format | qnn |
| Результат | yolo26n_qnn.onnx, один файл ONNX с узлом EPContext, в который встроен скомпилированный бинарный файл контекста QNN, а также названия классов, задача и размер изображения в виде метаданных |
| Поддерживаемые устройства | Набор поколений HTP для Hexagon NPU с name: телефоны Snapdragon от Snapdragon 888 до 8 Elite Gen 5, ноутбуки Snapdragon X Elite и Dragonwing IQ-8275; см. поддерживаемые цели HTP |
| Среда выполнения | ONNX Runtime с QNN Execution Provider: пакет Python onnxruntime-qnn для Windows и Linux либо ONNX Runtime с QNN в приложении Android |
| Точность | Только W8A16: веса INT8 и активации 16 бит, откалиброванные на изображениях из data. YOLO26n занимает 3,6 МБ |
| Среда для экспорта | Linux x86-64 или ARM64 либо Windows x64 или ARM64 с Python 3.11 или новее. Не macOS. Проверено на Ubuntu 24.04 x86-64. Экспорт выполняется на CPU и не требует GPU или устройства Snapdragon |
Платформа Ultralytics может экспортировать обученную модель в QNN для выбранной тобой цели HTP, поэтому локальная среда для экспорта не нужна.
Быстрый старт#
Установи пакет Ultralytics с зависимостями для экспорта ONNX и QNN Execution Provider:
pip install "ultralytics[export-base]" onnxruntime-qnnonnxruntime-qnn включает библиотеки Qualcomm AI Runtime (QAIRT) и устанавливается рядом с onnxruntime, от которого зависит. При обычной установке pip install ultralytics первый экспорт самостоятельно устанавливает onnx, onnxslim, onnxruntime и onnxruntime-qnn, выводит в журнал Restart runtime or rerun command for updates to take effect и всё равно завершается в том же запуске. Для экспорта требуются следующие версии:
| Требование | Версия |
|---|---|
| Python | От 3.11 до 3.14 — версии, для которых доступны пакеты onnxruntime-qnn 2.x. Экспорт проверен на Python 3.11, 3.12 и 3.14 |
| Операционная система | Linux x86-64 с glibc 2.35 или новее, Linux ARM64 с glibc 2.34 или новее, Windows x64 или ARM64. Для onnxruntime-qnn нет пакетов macOS; см. ограничения |
onnxruntime-qnn | 2.8.0 для каждого экспорта на этой странице, с onnxruntime 1.32.0. Ultralytics не фиксирует версию |
Другие способы установки см. в руководстве по установке. Затем экспортируй модель:
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# # Экспорт модели в формат QNN для Snapdragon 8 Elite Gen 5 (HTP v81)
model.export(format="qnn", name="81", imgsz=640)  # # Создаёт 'yolo26n_qnn.onnx'
Экспорт записывает yolo26n_qnn.onnx рядом с yolo26n.pt и завершается с ошибкой, если этот файл уже существует, поэтому перед повторным экспортом удали его или переименуй. Если не указать data, калибровка выполняется на небольшом стандартном наборе данных для задачи, например на 4 изображениях из coco8.yaml, чего достаточно для проверки экспорта; перед выпуском модели откалибруй её на изображениях из своих данных для развёртывания. См. калибровку.
Затем скопируй yolo26n_qnn.onnx на устройство Snapdragon; см. развёртывание. Predict и Validate также работают, хотя и медленно, на хосте экспорта Linux x86-64, поэтому перед копированием можно проверить экспортированный файл. Запускай каждую команду в новом процессе Python, поскольку в одном процессе не удаётся загрузить вторую модель QNN; см. ограничения:
from ultralytics import YOLO

# # Загрузка экспортированной модели QNN
model = YOLO("yolo26n_qnn.onnx")

# Выполнить инференс
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # Загрузка экспортированной модели QNN
model = YOLO("yolo26n_qnn.onnx")
# Проверить точность на наборе данных COCO8
metrics = model.val(data="coco8.yaml")Поддерживаемые задачи#
Экспорт QNN поддерживает все семь задач Ultralytics: детекцию, сегментацию, семантическую сегментацию, оценку глубины, классификацию, оценку позы и OBB. Семантическая сегментация и оценка глубины доступны только в YOLO26 — едином семействе, в котором есть такие выходные слои. Контрольная точка YOLO26n для каждой задачи экспортировалась и запускалась на хосте экспорта; то же удалось сделать и с моделью детекции YOLO11. Другие семейства моделей не проверялись.
Аргументы экспорта#
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
format | str | 'qnn' | Целевой формат экспортируемой модели, определяющий совместимость с различными средами развертывания. |
name | str | '73' | Поколение HTP или SoC, для которого скомпилирован бинарный файл контекста, например '81' или 'iq-8275'. См. поддерживаемые цели HTP. |
imgsz | int или tuple | 640 | Размер входного изображения модели, фиксируемый в бинарном файле контекста: целое число для квадратных изображений или кортеж (height, width). Если не указать значение, экспорт использует размер, на котором обучалась контрольная точка, например 1024 для OBB и 224 для классификации. |
quantize | int или str | None | Точность. Если значение не задано или указано 'w8a16', используется единственный доступный вариант точности — веса INT8 и активации 16 бит; значения 8, 16 и 32 приводят к ошибке. См. точность. Заменяет устаревшие флаги half/int8. |
data | str | None | YAML-файл набора данных с изображениями для калибровки; для классификации вместо него укажи каталог набора данных или встроенное имя набора данных. Для калибровки используется разделение val, если не задано split. Если значение не указано, Ultralytics использует небольшой стандартный набор данных для задачи, например coco8.yaml. |
fraction | float, int или list | 1.0 | Подмножество для калибровки: доля, количество изображений (целые числа больше 1) или список [train, val, test]; в последнем случае используется запись для разбиения калибровки. |
batch | int | 1 | Размер батча экспортированной модели, зафиксированный во входной форме. Также размер батча, используемый для калибровки. |
nms | bool, необязательно | None | Не влияет на результат: при любом значении записываются необработанные выходные данные None; см. формат выходных данных. |
opset | int | None | Версия opset промежуточного графа ONNX. Если значение не задано, используется наибольшая версия opset, поддерживаемая твоей версией PyTorch, но не выше 18; например, в PyTorch 2.4 или новее это 18. Квантизатор ONNX Runtime повышает её до 21 для активаций 16 бит. |
simplify | bool | True | Упрощает промежуточный граф ONNX с помощью onnxslim. |
device | str | None | Устройство, на котором трассируется промежуточный граф ONNX; по умолчанию — cpu. |
Аргументы, общие для всех форматов, описаны в документации по режиму экспорта.
Официальные мобильные модели QNN, LiteRT и Core ML экспортируются с размером imgsz=640, а для классификации — с размером imgsz=224. Контрольные точки Cityscapes для семантической сегментации, оценки глубины и OBB по умолчанию экспортируются с большим размером; чтобы использовать тот же размер, передай imgsz=640. Модели QNN для всех семи задач и всех размеров, предназначенные для HTP v73 и v81, доступны в выпуске v0.7.0 приложения yolo-flutter-app.
Поддерживаемые целевые платформы HTP#
Бинарный файл контекста компилируется для одного поколения HTP, поэтому при экспорте укажи name своего устройства. В README Flutter-плагина указано, что для официальных моделей _v73 требуется Snapdragon 8 Gen 2 или новее; другие сочетания поколений экспорта и устройства не проверялись. name принимает поколение как с начальным v, так и без него, например 81, v81 или V81, либо одно из двух названий SoC в любом регистре. Размеры указаны для YOLO26n для детекции с imgsz=640:
name | Hexagon HTP | Примеры устройств | Вариант ONNX Runtime | Файл YOLO26n |
|---|---|---|---|---|
68 | v68 | Snapdragon 888 | htp_arch=68 | 3.7 MB |
69 | v69 | Snapdragon 8 Gen 1 | htp_arch=69 | 3.8 MB |
73 (по умолчанию) | v73 | Snapdragon 8 Gen 2, Snapdragon X Elite | htp_arch=73 | 3.6 MB |
75 | v75 | Snapdragon 8 Gen 3 | htp_arch=75 | 3.6 MB |
79 | v79 | Snapdragon 8 Elite (SM8750) | soc_model=69 | 3.6 MB |
81 | v81 | Snapdragon 8 Elite Gen 5 | htp_arch=81 | 3.6 MB |
iq-8275 | v75 | Dragonwing IQ-8275 | soc_model=82 | 3.5 MB |
qcs8275 | v75 | Dragonwing QCS8275 | soc_model=82 | 3.5 MB |
Устройства Snapdragon приведены как примеры поколений, а не как полный список. Если не указать name, экспорт выводит в журнал Qualcomm QNN export requires a missing 'name' arg for the target Hexagon HTP architecture. Using default name='73' (Snapdragon 8 Gen 2).. Любое другое значение приводит к ошибке Invalid Qualcomm QNN target '66'. Valid targets are ('68', '69', '73', '75', '79', '81', 'iq-8275', 'qcs8275').. В Dragonwing IQ-615 (QCS615) используется DSP Hexagon v66, для которого в Ultralytics нет цели QNN; вместо этого экспортируй стандартную модель ONNX для CPU или GPU.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="qnn", name="iq-8275", imgsz=640) # # Создаёт 'yolo26n_qnn.onnx'Точность#
Каждый экспорт QNN квантизируется с помощью процесса QNN QDQ в ONNX Runtime до весов INT8 и активаций 16 бит (W8A16). Экспорт в FP32 или FP16 и экспорт INT8 с 8-битными активациями не поддерживаются:
quantize | Результат |
|---|---|
не задано или 'w8a16' | Бинарный файл контекста W8A16. YOLO26n занимает 3,6 МБ. Если не указать quantize, экспорт выводит в журнал qnn export requires INT8 quantization, enabling it. |
8 | Завершается с ошибкой quantize=8 (INT8) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations). |
16 | Завершается с ошибкой quantize=16 (FP16) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations). |
32 | Завершается с ошибкой quantize=32 (FP32) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations). |
Входные и выходные данные остаются float32, за исключением карты классов семантической сегментации, поскольку квантизация входных данных и обратная квантизация выходных выполняются внутри бинарного файла контекста.
Калибровка#
Экспорт калибрует диапазоны активаций на каждом полном пакете из раздела val набора данных data или из раздела, заданного параметром split, и выводит предупреждение >300 images recommended for INT8 calibration, found 4 images., если изображений меньше 300. Передай data с изображениями, похожими на данные для развёртывания, и используй fraction, чтобы ограничить их количество. При первом использовании coco.yaml скачивает весь набор данных COCO размером около 20 ГБ:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Выполнить калибровку на 10% валидационных изображений COCO (500 изображений); замени coco.yaml на собственный датасет
model.export(format="qnn", name="81", imgsz=640, data="coco.yaml", fraction=0.1)
На последних 500 изображениях из COCO val2017, которые не используются в описанной выше калибровке, YOLO26n показала следующие результаты в val на хосте экспорта x86-64 по сравнению с контрольной точкой PyTorch и экспортом ONNX в FP32 на тех же изображениях:
| Модель | mAPval 50–95 | mAPval 50 |
|---|---|---|
| PyTorch | 42.1 | 57.1 |
| ONNX FP32 | 42.0 | 56.9 |
QNN, откалиброванная на coco8.yaml (4 изображения) | 38.9 | 54.6 |
QNN, откалиброванная на coco.yaml с fraction=0.1 (500 изображений) | 39.1 | 54.5 |
Калибровка на 500 изображениях COCO вместо 4 изображений из coco8.yaml повысила mAPval 50-95 на 0,2 пункта и снизила mAPval 50 на 0,1 пункта; при этом обе модели QNN набрали на 2,9–3,1 пункта меньше, чем экспорт ONNX в FP32, по показателю mAPval 50-95. На небольших стандартных наборах данных сильнее всего просела оценка глубины: на 4 проверочных изображениях из depth8.yaml, которые также использовались для калибровки, модель QNN для оценки глубины достигла delta1 56,0% против 89,7% у экспорта ONNX в FP32. Перед развёртыванием проверь экспортированную модель на собственных данных.
Формат вывода#
Экспорт записывает один файл и сохраняет промежуточную модель ONNX рядом с ним:
| Файл | Содержимое |
|---|---|
yolo26n_qnn.onnx | Модель ONNX с одним узлом EPContext, в который встроен бинарный файл контекста QNN, а также названия классов, задача, размер изображения, размер пакета, шаг и аргументы экспорта в виде метаданных ONNX, которые Ultralytics считывает при загрузке модели |
yolo26n.onnx | Граф ONNX в FP32, который был квантизирован, с тем же входом в формате channels-last. Он заменяет более ранний экспорт yolo26n.onnx той же контрольной точки в этом каталоге. Для развёртывания он не нужен: YOLO() не может его запустить и завершается с ошибкой Got invalid dimensions for input: images |
Модель принимает один вход с именем images и формой (batch, height, width, 3): RGB, формат channels-last (NHWC), float32, значения в диапазоне 0–1. Это отличается от входа в формате channels-first при экспорте ONNX и соответствует формату кадров камеры и HTP. Выходные данные имеют ту же форму, что и при экспорте ONNX по умолчанию. Формы ниже указаны для контрольных точек YOLO26n с размером imgsz=640 — размером официальных мобильных моделей — и размером imgsz=224 для классификации, а также для контрольной точки Cityscapes yolo26n-sem.pt для семантической сегментации:
| Задача | imgsz | Результат |
|---|---|---|
| Обнаружение | 640 | (1, 84, 8400) |
| Сегментация | 640 | (1, 116, 8400) и (1, 32, 160, 160) |
| Семантическая | 640 | (1, 640, 640), uint8 — индекс класса для каждого пикселя |
| Глубина | 640 | (1, 1, 640, 640): карта глубины |
| Классификация | 224 | (1, 1000): вероятности классов |
| Поза | 640 | (1, 56, 8400) |
| OBB | 640 | (1, 20, 8400) |
- Необработанные выходные данные: для каждого якоря — центр рамки по x, центр по y, ширина и высота в пикселях входного изображения, затем оценки классов и значения задачи (32 коэффициента маски, 17 x 3 значения ключевых точек или угол OBB в радианах). Применяй NMS самостоятельно. Формат данных для каждой задачи см. в описании формата выходных данных ONNX. Выходные данные без NMS или со встроенным NMS не поддерживаются:
nms=Falseвыводит в журналThis export format does not support end2end models, disabling the end2end branch., аnms=True—format=qnn does not support embedded NMS; using nms=None.; оба записывают эти необработанные выходные данные. - Семантическая сегментация: на выходе индекс класса каждого пикселя в виде
uint8(int32для моделей с числом классов больше 256); вычисление выполняется на NPU, а не выдаёт оценку для каждого класса. - Сегментация: второй выход содержит прототипы масок.
- Та же структура, что и у ONNX: для одного изображения на задачу все выходные данные моделей QNN имели ту же форму и тип, что и выходные данные экспорта ONNX в FP32 той же контрольной точки. Первый выход детекции, сегментации, оценки позы и OBB имел корреляцию 0,999 или выше, а прототипы масок сегментации — 0,95. Необработанные выходные данные сильнее отличались у классификации (корреляция 0,76), семантической сегментации (совпали 69% пикселей) и оценки глубины (корреляция 0,24). При работе с небольшими стандартными наборами данных в
valсильнее всего просела оценка глубины; см. калибровку.
YOLO("yolo26n_qnn.onnx") считывает структуру из метаданных ONNX, поэтому эти сведения нужны только при запуске модели в собственном коде. Ключи метаданных включают names, task, imgsz, stride, batch, end2end, args и, для моделей оценки позы, kpt_shape.
Запуск с ONNX Runtime#
Чтобы запускать модель вне пакета Ultralytics, зарегистрируй QNN Execution Provider из onnxruntime-qnn в ONNX Runtime и укажи путь к библиотеке его HTP-бэкенда. Требуется onnxruntime-qnn версии 2.x, в котором есть модуль onnxruntime_qnn. Этот вариант проверен на хосте экспорта x86-64, но не на устройстве Snapdragon:
# # Сначала экспортируй: yolo export model=yolo26n.pt format=qnn name=81 imgsz=640
import ast

import numpy as np
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]
options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)

image = np.zeros((1, 640, 640, 3), dtype=np.float32)  # # изображение с дополнением до нужного соотношения сторон: RGB, NHWC, 0-1
output = session.run(None, {session.get_inputs()[0].name: image})[0]
assert output.shape == (1, 84, 8400), "export a detection model at imgsz=640"

names = ast.literal_eval(session.get_modelmeta().custom_metadata_map["names"]) # {0: 'person', 1: 'bicycle', ...}Разверни#
На ноутбуке Windows on Snapdragon или плате Linux ARM64, BSP которой предоставляет среду выполнения HTP (см. платы Qualcomm с Linux), установи пакет с pip install ultralytics onnxruntime-qnn и скопируй на устройство yolo26n_qnn.onnx. Затем YOLO("yolo26n_qnn.onnx") регистрирует QNN Execution Provider и запускает бинарный файл контекста с HTP-бэкендом. Экспорты для этой страницы, созданные с onnxruntime-qnn 2.8.0, не запускались на устройствах Snapdragon; в измерениях Windows использовались более ранние экспорты v73.
- Совместимое поколение HTP: при экспорте укажи
nameпоколения HTP своего устройства. - Приложения Android: в README Flutter-плагина описана используемая им настройка для моделей
_qnn.onnx: пакетыcom.microsoft.onnxruntime1.29.0иcom.qualcomm.qti2.51.0, а такжеuseLegacyPackaging = trueвpackagingOptions.jniLibs, поскольку загрузчику Hexagon DSP нужны настоящие файлы.so. Там также указано, что экспорты, созданные до Ultralytics 8.4.188 сonnxruntime-qnnверсии 2.4 или новее, не загружаются и завершаются ошибкойInput name not found. Эта настройка не проверялась с экспортами, описанными на этой странице. - Только NPU: на устройстве Snapdragon бинарный файл контекста работает только на HTP. Для GPU Adreno или CPU экспортируй вместо него модель LiteRT или стандартную модель ONNX; в измерениях Android сравниваются LiteRT на CPU и GPU с QNN на NPU.
- Фиксированная форма входных данных: модель всегда работает с экспортными значениями
imgszиbatch, которые Ultralytics считывает из метаданных ONNX. Значениеimgsz, переданное вpredictилиval, игнорируется. Меньшие пакеты дополняются, а модельbatch=2также успешно выполняла предсказания на одном и трёх изображениях. - Одна модель QNN на процесс: загружай вторую модель QNN или запускай
valпослеpredictв новом процессе Python; см. ограничения. - Имя файла: оставляй
_qnn.onnxв конце имени файла, поскольку Ultralytics определяет по нему формат. Копия с именемyolo26n_npu.onnxзагружается как обычная модель ONNX и завершается с ошибкойEPContext node generated by 'QNNExecutionProvider' is not compatible with any execution provider added to the session.
Flutter-плагин Ultralytics#
Flutter-плагин Ultralytics YOLO запускает экспорты QNN для всех семи задач YOLO26 на Android, поддерживая обработку видео с камеры в реальном времени и предсказания по отдельным изображениям. Поддержка QNN включается по желанию: включи среду выполнения QNN и добавь зависимость ONNX Runtime, как описано в README плагина. С его помощью выполнены измерения Android на этой странице. Для iOS см. Ultralytics iOS SDK и интеграцию Core ML.
Платы Qualcomm с Linux#
На плате Dragonwing, например IQ-8275 с Qualcomm Linux или Yocto BSP, среда выполнения предоставляется BSP производителя платы с поддержкой QAIRT и не входит в экспортированную модель. Для выполнения на HTP BSP должен предоставлять ONNX Runtime QNN Execution Provider, libQnnSystem.so, libQnnHtp.so, библиотеки-заглушки и скелетные библиотеки HTP для поколения HTP платы (v75 для IQ-8275), пользовательскую поддержку FastRPC, например libcdsprpc.so, прошивку DSP и соответствующие драйверы ядра FastRPC. Скелетная библиотека должна находиться в пути к библиотекам DSP, заданном в BSP. Для выполнения на GPU вместо этого нужны libQnnGpu.so и пользовательский драйвер Adreno, а также стандартный экспорт ONNX, поскольку файлы _qnn.onnx предназначены для HTP.
Руководства по развертыванию#
- ONNX Runtime QNN Execution Provider: параметры, поддерживаемые операторы, а также пакеты провайдера для Android и Windows, который загружает файлы
_qnn.onnx. - Qualcomm AI Engine Direct SDK: справочная документация Qualcomm по QNN и QAIRT.
- Flutter-плагин Ultralytics YOLO: приложения Android с моделями QNN, LiteRT и Core ML.
- LiteRT и MediaTek Dimensity: развёртывание на Android с использованием CPU и GPU, а также NPU MediaTek.
- Варианты развёртывания моделей: сравнение QNN с другими форматами экспорта.
Ограничения и устранение неполадок#
- macOS и Python 3.10: для
onnxruntime-qnnверсии 2.x пакеты доступны только для Python 3.11–3.14 на Linux и Windows. На macOS и Linux с Python 3.10 установкаonnxruntime-qnnзавершается с ошибкой (pip сообщаетNo matching distribution found for onnxruntime-qnn), а экспорт продолжается, квантизирует модель и затем завершается с ошибкойFailed to load library .../onnxruntime/capi/libonnxruntime_providers_qnn.so. На Windows x64 с Python 3.10 pip вместо этого устанавливает более раннюю версиюonnxruntime-qnn1.23.2, которая не проверялась. Выполняй экспорт на Linux или Windows с Python 3.11 или новее либо с помощью платформы Ultralytics. - Автоматическая установка отключена: если указан
YOLO_AUTOINSTALL=false, но не указанonnxruntime-qnn, экспорт выводит в журналUltralytics requirement ['onnxruntime-qnn'] not found, AutoUpdate disabled by YOLO_AUTOINSTALL=Falseи завершается с той же ошибкойFailed to load library. Установи его, как описано в кратком руководстве. - Выходной файл уже существует: экспорт записывает
yolo26n_qnn.onnxрядом с файлом.pt, а ONNX Runtime не перезаписывает его. Если файл существует, экспорт завершается с ошибкойFailed to generate EP context model since the file '"yolo26n_qnn.onnx"' exists already. Please remove the EP context model if you want to re-generate it., после чего процесс Python может закончиться с ошибкой сегментации. Перед повторным экспортом удали прежний файл или переименуй его — даже если используешь другое значениеname,imgszилиdata. - Вторая модель QNN в одном процессе: загрузка второй модели
_qnn.onnxили запускvalлибо экспорта послеpredictс моделью QNN завершается с ошибкойEP library is already registered under QNNExecutionProvider. Несколько предсказаний подряд с одним объектомYOLOработают; также работаетpredictсразу после экспорта. Используй отдельный процесс Python для каждой модели, как это делает CLIyolo. - Фиксированная входная форма:
dynamic=Trueзавершается с ошибкойargument 'dynamic' is not supported for format='qnn'. Повтори экспорт, чтобы изменить размер изображения или размер пакета. - Калибровка без
data: экспорт выводит в журналINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.и калибрует модель на небольшом стандартном наборе данных для задачи. Передайdataс изображениями, соответствующими данным для развёртывания. - Предупреждение об opset: если не передать
opset=21, квантизатор ONNX Runtime выводит в журналThe original model opset version is 18, which does not support 16-bit integer quantization natively. Please update the model to opset >= 21. Automatically update the model to opset 21. Please verify the quantized model., подставляя opset твоего экспорта вместо 18, и повышает версию opset графа до 21. Экспорт продолжается; никаких действий не требуется. - Контрольные точки, обученные с
quantize=8: контрольная точка, дообученная с помощью обучения с учётом квантования, завершается с ошибкойformat='qnn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. Вместо неё экспортируй контрольную точку, с которой начиналось дообучение. - Инференс на хосте экспорта: в Linux x86-64
onnxruntime-qnnзапускал бинарные файлы контекстаname=73иname=81на CPU. Для YOLO26n на загруженном серверном CPU обработка одного изображения занимала около 0,3 с (классификация) — 16 с (оценка глубины), тогда как на телефоне это занимает миллисекунды. Используй этот запуск для проверки экспорта, а не для измерения скорости.
Другие ошибки описаны в руководстве по распространённым проблемам.
Измеренная производительность#
В таблицах ниже указана задержка обработки одного изображения на двух устройствах Snapdragon. Измерения сделаны на опубликованных моделях v0.7.0 для HTP v81 (Android) и на более ранних экспортах HTP v73 (Windows); также приведён размер экспортов, созданных для этой страницы на сервере Linux x86-64. В каждой ячейке задержки указано общее время в миллисекундах, а ниже — разбивка на предобработку / инференс / постобработку; самый быстрый столбец для каждой модели выделен полужирным. Точность контрольных точек PyTorch указана на странице модели YOLO26.
Телефон Android#
Оборудование: Xiaomi 17 с 12 ГБ памяти LPDDR5X и Android 17 / API 37. В его 3-нм Snapdragon 8 Elite Gen 5 (SM8850) установлены 8-ядерный CPU Qualcomm Oryon (2 производительных ядра с частотой до 4,6 ГГц и 6 ядер Performance с частотой до 3,62 ГГц), GPU Adreno и NPU Hexagon (HTP v81).
| Модель | Задача | размер (пиксели) | CPU w8a32 LiteRT (мс) | GPU w8a32 LiteRT (мс) | NPU QNN W8A16 (мс) |
|---|---|---|---|---|---|
| YOLO26n | Обнаружение | 640 | 36.9 1.9 / 32.6 / 2.3 | 10.6 1.8 / 6.2 / 2.6 | 10.2 1.9 / 6.0 / 2.3 |
| YOLO26n-seg | Сегментация | 640 | 50.5 1.9 / 42.9 / 5.8 | 18.0 1.9 / 9.5 / 6.6 | 16.2 2.1 / 8.4 / 5.7 |
| YOLO26n-sem | Семантическая | 640 | 45.7 1.9 / 35.7 / 8.2 | 30.6 1.9 / 20.5 / 8.3 | 10.8 2.0 / 6.2 / 2.6 |
| YOLO26n-depth | Глубина | 640 | 66.8 2.2 / 55.0 / 9.7 | 21.9 2.1 / 10.1 / 9.8 | 19.3 2.2 / 7.4 / 9.7 |
| YOLO26n-cls | Классификация | 224 | 3.6 0.3 / 3.3 / 0.0 | 2.0 0.4 / 1.4 / 0.2 | 0.8 0.3 / 0.5 / 0.0 |
| YOLO26n-pose | Поза | 640 | 39.9 2.0 / 36.5 / 1.4 | 10.0 1.8 / 6.7 / 1.4 | 9.7 1.9 / 5.9 / 1.8 |
| YOLO26n-obb | OBB | 640 | 36.3 2.0 / 33.2 / 1.2 | 10.1 2.6 / 5.9 / 1.6 | 8.1 1.9 / 5.1 / 1.0 |
- Значения скорости — это задержки пакетного выполнения для одного изображения: среднее значение по 15 запускам после 3 прогревочных запусков на
bus.jpg, измеренное с помощью0.7.1— встроенного в устройство тестового модуля Flutter-плагина — и официальных ресурсовv0.7.0(экспорты Ultralytics 8.4.188). Бэкенды для разных задач проверялись по очереди, в меняющемся порядке. Собственные журналы устройства подтвердили, что во всех строках CPU использовались LiteRT CPU/XNNPACK, во всех строках GPU весь граф обрабатывался LiteRT OpenCL (LITERT_CL), а во всех строках NPU — бэкенд QNN Hexagon HTP. - В столбцах CPU и GPU представлены модели
w8a32LiteRT того же выпуска, поэтому таблица сравнивает NPU с другими процессорами того же телефона. - Подробная запись результатов тестирования приведена в документе о производительности Flutter.
- Сравни показатели на других устройствах Android в разделе интеграции LiteRT, включая руководство по MediaTek Dimensity, а на устройствах Apple — в разделе интеграции Core ML.
Ноутбук Windows on Snapdragon#
Оборудование: ноутбук Lenovo с 32 ГБ памяти и Windows 11. В Snapdragon X Elite (X1E78100) установлены 12-ядерный CPU Qualcomm Oryon, GPU Adreno и NPU Hexagon (HTP v73). Точная модель Lenovo не зафиксирована.
В этом более раннем цикле измерений сравниваются базовая производительность PyTorch FP32 на CPU и модели QNN на NPU Hexagon. Измерения проводились с ultralytics 8.4.67, onnxruntime-qnn 2.2.0, torch 2.10.0+cpu и Python 3.12.10 на моделях v73, экспортированных до того, как стандартными стали мобильные размеры 224/640. Поэтому модели семантической сегментации и OBB работали с размером 1024 пикселя, а строки для оценки глубины нет. В каждой ячейке указано полное время model.predict() по настенным часам, а ниже — представленная разбивка на предобработку / инференс / постобработку; общее время может включать накладные расходы фреймворка помимо этих трёх этапов.
| Модель | Задача | размер (пиксели) | CPU PT FP32 (мс) | NPU Hexagon QNN W8A16 (мс) |
|---|---|---|---|---|
| YOLO26n | Обнаружение | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Сегментация | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Семантическая | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Классификация | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Поза | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Значения скорости — это задержки пакетного выполнения для одного изображения: среднее значение по 100 запускам после 10 прогревочных запусков на
bus.jpg, измеренное с помощьюtime.perf_counter()вокруг полного вызоваmodel.predict()на устройстве, остывшем до рабочей температуры. - NPU Hexagon работал в 2,2–4,1 раза быстрее базовой версии PyTorch на CPU при размерах 640 и 1024 пикселя и в 1,3 раза быстрее для классификатора с размером 224 пикселя, где фиксированное время предобработки имеет больший вес.
Размер модели#
Размер моделей детекции YOLO26 в МБ (10^6 байт): для контрольной точки PyTorch и для файла _qnn.onnx для HTP v81 с размером imgsz=640. В журнале экспорта размер выводится в МиБ, например (3.5 MB) для YOLO26n v81:
| Модель | PyTorch | QNN v81 |
|---|---|---|
| YOLO26n | 5.5 | 3.6 |
| YOLO26s | 20.4 | 11.1 |
| YOLO26m | 44.3 | 22.8 |
| YOLO26l | 53.2 | 27.9 |
| YOLO26x | 118.7 | 60.6 |
Экспорт выполнен с ultralytics 8.4.215, onnxruntime-qnn 2.8.0 и onnxruntime 1.32.0 на сервере Linux x86-64 без оборудования Snapdragon. В разделе калибровки приведена точность экспорта YOLO26n на COCO.
О Qualcomm QNN#
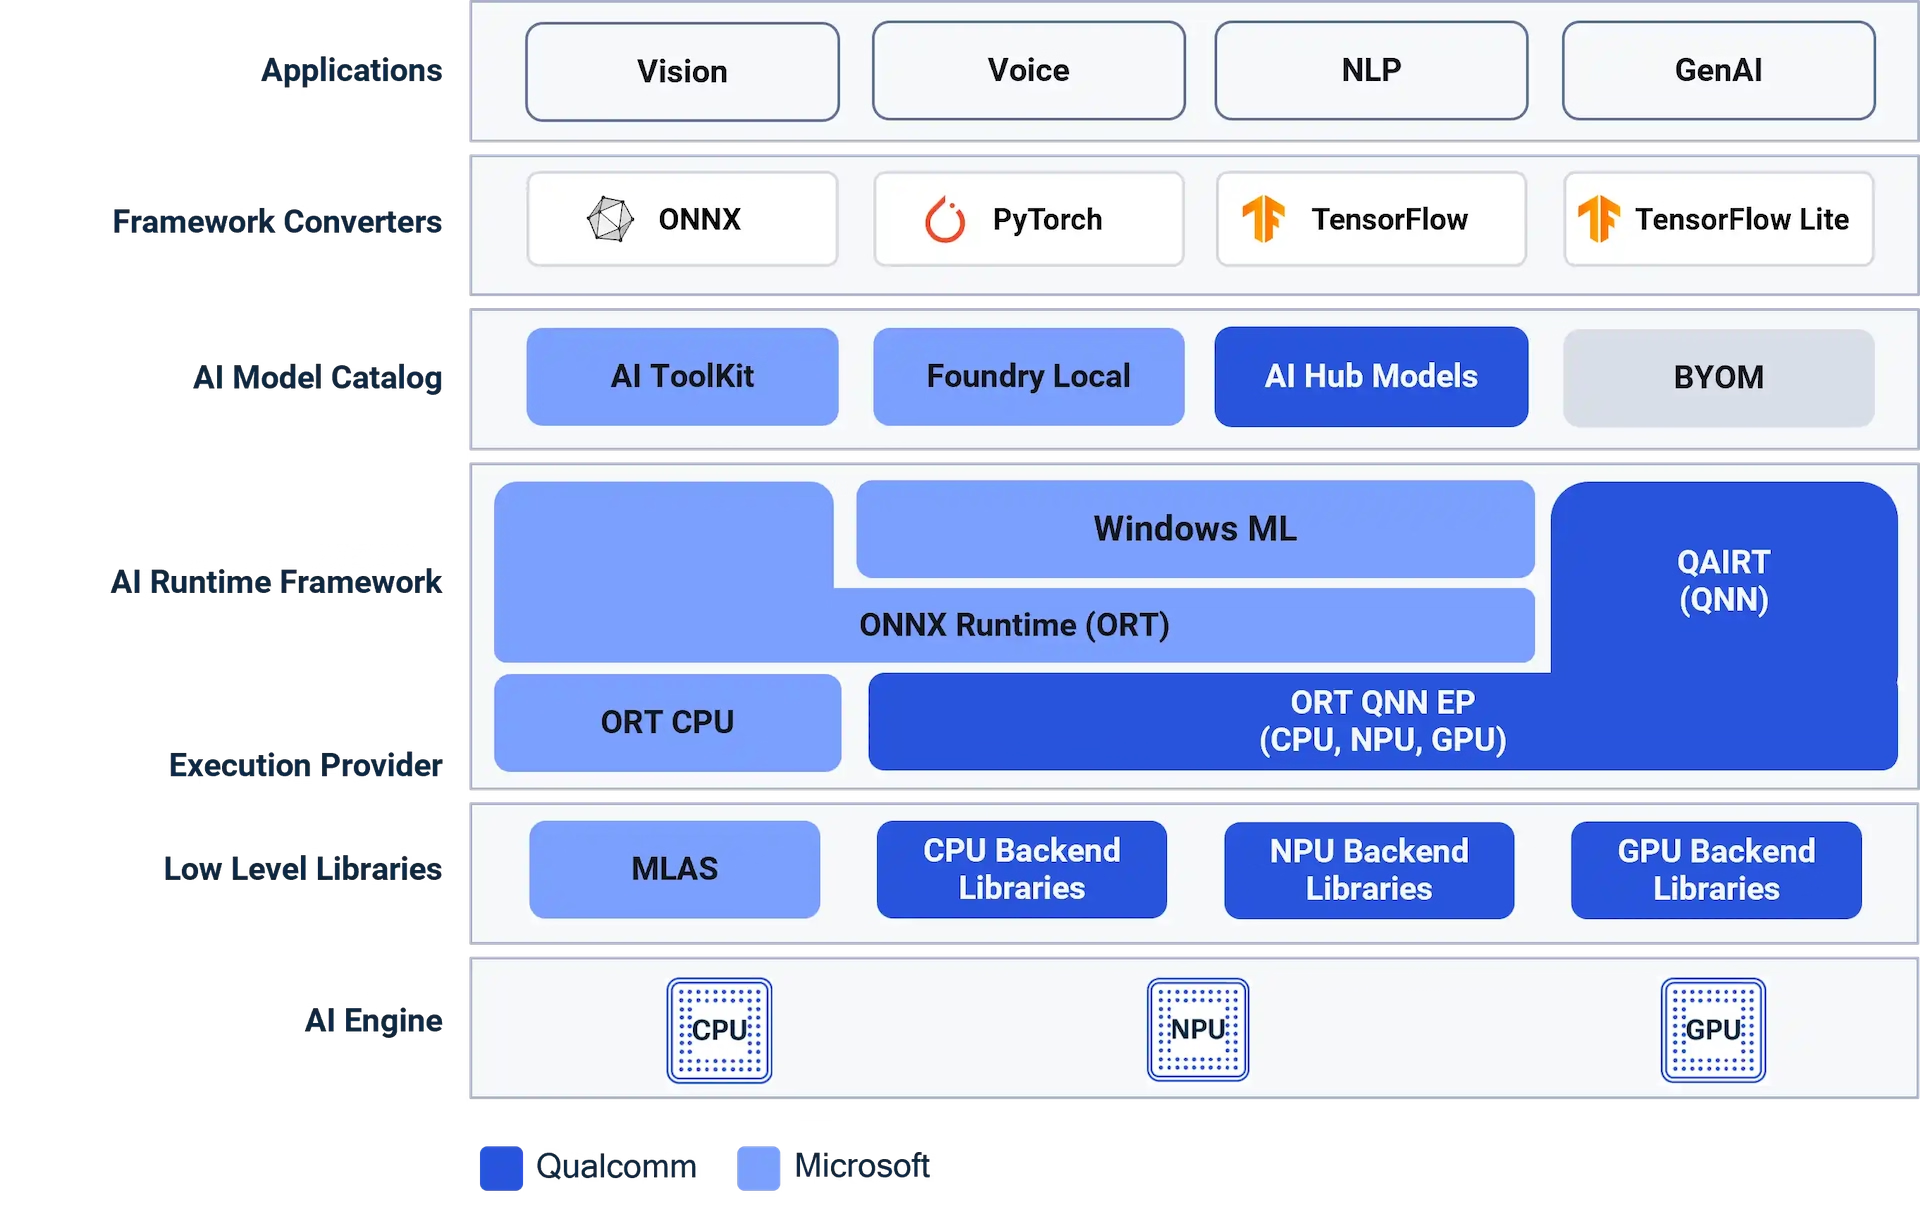
Qualcomm AI Engine Direct (QNN) входит в состав SDK Qualcomm AI Runtime (QAIRT) и позволяет запускать нейронные сети на CPU, GPU Adreno и NPU Hexagon в процессорах Snapdragon и Dragonwing через единый API с отдельной библиотекой-бэкендом для каждого процессора. Он заменяет более ранний SDK Snapdragon Neural Processing Engine (SNPE). Ultralytics использует его бэкенд HTP через ONNX Runtime QNN Execution Provider. Полную справочную документацию см. в Qualcomm AI Engine Direct SDK.
Часто задаваемые вопросы#
Нет. Экспорт выполняется с пакетом
onnxruntime-qnnиз PyPI, который включает библиотеки QAIRT. Все экспорты для этой страницы выполнялись на сервере Linux x86-64 без учётной записи Qualcomm, загрузки SDK или оборудования Snapdragon. Устройство нужно только для запуска модели на скорости NPU.Qualcomm AI Hub — облачный сервис Qualcomm для компиляции, профилирования и тестирования производительности моделей на устройствах Snapdragon, размещённых в облаке; для него нужна учётная запись Qualcomm. Экспорт Ultralytics компилирует бинарный файл контекста QNN для того же NPU Hexagon на твоём компьютере с помощью одного вызова
export(format="qnn")— без учётной записи и загрузки данных. Скорость работы ты измеряешь на своём устройстве.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.