部署后维护计算机视觉模型
监控和维护计算机视觉模型,意味着持续跟踪模型预测,检查是否存在数据漂移和准确率下降;在性能退化时使用新数据重新训练;并记录每项更改,确保工作可复现。这是计算机视觉项目的最后阶段——在你收集需求、标注数据、训练模型并将其部署之后——也是确保模型投入生产运行后仍能满足项目目标的关键。
观看: 部署后如何维护计算机视觉模型 | 数据漂移检测
本指南将进一步介绍如何在部署后维护计算机视觉模型。我们将探讨模型监控如何帮助你及早发现问题、如何保持模型的准确性和时效性,以及文档为何对故障排查至关重要。
模型监控#
密切关注已部署的计算机视觉模型至关重要。如果没有适当的监控,模型的准确率可能会下降。一个常见问题是数据分布偏移或数据漂移,即模型遇到的数据与训练数据有所不同。当模型需要对无法识别的数据进行预测时,就可能产生误判并导致性能不佳。异常值或不寻常的数据点也会影响模型的准确率。
定期监控模型有助于开发者跟踪模型性能、发现异常,并迅速处理数据漂移等问题。监控还可以指示何时需要更新,从而帮助管理资源、避免昂贵的大规模改造,并让模型保持适用性。
模型监控最佳实践#
以下是在生产环境中监控计算机视觉模型时值得牢记的最佳实践:
- 定期跟踪性能:持续监控模型性能,检测其随时间发生的变化。
- 仔细检查数据质量:检查数据中是否存在缺失值或异常情况。
- 使用多样化的数据源:监控来自不同来源的数据,以全面了解模型性能。
- 结合多种监控技术:结合使用漂移检测算法和基于规则的方法,以识别各种问题。
- 监控输入和输出:密切关注模型处理的数据和生成的结果,确保一切运行正常。
- 设置告警:针对性能下降等异常行为设置告警,以便及时采取纠正措施。
使用 Ultralytics Platform 进行监控#
Ultralytics Platform为已部署的 YOLO 端点提供内置的模型监控,因此你无需搭建独立的监控技术栈,就能监控生产环境中的模型。部署仪表板会实时跟踪关键指标:
- 请求指标:每个端点的请求总量、错误率和 P95 延迟;仪表板提供 24 小时迷你趋势图,指标 API 支持查询 1 小时至 30 天范围的数据。
- 运行状况检查:端点运行状况检查会标记不健康的部署并报告响应延迟。
- 日志:按严重级别筛选请求日志(从 DEBUG 到 CRITICAL),用于诊断请求失败和延迟骤增问题。
- 全局视图:交互式世界地图和概览卡片可在单一视图中汇总各区域的所有部署。
由于监控通过标准端点 URL 和 /health 检查提供,你也可以在需要进行深入分析时,将这些信号整合到现有的可观测性配置中。有关设置详情,请参阅部署监控指南。
异常检测和告警系统#
异常是指任何明显偏离预期的数据点或模式。对于计算机视觉模型,异常可能是与模型训练图像差异很大的图像。这些意外图像可能表明存在数据分布变化、异常值或会降低模型性能的行为等问题。设置警报系统来检测这些异常,是模型监控的重要组成部分。
通过为关键指标设定标准性能水平和限值,你可以及早发现问题。当性能超出这些限值时,系统会触发告警,提醒你迅速修复问题。定期使用新数据更新和重新训练模型,可以在数据变化时让模型保持适用性和准确性。
配置阈值和告警#
设置告警系统时,请牢记以下最佳实践:
- 标准化告警:对所有告警使用一致的工具和格式,例如电子邮件或 Slack 等消息应用。标准化有助于你快速理解并响应告警。
- 说明预期行为:告警消息应清楚说明出了什么问题、原本预期是什么,以及评估的时间范围。这有助于你判断告警的紧急程度和背景。
- 可配置的告警:让告警易于配置,以适应不断变化的情况。允许你修改阈值、暂缓、禁用或确认告警。
数据漂移检测#
数据漂移检测用于识别输入数据的统计特征是否随时间发生变化,这种变化可能会降低模型性能。在决定重新训练或调整模型之前,这项技术可以帮助你发现问题。数据漂移关注数据整体分布随时间的变化,而异常检测侧重识别可能需要立即处理的罕见或意外数据点。
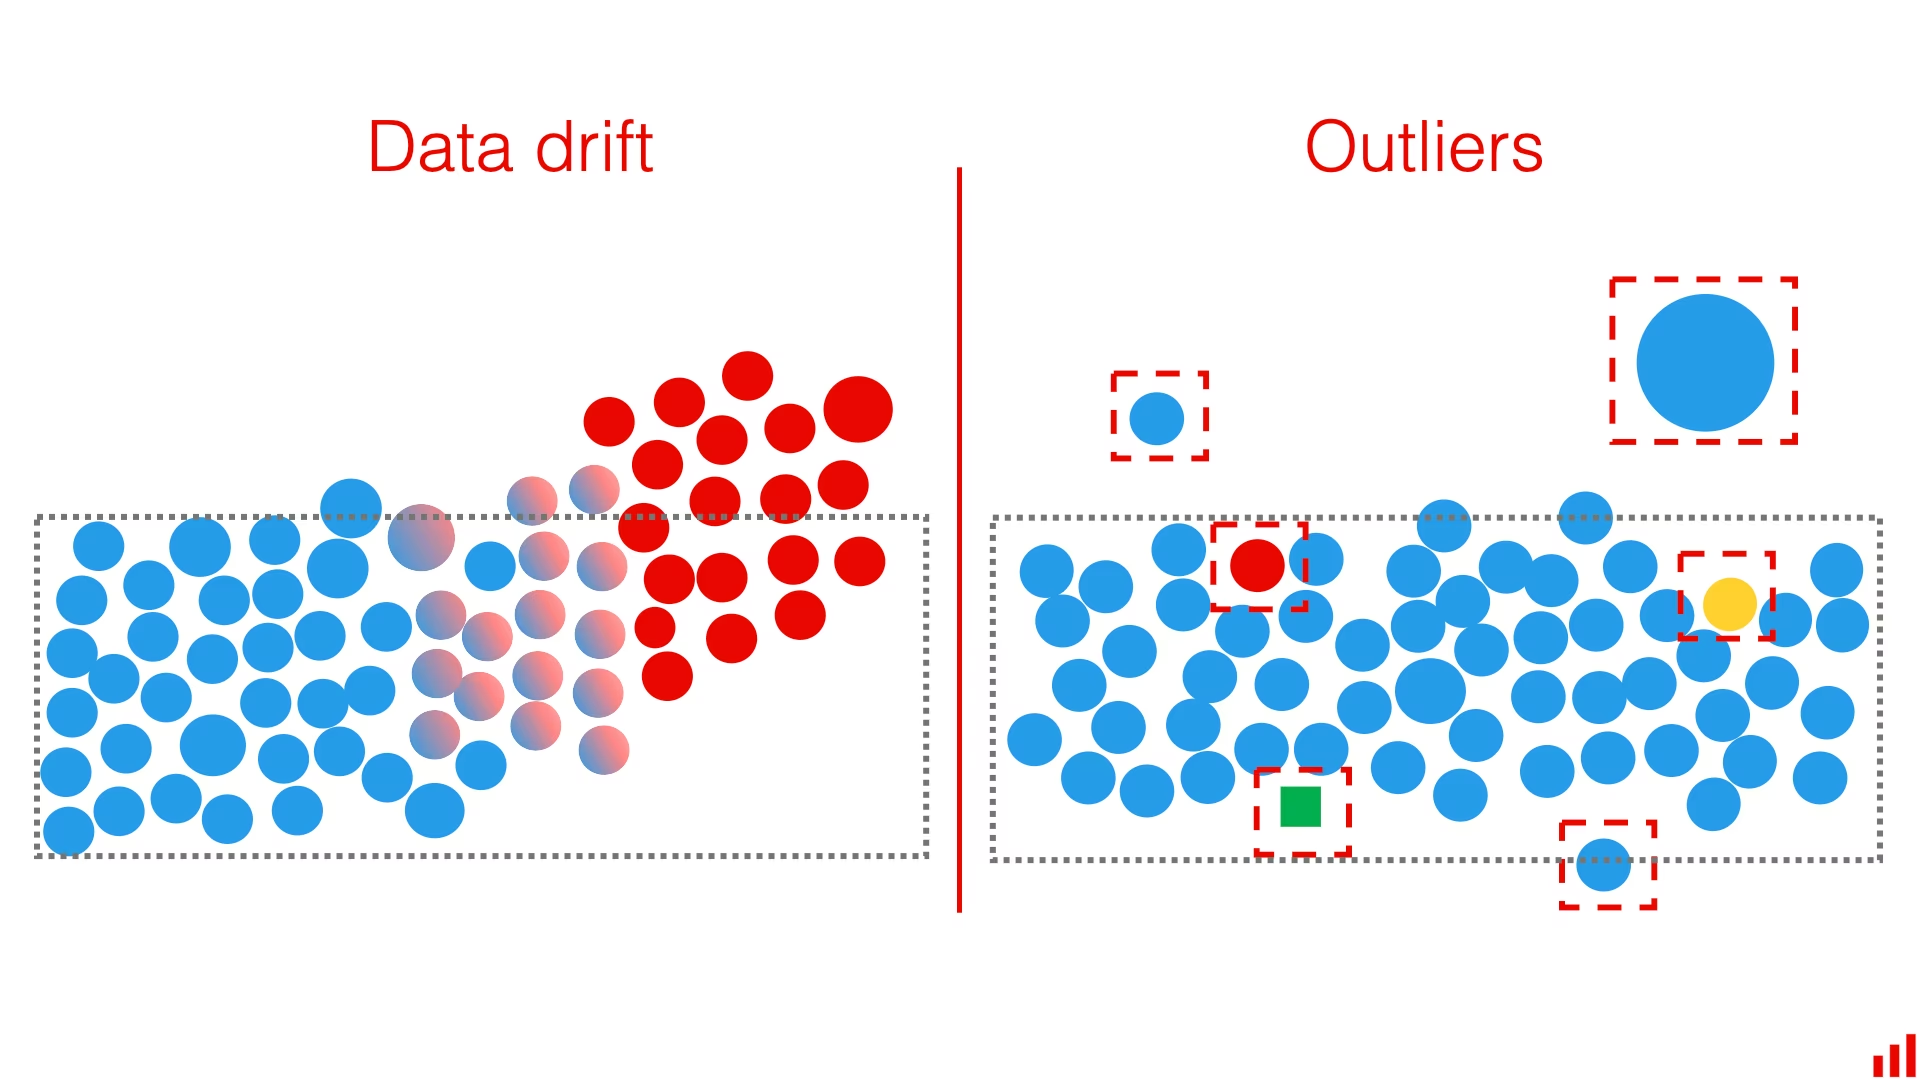
以下是几种检测数据漂移的方法:
- 持续监控:定期监控模型的输入数据和输出,查找漂移迹象。跟踪关键指标,并与历史数据进行比较,以识别显著变化。
- 统计方法:使用 Kolmogorov-Smirnov 检验或总体稳定性指数(PSI)等方法,检测数据分布的变化。这些检验会比较新数据与训练数据的分布,以识别显著差异。
- 特征漂移:监控各个特征是否发生漂移。有时整体数据分布可能保持稳定,但个别特征可能发生漂移。确定哪些特征发生漂移有助于微调重新训练流程。
模型维护#
模型维护通过定期更新和重新训练模型、处理数据漂移,并适应数据和环境的变化,让计算机视觉模型长期保持准确且适用。模型维护与监控相辅相成:监控会实时观察模型性能以便及早发现问题,而维护则负责解决这些问题。
定期更新和重新训练#
模型部署后,在监控过程中,你可能会注意到数据模式或性能发生变化,这表明模型出现了漂移。定期更新和重新训练是模型维护的重要组成部分,可确保模型适应新的模式和场景。你可以根据数据变化情况采用几种不同的方法。
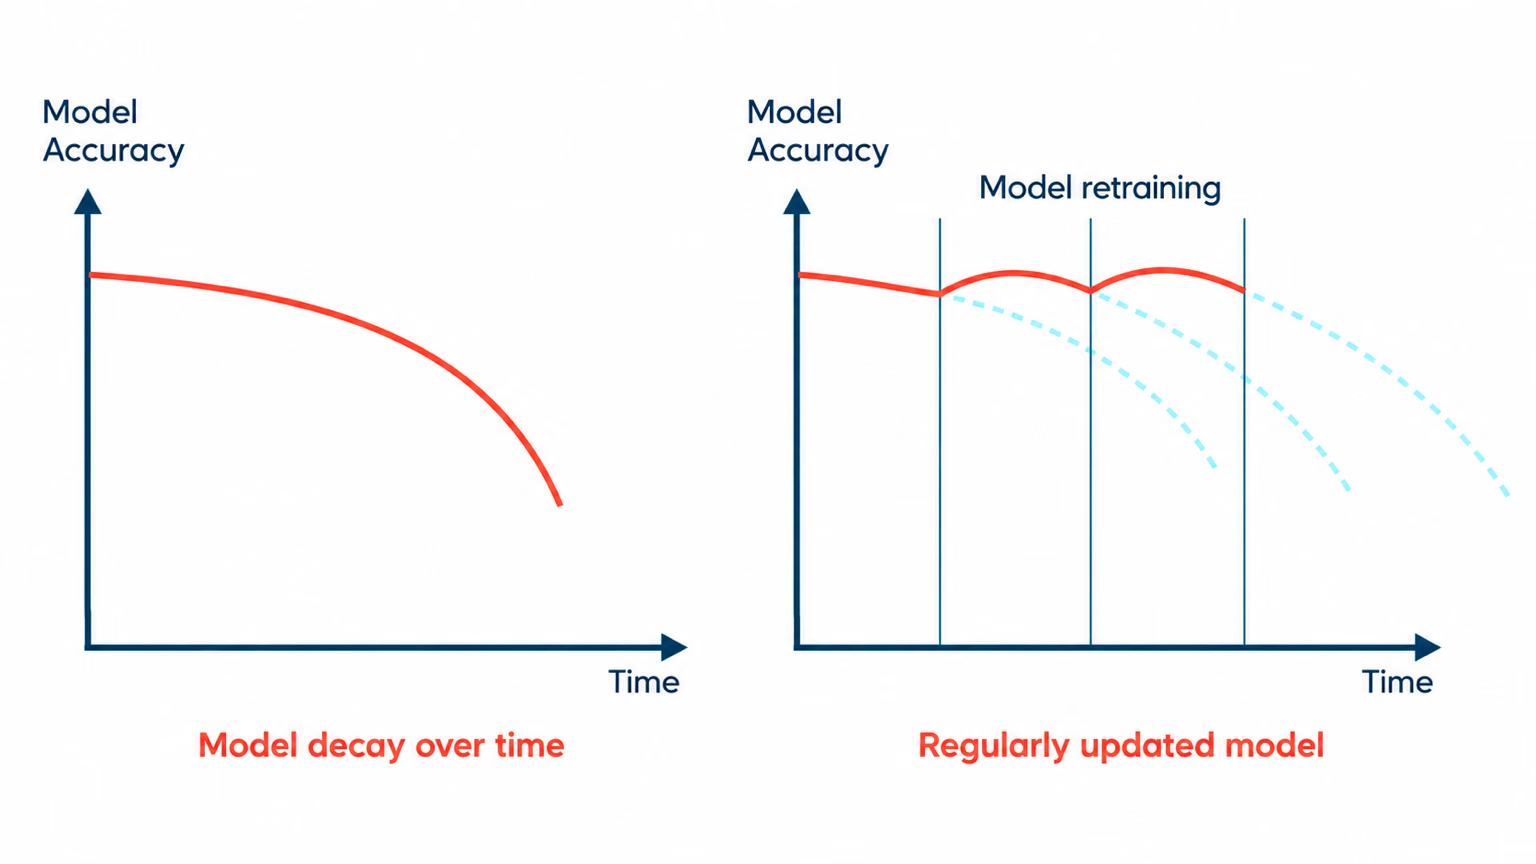
例如,如果数据随时间逐渐变化,增量学习就是一种不错的方法。增量学习会使用新数据更新模型,而无需从头开始完全重新训练,从而节省计算资源和时间。但如果数据发生了剧烈变化,定期进行完整的重新训练可能更合适,以确保模型不会在新数据上过拟合,同时又忽略旧模式。
无论采用哪种方法,更新后都必须进行验证和测试。请务必使用独立的测试数据集验证模型,以检查性能是有所提升还是下降。
确定何时重新训练模型#
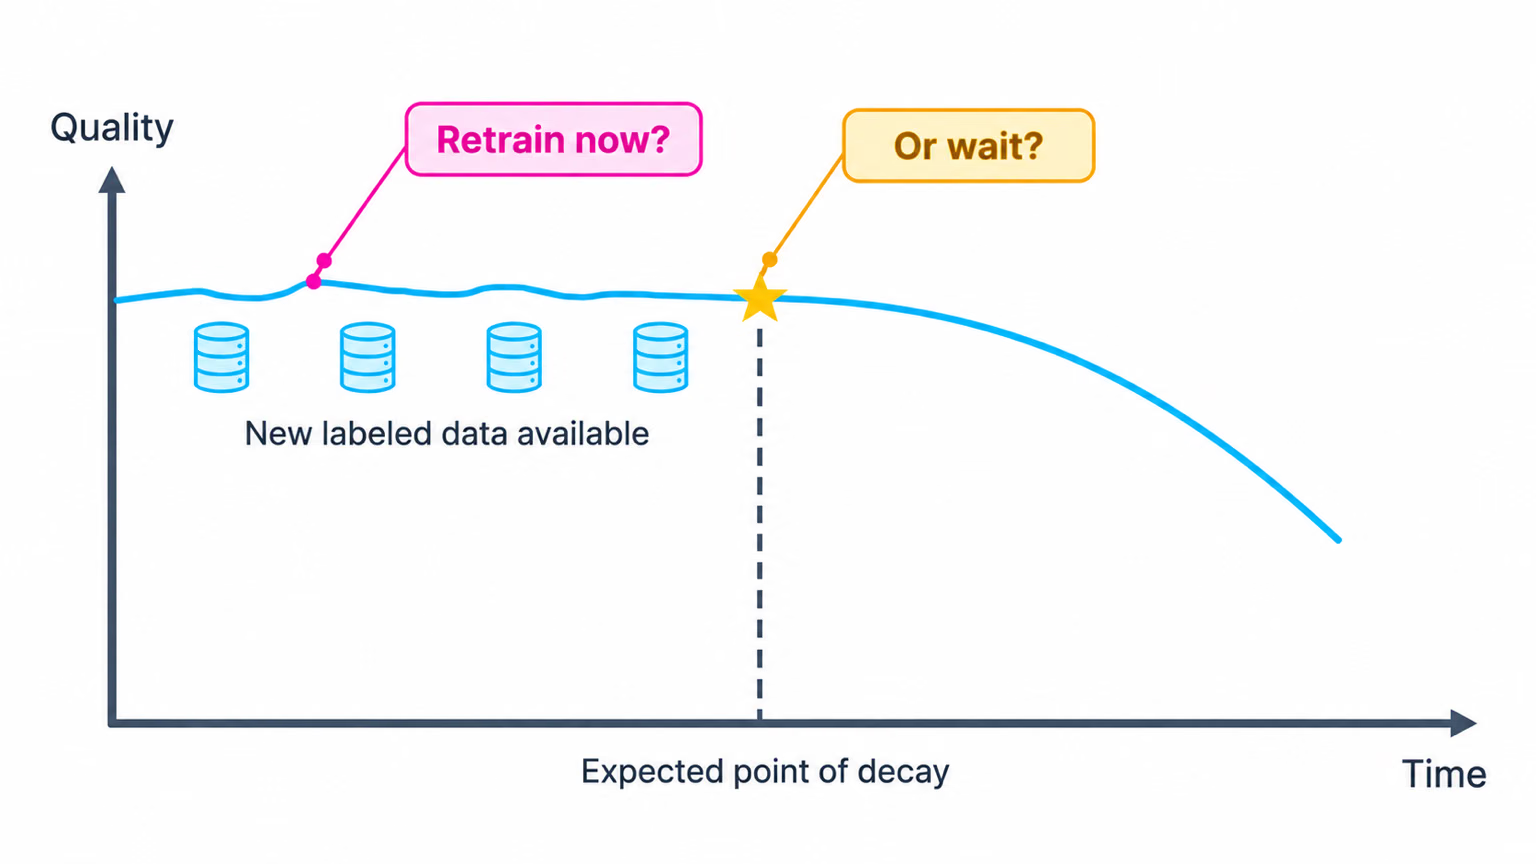
计算机视觉模型的重新训练频率取决于数据变化和模型性能。每当你发现性能显著下降或检测到数据漂移时,就应重新训练模型。定期评估模型在新数据上的表现,有助于确定合适的重新训练计划。监控性能指标和数据模式,可帮助你判断模型是否需要更频繁地更新以保持准确性。
文档#
记录计算机视觉项目有助于他人理解、复现项目并参与协作。完善的文档应涵盖模型架构、超参数、数据集、评估指标等内容。文档能够提高透明度,帮助团队成员和利益相关者了解已完成的工作及其原因。通过清晰记录过去的决策和方法,文档还有助于故障排除、维护和后续改进。
需要记录的关键要素#
以下是项目文档中应包含的一些关键要素:
- 项目概述:提供项目的高层概述,包括问题陈述、解决方案、预期成果和项目范围。说明计算机视觉在解决问题中的作用,并概述各个阶段及其交付成果。
- 模型架构:详细说明模型的结构和设计,包括其组件、层和连接方式。解释所选超参数,以及选择这些参数的理由。
- 数据准备:描述数据来源、类型、格式、大小和预处理步骤。讨论数据质量和可靠性,以及训练模型前应用的任何转换。
- 训练流程:记录训练流程,包括使用的数据集、训练参数和损失函数。说明模型的训练方式,以及训练期间遇到的任何挑战。
- 评估指标:说明用于评估模型性能的指标,例如准确率、精确率、召回率和F1 分数。提供性能结果并分析这些指标。
- 部署步骤:概述部署模型所采取的步骤,包括使用的工具和平台、部署配置,以及任何特定挑战或注意事项。
- 监控和维护流程:提供模型部署后的性能监控详细计划。说明检测和处理数据漂移与模型漂移的方法,并描述定期更新和重新训练的流程。
结论#
监控、维护和记录模型,才能让计算机视觉项目在部署后长期保持成功:持续监控有助于及早发现问题,定期重新训练可让模型适应新数据和数据漂移,而清晰的文档能让今后的每次更新都更轻松。将其视为一个持续循环,并随着数据和需求的变化,重新审视计算机视觉项目的各个阶段。
常见问题#
要监控已部署的计算机视觉模型,请在生产环境中跟踪请求量、错误率和延迟,同时留意可能预示准确率下降的异常和数据漂移。Ultralytics Platform 的 Deploy 仪表板开箱即用地提供生产指标监控功能,包括实时指标、自动健康检查和按严重程度筛选的日志。定期监控输入和输出,为异常行为设置提醒,并使用多种数据来源,全面了解模型性能。更多详情请参阅模型监控部分。
维护计算机视觉模型需要定期更新、重新训练和监控,以确保模型持续保持准确性和相关性。最佳实践包括:
- 持续监控:定期跟踪性能指标和数据质量。
- 数据漂移检测:使用统计技术识别数据分布的变化。
- 定期更新和重新训练:根据数据变化实施增量学习或定期完整重新训练。
- 文档:详细记录模型架构、训练流程和评估指标。更多信息请访问我们的模型维护部分。
数据漂移检测至关重要,因为它有助于识别输入数据的统计属性何时随时间发生变化,而这可能会降低模型性能。持续监控、统计检验(例如 Kolmogorov-Smirnov 检验)和特征漂移分析等技术有助于及早发现问题。处理数据漂移可确保模型在不断变化的环境中保持准确且适用。请在我们的数据漂移检测部分了解更多信息。
要检测计算机视觉模型中的异常,请为关键指标设定标准性能范围,并在数值超出范围时触发提醒。Ultralytics Platform 通过实时错误率和延迟指标、自动健康检查以及按严重程度筛选的日志提供支持,帮助你快速发现异常行为。可配置的提醒和标准化消息有助于你快速响应潜在问题。请参阅我们的异常检测和提醒系统部分,了解更多信息。


评论4
提出问题、分享结果,或帮助其他人。
SunyuKy
Hello, I am training my own dataset using yolov11. My dataset usually only contains one small target, so a large part of the image is background, which makes it easy for the model to recognize the target class as the background class. How can I modify the configuration file to improve the model performance? Will adjusting the loss gain of box and cls work?
 Glenn JocherUltralytics
@SunyuKy to improve model performance on a dataset with a small target and large background, consider adjusting the
boxandclsloss gains in the configuration file. This can help the model focus more on the target class. Additionally, experimenting with data augmentation techniques might enhance detection accuracy. For more detailed guidance, you can refer to our documentation on model monitoring and maintenance.Thank you for your reply!I would like to know in which direction the loss gain of the bounding box and classification should be adjusted. I guess I should increase the loss gain of the classification. So, should the loss gain of the bounding box be increased or decreased?
- Glenn JocherUltralytics(已编辑)
To improve performance, try increasing the classification loss gain (
cls) to emphasize the target class. For the bounding box loss (box), you might experiment with both increasing and decreasing it and compare validation results.