Bonnes pratiques pour le déploiement de modèles
Introduction#
Le déploiement de modèles est l’étape d’un projet de vision par ordinateur qui fait passer un modèle de la phase de développement à une application réelle. Il existe plusieurs options de déploiement de modèles : le déploiement dans le cloud offre une grande évolutivité et un accès facile, le déploiement en périphérie réduit la latence en rapprochant le modèle de la source des données, et le déploiement local assure la confidentialité et le contrôle. Le choix de la bonne stratégie dépend des besoins de ton application et doit équilibrer vitesse, sécurité et évolutivité.
À regarder : Comment optimiser et déployer des modèles d’IA : bonnes pratiques, dépannage et considérations de sécurité
Il est également important de suivre les bonnes pratiques lors du déploiement d’un modèle, car le déploiement peut avoir une incidence importante sur l’efficacité et la fiabilité des performances du modèle. Dans ce guide, nous allons voir comment faire en sorte que le déploiement de ton modèle soit fluide, efficace et sécurisé.
Options de déploiement des modèles#
Souvent, après avoir été entraîné, évalué et testé, un modèle doit être converti dans des formats spécifiques pour être déployé efficacement dans divers environnements, comme le cloud, la périphérie ou des appareils locaux.
Avec YOLO26, tu peux exporter ton modèle dans différents formats selon tes besoins de déploiement. Par exemple, l’exportation de YOLO26 vers ONNX est simple et idéale pour transférer des modèles entre différents frameworks. Pour découvrir d’autres options d’intégration et assurer un déploiement fluide dans différents environnements, consulte notre catalogue d’intégration des modèles.
Choisir un environnement de déploiement#
Le choix de l’environnement dans lequel déployer ton modèle de vision par ordinateur dépend de plusieurs facteurs. Chaque environnement présente des avantages et des défis qui lui sont propres ; il est donc essentiel de choisir celui qui répond le mieux à tes besoins.
Déploiement dans le cloud#
Le déploiement dans le cloud convient parfaitement aux applications qui doivent évoluer rapidement et traiter de grandes quantités de données. Des plateformes comme AWS, Google Cloud et Azure facilitent la gestion de tes modèles, de l’entraînement au déploiement. Elles proposent des services comme Amazon SageMaker, Google Vertex AI et Azure Machine Learning pour t’accompagner tout au long du processus. Ultralytics Platform déploie également des modèles YOLO sur des points de terminaison dédiés dans 42 régions du monde.
Cependant, le cloud peut coûter cher, surtout lorsque le volume de données est élevé, et tu risques de rencontrer des problèmes de latence si tes utilisateurs se trouvent loin des centres de données. Pour maîtriser les coûts et les performances, il est important d’optimiser l’utilisation des ressources et de respecter les règles de protection des données.
Déploiement en périphérie#
Le déploiement en périphérie convient aux applications qui nécessitent des réponses en temps réel et une faible latence, notamment dans les zones où l’accès à Internet est limité ou inexistant. Le déploiement de modèles sur des appareils en périphérie, comme des smartphones ou des appareils IoT, garantit un traitement rapide et conserve les données en local, ce qui améliore la confidentialité. Le déploiement en périphérie permet aussi d’économiser de la bande passante en réduisant la quantité de données envoyées vers le cloud.
Cependant, les appareils en périphérie ont souvent une puissance de traitement limitée ; tu devras donc optimiser tes modèles. Les environnements d’exécution et les plateformes matérielles comme LiteRT et NVIDIA Jetson peuvent t’aider. Malgré ses avantages, la maintenance et la mise à jour d’un grand nombre d’appareils peuvent être difficiles.
Déploiement local#
Le déploiement local est préférable lorsque la confidentialité des données est essentielle ou que l’accès à Internet est peu fiable ou inexistant. L’exécution des modèles sur des serveurs ou des ordinateurs de bureau locaux te donne un contrôle total et protège tes données. Elle peut aussi réduire la latence si le serveur se trouve à proximité de l’utilisateur.
Cependant, la mise à l’échelle locale peut être difficile et la maintenance peut prendre beaucoup de temps. Des outils comme Docker pour la conteneurisation et Kubernetes pour la gestion peuvent rendre les déploiements locaux plus efficaces. Des mises à jour et une maintenance régulières sont nécessaires pour que tout fonctionne correctement.
Conteneurisation pour simplifier le déploiement#
La conteneurisation regroupe ton modèle et toutes ses dépendances dans une unité standardisée appelée conteneur. Cette technique garantit des performances cohérentes dans différents environnements et simplifie le processus de déploiement.
Avantages de Docker pour le déploiement de modèles#
Docker est devenu la norme du secteur pour la conteneurisation dans les déploiements d’apprentissage automatique, et ce pour plusieurs raisons :
- Cohérence de l’environnement : les conteneurs Docker encapsulent ton modèle et toutes ses dépendances, éliminant le problème du « ça fonctionne sur ma machine » en garantissant un comportement cohérent dans les environnements de développement, de test et de production.
- Isolation : les conteneurs isolent les applications les unes des autres, évitant les conflits entre différentes versions de logiciels ou de bibliothèques.
- Portabilité : les conteneurs Docker peuvent s’exécuter sur tout système prenant en charge Docker, ce qui facilite le déploiement de tes modèles sur différentes plateformes sans modification.
- Évolutivité : tu peux facilement adapter le nombre de conteneurs à la demande, et des outils d’orchestration comme Kubernetes peuvent automatiser ce processus.
- Gestion des versions : tu peux gérer les versions des images Docker, suivre les modifications et revenir aux versions précédentes si nécessaire.
Mettre en œuvre Docker pour le déploiement de YOLO26#
Pour conteneuriser ton modèle YOLO26, tu peux créer un Dockerfile qui spécifie toutes les dépendances et configurations nécessaires. Voici un exemple de base :
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Cette approche garantit que le déploiement de ton modèle est reproductible et cohérent dans les environnements de développement, de test et de production.
Techniques d’optimisation des modèles#
L'optimisation de ton modèle de vision par ordinateur l'aide à fonctionner efficacement, en particulier lors de déploiements dans des environnements aux ressources limitées, comme les appareils edge. Voici quelques techniques clés pour optimiser ton modèle.
Élagage des modèles#
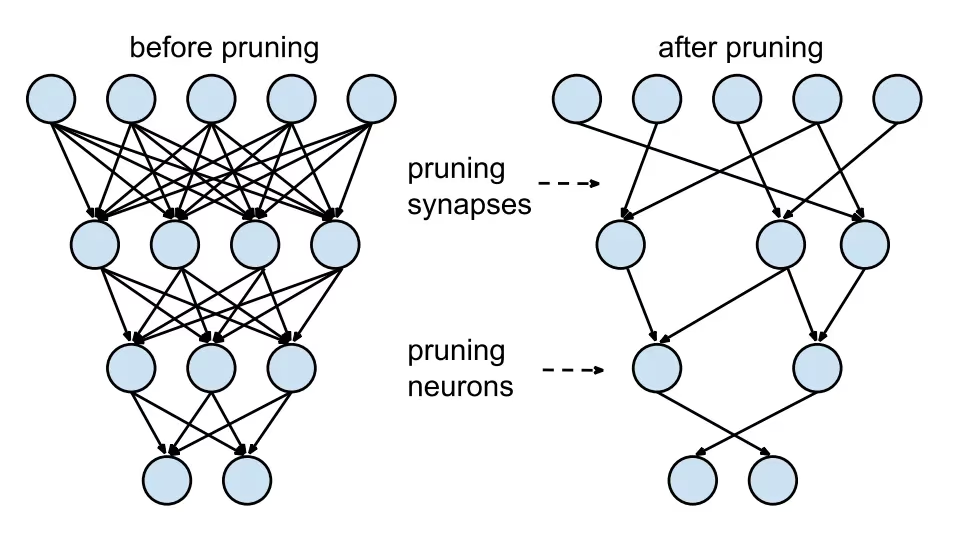
L'élagage réduit la taille du modèle en supprimant les poids qui contribuent peu au résultat final. Il rend le modèle plus petit et plus rapide sans nuire significativement à la précision. L'élagage consiste à repérer et à éliminer les paramètres superflus, ce qui produit un modèle plus léger nécessitant moins de puissance de calcul. Cette technique est particulièrement utile pour déployer des modèles sur des appareils aux ressources limitées.
Quantification des modèles#
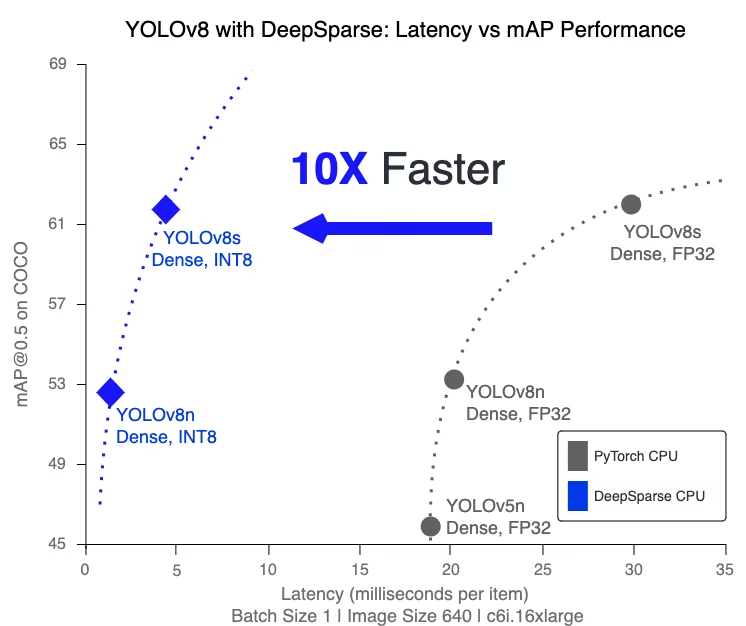
La quantification convertit les poids et les activations du modèle d'une précision élevée (par exemple, des flottants sur 32 bits) vers une précision inférieure (par exemple, des entiers sur 8 bits). En réduisant la taille du modèle, elle accélère l'inférence. L'entraînement conscient de la quantification (QAT) est une méthode qui entraîne le modèle en tenant compte de la quantification, ce qui préserve mieux la précision que la quantification après l'entraînement. En prenant en charge la quantification pendant la phase d'entraînement, le modèle apprend à s'adapter à une précision inférieure, en maintenant ses performances tout en réduisant les besoins de calcul. Dans Ultralytics YOLO, définis quantize=8 lors de l'exportation pour une quantification INT8 après l'entraînement, ou au moment de l'entraînement pour le QAT.
Distillation des connaissances#
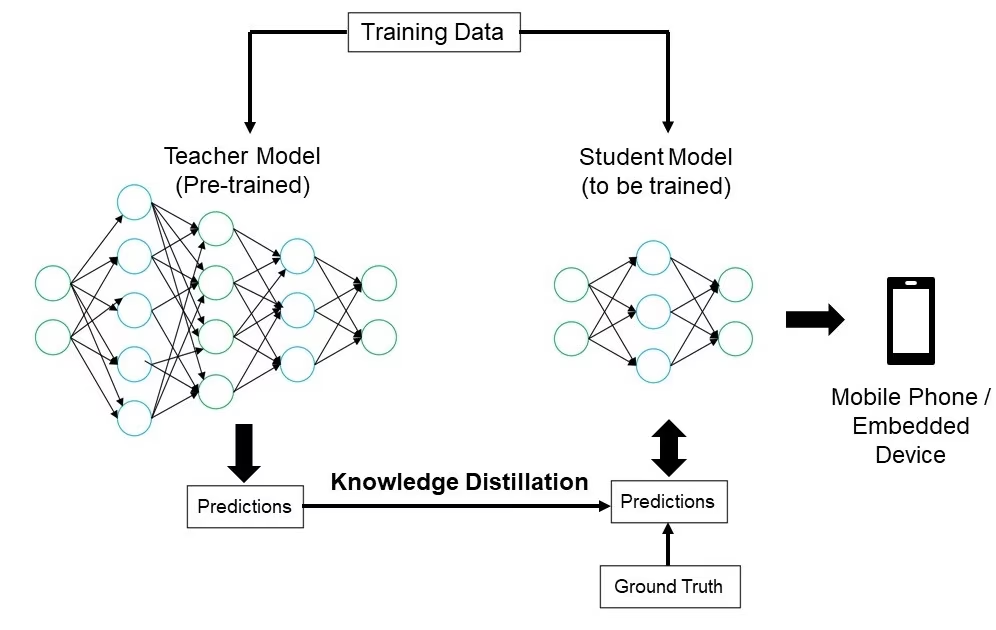
La distillation des connaissances consiste à entraîner un modèle plus petit et plus simple (l'élève) pour qu'il imite les sorties d'un modèle plus grand et plus complexe (l'enseignant). Le modèle élève apprend à approximer les prédictions de l'enseignant, ce qui donne un modèle compact qui conserve une grande partie de la précision de l'enseignant. Cette technique est utile pour créer des modèles efficaces adaptés au déploiement sur des appareils edge aux ressources limitées. Ultralytics YOLO la prend en charge via l'argument d'entraînement distill_model.
Résolution des problèmes de déploiement#
Tu peux rencontrer des difficultés lors du déploiement de tes modèles de vision par ordinateur, mais comprendre les problèmes courants et leurs solutions peut simplifier le processus. Voici quelques conseils généraux de dépannage et bonnes pratiques pour t’aider à résoudre les problèmes de déploiement.
Ton modèle est moins précis après le déploiement#
Une baisse de la précision de ton modèle après son déploiement peut être due à différents facteurs. Voici quelques étapes pour t'aider à identifier et à résoudre le problème :
- Vérifie la cohérence des données : assure-toi que les données traitées par ton modèle après son déploiement sont cohérentes avec celles utilisées pour son entraînement. Les différences de distribution, de qualité ou de format des données peuvent avoir un impact significatif sur les performances.
- Valide les étapes de prétraitement : vérifie que toutes les étapes de prétraitement appliquées pendant l’entraînement le sont aussi de manière cohérente lors du déploiement. Cela inclut le redimensionnement des images, la normalisation des valeurs des pixels et les autres transformations des données.
- Évalue l’environnement du modèle : vérifie que les configurations matérielles et logicielles utilisées lors du déploiement correspondent à celles de l’entraînement. Des différences entre les bibliothèques, leurs versions et les capacités matérielles peuvent entraîner des écarts.
- Surveille l’inférence du modèle : consigne les entrées et les sorties aux différentes étapes du pipeline d’inférence afin de détecter les anomalies. Cette démarche peut aider à identifier des problèmes comme la corruption des données ou la mauvaise gestion des sorties du modèle.
- Vérifie l’exportation et la conversion du modèle : exporte à nouveau le modèle et assure-toi que le processus de conversion préserve l’intégrité des poids et de l’architecture du modèle.
- Effectue des tests avec un jeu de données contrôlé : déploie le modèle dans un environnement de test avec un jeu de données que tu contrôles et compare les résultats avec ceux de la phase d’entraînement. Tu peux ainsi déterminer si le problème vient de l’environnement de déploiement ou des données.
Lors du déploiement de YOLO26, plusieurs facteurs peuvent affecter la précision du modèle. La conversion de modèles vers des formats comme TensorRT implique des optimisations telles que la quantification des poids et la fusion des couches, susceptibles d'entraîner de légères pertes de précision. L'utilisation de FP16 (demi-précision) au lieu de FP32 (pleine précision) peut accélérer l'inférence, mais risque d'introduire des erreurs de précision numérique. De plus, les contraintes matérielles, comme celles du Jetson Nano, avec un nombre inférieur de cœurs CUDA et une bande passante mémoire réduite, peuvent affecter les performances.
Les inférences prennent plus de temps que prévu#
Lors du déploiement de modèles de machine learning, il est important qu’ils s’exécutent efficacement. Si les inférences prennent plus de temps que prévu, l’expérience utilisateur et l’efficacité de ton application peuvent en pâtir. Voici quelques étapes pour t’aider à identifier et à résoudre le problème :
- Effectue des exécutions de préchauffage : les premières exécutions comprennent souvent des opérations de configuration qui peuvent fausser les mesures de latence. Effectue quelques inférences de préchauffage avant de mesurer la latence. En excluant ces premières exécutions, tu obtiendras une mesure plus précise des performances du modèle.
- Optimise le moteur d’inférence : vérifie que le moteur d’inférence est entièrement optimisé pour l’architecture de ton GPU. Utilise les pilotes et les versions logicielles les plus récents, adaptés à ton matériel, afin de garantir des performances et une compatibilité maximales.
- Utilise le traitement asynchrone : le traitement asynchrone peut aider à gérer les charges de travail plus efficacement. Utilise des techniques de traitement asynchrone pour exécuter plusieurs inférences simultanément, ce qui peut contribuer à répartir la charge et à réduire les temps d’attente.
- Profile le pipeline d’inférence : repérer les goulots d’étranglement dans le pipeline d’inférence peut aider à identifier la source des retards. Utilise des outils de profilage pour analyser chaque étape du processus d’inférence, puis repérer et corriger celles qui causent des retards importants, comme les couches inefficaces ou les problèmes de transfert de données.
- Utilise une précision adaptée : une précision supérieure à celle nécessaire peut ralentir l'inférence. Essaie une précision inférieure, comme FP16 (
quantize=16lors de l'exportation), au lieu de FP32 (pleine précision). Même si FP16 peut réduire le temps d'inférence, garde à l'esprit qu'elle peut aussi affecter la précision du modèle.
Si tu rencontres ce problème lors du déploiement de YOLO26, sache que YOLO26 propose plusieurs tailles de modèles, par exemple YOLO26n (nano) pour les appareils ayant une capacité mémoire moindre et YOLO26x (très grand) pour les GPU plus puissants. Choisir la variante de modèle adaptée à ton matériel peut aider à trouver un équilibre entre l’utilisation de la mémoire et le temps de traitement.
Garde aussi à l’esprit que la taille des images d’entrée a une incidence directe sur l’utilisation de la mémoire et le temps de traitement. Une résolution plus faible réduit l’utilisation de la mémoire et accélère l’inférence, tandis qu’une résolution plus élevée améliore la précision, mais nécessite davantage de mémoire et de puissance de traitement.
Considérations de sécurité pour le déploiement de modèles#
La sécurité est un autre aspect important du déploiement. Elle est essentielle pour protéger les données sensibles et la propriété intellectuelle associées à tes modèles déployés. Voici quelques bonnes pratiques à suivre pour sécuriser le déploiement de tes modèles.
Sécurisation de la transmission des données#
Il est essentiel de sécuriser les données envoyées entre les clients et les serveurs pour éviter qu'elles soient interceptées ou consultées par des personnes non autorisées. Tu peux utiliser des protocoles de chiffrement comme TLS (sécurité de la couche transport) pour chiffrer les données pendant leur transmission. Même si quelqu'un les intercepte, il ne pourra pas les lire. Tu peux également utiliser le chiffrement de bout en bout, qui protège les données de leur source jusqu'à leur destination afin que personne entre les deux ne puisse y accéder.
Contrôle des accès#
Il est essentiel de contrôler qui peut accéder à ton modèle et à ses données afin d’éviter toute utilisation non autorisée. Utilise des méthodes d’authentification robustes pour vérifier l’identité des utilisateurs ou des systèmes qui tentent d’accéder au modèle, et envisage de renforcer la sécurité avec l’authentification multifacteur (MFA). Configure un contrôle d’accès basé sur les rôles (RBAC) pour attribuer les autorisations en fonction des rôles des utilisateurs, afin que chacun n’accède qu’aux ressources dont il a besoin. Conserve des journaux d’audit détaillés pour suivre tous les accès et toutes les modifications apportées au modèle et à ses données, puis consulte régulièrement ces journaux pour repérer toute activité suspecte.
Obfuscation du modèle#
L’obfuscation du modèle permet de le protéger contre la rétro-ingénierie et les utilisations abusives. Elle consiste notamment à chiffrer les paramètres du modèle, comme les poids et les biais des réseaux neuronaux, afin d’empêcher les personnes non autorisées de comprendre ou de modifier le modèle. Tu peux aussi obfusquer l’architecture du modèle en renommant les couches et les paramètres ou en ajoutant des couches factices, ce qui complique la rétro-ingénierie pour les attaquants. Servir le modèle dans un environnement sécurisé, comme une enclave sécurisée ou un environnement d’exécution de confiance (TEE), peut également ajouter une couche de protection pendant l’inférence.
Conclusion et prochaines étapes#
Nous avons passé en revue quelques bonnes pratiques à suivre lors du déploiement de modèles de vision par ordinateur. En sécurisant les données, en contrôlant les accès et en obfusquant les détails du modèle, tu peux protéger les informations sensibles tout en assurant le bon fonctionnement de tes modèles. Nous avons également vu comment résoudre des problèmes courants comme la baisse de précision et la lenteur des inférences grâce à des stratégies telles que les exécutions de préchauffage, l’optimisation des moteurs, le traitement asynchrone, le profilage des pipelines et le choix d’une précision adaptée.
Après avoir déployé ton modèle, l'étape suivante consiste à surveiller, maintenir et documenter ton application. Une surveillance régulière permet de détecter et de corriger rapidement les problèmes, la maintenance garantit que tes modèles restent à jour et fonctionnels, et une bonne documentation consigne toutes les modifications et mises à jour. Ces étapes t'aideront à atteindre les objectifs de ton projet de vision par ordinateur.
FAQ#
Le déploiement d’un modèle de machine learning, notamment avec Ultralytics YOLO26, nécessite de suivre plusieurs bonnes pratiques pour garantir son efficacité et sa fiabilité. Commence par choisir l’environnement de déploiement adapté à tes besoins : cloud, edge ou local. Optimise ton modèle à l’aide de techniques comme l’élagage, la quantification et la distillation des connaissances afin de le déployer efficacement dans des environnements aux ressources limitées. Envisage la conteneurisation avec Docker pour garantir la cohérence entre différents environnements. Enfin, veille à ce que la cohérence des données et les étapes de prétraitement correspondent à celles de la phase d’entraînement afin de préserver les performances. Tu peux également consulter les options de déploiement des modèles pour obtenir des recommandations plus détaillées.
Le dépannage des problèmes de déploiement peut se décomposer en quelques étapes clés. Si la précision de ton modèle baisse après le déploiement, vérifie la cohérence des données, valide les étapes de prétraitement et assure-toi que l’environnement matériel et logiciel correspond à celui utilisé pendant l’entraînement. Si l’inférence est lente, effectue des exécutions de préchauffage, optimise ton moteur d’inférence, utilise le traitement asynchrone et profile ton pipeline d’inférence. Consulte le guide sur le dépannage des problèmes de déploiement pour obtenir des instructions détaillées sur ces bonnes pratiques.
L’optimisation des modèles Ultralytics YOLO26 pour les appareils edge consiste à utiliser des techniques comme l’élagage pour réduire la taille du modèle, la quantification pour convertir les poids vers une précision moindre et la distillation des connaissances pour entraîner des modèles plus petits qui imitent les plus grands. Ces techniques permettent au modèle de fonctionner efficacement sur des appareils dont la puissance de calcul est limitée. Des outils comme LiteRT et NVIDIA Jetson sont particulièrement utiles pour ces optimisations. Pour en savoir plus sur ces techniques, consulte notre section sur l’optimisation des modèles.
La sécurité est primordiale lors du déploiement de modèles de machine learning. Assure-toi que la transmission des données est sécurisée grâce à des protocoles de chiffrement comme TLS. Mets en place des contrôles d’accès robustes, notamment une authentification forte et un contrôle d’accès basé sur les rôles (RBAC). Les techniques d’obfuscation des modèles, comme le chiffrement de leurs paramètres et leur utilisation dans un environnement sécurisé tel qu’un environnement d’exécution de confiance (TEE), offrent une protection supplémentaire. Pour connaître les pratiques détaillées, consulte notre page sur les considérations de sécurité.
Le choix de l’environnement de déploiement optimal pour ton modèle Ultralytics YOLO26 dépend des besoins spécifiques de ton application. Le déploiement dans le cloud offre évolutivité et facilité d’accès, ce qui en fait une solution idéale pour les applications traitant de grands volumes de données. Le déploiement edge convient mieux aux applications à faible latence qui nécessitent des réponses en temps réel, avec des outils comme LiteRT. Le déploiement local est adapté aux scénarios exigeant un contrôle strict de la confidentialité des données. Pour obtenir un aperçu complet de chaque environnement, consulte notre section sur le choix d’un environnement de déploiement.


Commentaires10
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.