Exportation Qualcomm QNN pour les modèles Ultralytics YOLO#
Le déploiement de modèles de vision par ordinateur sur des appareils Qualcomm Snapdragon nécessite un format de modèle adapté au runtime Qualcomm AI Engine Direct (QNN). L'exportation des modèles Ultralytics YOLO au format QNN permet d'exécuter une inférence accélérée sur l'appareil avec les CPU Snapdragon, les GPU Adreno et les NPU Hexagon présents dans des milliards de téléphones mobiles, d'ordinateurs portables, de systèmes automobiles et d'appareils IoT. Ce guide explique comment exporter YOLO vers Qualcomm QNN et le déployer pour une inférence rapide et économe en énergie sur du matériel Snapdragon.
Le plugin Flutter officiel d'Ultralytics propose la prise en charge facultative de QNN pour l'inférence caméra en temps réel et la prédiction sur une seule image pour les sept tâches YOLO26. Active le runtime QNN et ajoute sa dépendance ONNX Runtime comme indiqué dans le README du plugin. Pour un déploiement sur iOS, consulte le SDK Ultralytics YOLO pour iOS et l'intégration CoreML.
Exporte les modèles de classification vers imgsz=224. Exporte les modèles de détection, de segmentation, de segmentation sémantique, de profondeur, de pose et OBB vers imgsz=640. Cette norme 224/640 est commune aux ressources mobiles officielles QNN, LiteRT et CoreML. Les ressources v73 et v81 prêtes à l'emploi pour les sept tâches nano sont publiées dans la version v0.6.6 de yolo-flutter-app.
Qu'est-ce que Qualcomm QNN ?#
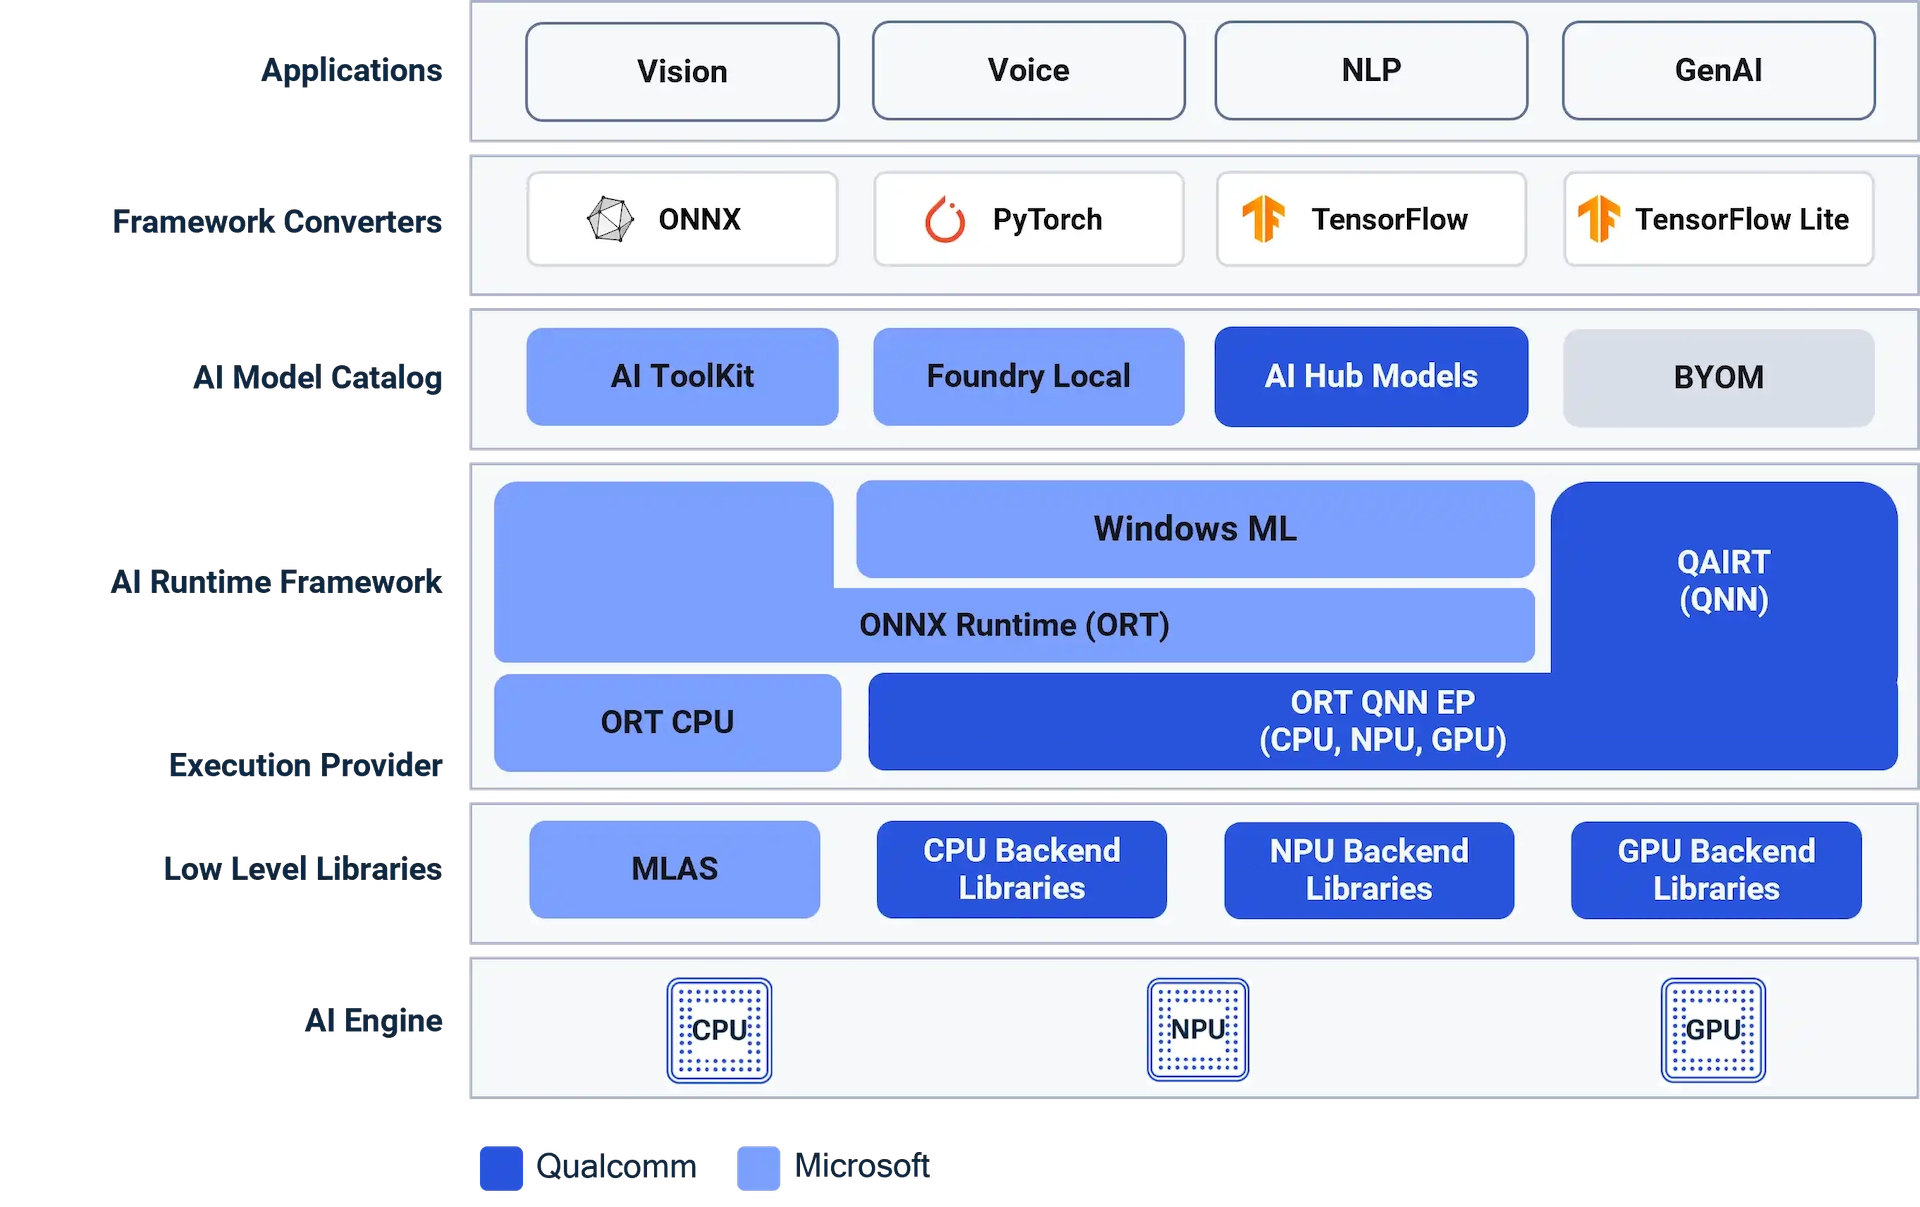
Qualcomm AI Engine Direct — généralement appelé QNN et distribué dans le cadre du SDK Qualcomm AI Runtime (QAIRT) — est la pile d'inférence bas niveau de Qualcomm pour les processeurs Snapdragon. Elle fournit une API unifiée avec des bibliothèques propres à chaque backend, destinées au CPU Snapdragon, au GPU Adreno et au processeur Tensor Hexagon (HTP), l'unité de traitement des réseaux neuronaux dédiée (NPU) des SoC Snapdragon modernes. QNN donne aux développeurs un accès complet à la pile logicielle de ces accélérateurs d'IA Snapdragon et succède au SDK Snapdragon Neural Processing Engine (SNPE). Il alimente l'IA embarquée sur les plateformes mobiles Snapdragon 8 Gen 2, 8 Gen 3 et 8 Elite, les ordinateurs portables Snapdragon X ainsi que les produits automobiles et XR.
Pourquoi exporter vers Qualcomm QNN ?#
Snapdragon est la plateforme de calcul mobile la plus répandue au monde. Exporter Ultralytics YOLO au format Qualcomm QNN permet d'exploiter le matériel d'IA dédié de ces appareils :
- Accélération par le NPU Hexagon : l'exécution de YOLO sur le processeur Tensor Hexagon offre un débit nettement supérieur et une consommation plus faible que l'inférence sur CPU — un choix idéal pour l'inférence en temps réel et la vision par ordinateur toujours active sur Snapdragon.
- Sur l'appareil et hors ligne : l'inférence QNN s'exécute entièrement sur l'appareil Snapdragon. Il n'y a donc aucun aller-retour vers le cloud, la latence reste faible et les données ne quittent jamais l'appareil.
- Efficacité de la quantification : l'exportation QNN quantifie YOLO avec des poids INT8 et des activations 16 bits, un équilibre précision/performances adapté au NPU Hexagon. Le modèle est ainsi plus compact et le nombre d'images par seconde est maximisé sur le matériel alimenté par batterie.
- Un seul format, de nombreux appareils : une seule exportation Qualcomm QNN cible les CPU Snapdragon, les GPU Adreno et les NPU Hexagon des familles Snapdragon 8 Gen 2, 8 Gen 3 et 8 Elite, ainsi que d'autres appareils.
- Pile d'IA Qualcomm prête pour la production : QNN (Qualcomm AI Engine Direct / QAIRT) est le runtime d'IA embarquée actuel de Qualcomm, activement maintenu et recommandé pour remplacer SNPE.
Format d'exportation QNN#
Ultralytics compile les modèles YOLO au format QNN en local à l'aide du fournisseur d'exécution QNN d'ONNX Runtime (le paquet onnxruntime-qnn installable avec pip, qui inclut les bibliothèques QAIRT). L'exportateur convertit ton modèle en ONNX, le quantifie à l'aide de données d'étalonnage pour obtenir des activations 16 bits et des poids INT8 (l'équilibre recommandé pour le NPU Hexagon), puis initialise une session ONNX Runtime avec la mise en cache des fichiers binaires de contexte activée — cette étape compile le graphe quantifié dans un fichier binaire de contexte QNN intégré à <model>_qnn.onnx. Aucun compte Qualcomm, téléversement vers le cloud ni téléchargement d'un SDK distinct n'est nécessaire.
Contrairement à Qualcomm AI Hub, basé dans le cloud, qui compile et profile les modèles sur des appareils Snapdragon hébergés par Qualcomm et nécessite un compte Qualcomm, l'exportation QNN d'Ultralytics s'exécute entièrement sur ta propre machine avec un seul appel à export(format="qnn", imgsz=640) (imgsz=224 pour la classification). Tu profites du même runtime QNN/QAIRT — CPU Snapdragon, GPU Adreno et NPU Hexagon — sans inscription, limite de téléversement ni temps d'attente, et l'exportation s'intègre directement au workflow standard d'exportation YOLO.
Le fichier *_qnn.onnx exporté est autonome : il intègre le fichier binaire de contexte QNN et les métadonnées ONNX, comme les noms des classes, la taille des images et la tâche.
Principales caractéristiques des modèles QNN#
- Quantification : le modèle est quantifié avec des activations 16 bits et des poids INT8 au moyen du flux QDQ QNN d'ONNX Runtime et d'un jeu de données d'étalonnage, selon l'équilibre précision/performances recommandé pour le NPU Hexagon. Pour en savoir plus, consulte la page sur la quantification des modèles.
- Compilation entièrement locale : le fichier binaire de contexte est généré entièrement sur ta machine hôte — aucun compte Qualcomm, jeton API ou téléversement vers le cloud n'est nécessaire.
- Accélération complète sur Snapdragon : exécute l'inférence sur le NPU Hexagon (HTP), le GPU Adreno ou le CPU au moyen d'un runtime unifié.
- Large compatibilité avec les appareils : cible la vaste gamme de plateformes Snapdragon équipant les téléphones, les PC (Windows sur Snapdragon), les produits automobiles, XR et embarqués.
- Fichier binaire de contexte précompilé : la livraison d'un fichier binaire de contexte réduit la compilation des graphes sur l'appareil et diminue ainsi la latence de chargement du modèle sur la cible.
- Fichier de sortie autonome : le fichier ONNX exporté inclut le fichier binaire de contexte QNN précompilé et les métadonnées nécessaires à un déploiement simple.
Performances mesurées#
Téléphone Android#
Matériel : Xiaomi 17 avec 12 Go de mémoire LPDDR5X et Android 16 / API 36. Son Snapdragon 8 Elite Gen 5 de 3 nm (SM8850) comprend un CPU Qualcomm Oryon à 8 cœurs (2 cœurs Prime jusqu'à 4,6 GHz et 6 cœurs Performance jusqu'à 3,62 GHz), un GPU Adreno et un NPU Hexagon (HTP v81).
| Modèle | Tâche | taille (pixels) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Détection | 640 | 52.2 1.8 / 48.1 / 2.4 | 15.8 2.3 / 8.9 / 4.6 | 10.7 1.8 / 6.7 / 2.2 |
| YOLO26n-seg | Segmentation | 640 | 73.4 1.8 / 65.6 / 6.0 | 33.2 1.8 / 23.8 / 7.6 | 17.4 1.8 / 9.9 / 5.7 |
| YOLO26n-sem | Sémantique | 640 | 61.2 1.8 / 51.1 / 8.3 | 34.2 1.8 / 24.0 / 8.3 | 11.5 1.8 / 7.1 / 2.6 |
| YOLO26n-depth | Profondeur | 640 | 124.4 1.9 / 115.1 / 7.4 | 23.0 1.8 / 13.5 / 7.7 | 35.2 1.8 / 26.1 / 7.3 |
| YOLO26n-cls | Classification | 224 | 4.4 0.4 / 4.0 / 0.0 | 3.1 0.8 / 2.1 / 0.2 | 1.2 0.6 / 0.6 / 0.0 |
| YOLO26n-pose | Pose | 640 | 57.4 1.8 / 53.8 / 1.8 | 16.6 2.7 / 10.1 / 3.9 | 10.9 1.8 / 7.0 / 2.0 |
| YOLO26n-obb | OBB | 640 | 50.3 1.8 / 47.2 / 1.4 | 11.7 1.8 / 7.8 / 2.0 | 8.6 1.8 / 5.7 / 1.1 |
- Les valeurs de vitesse correspondent aux latences en rafale sur une seule image — la moyenne de 15 exécutions après 3 exécutions de préchauffage sur
bus.jpg, mesurée avec le banc d'essai embarqué0.6.10du plugin Flutter et les ressources standardiséesv0.6.6. L'ordre des backends a alterné entre les tâches au cours d'une seule série séquentielle. Les journaux natifs ont confirmé que chaque ligne CPU utilisait LiteRT CPU/XNNPACK, que chaque ligne GPU déléguait le graphe complet à LiteRT OpenCL (LITERT_CL) et que chaque ligne NPU utilisait le backend QNN Hexagon HTP. - Le relevé détaillé du benchmark se trouve dans la documentation sur les performances Flutter.
- Compare d'autres appareils Android dans l'intégration LiteRT et des appareils Apple dans l' intégration CoreML.
Ordinateur portable Windows sur Snapdragon#
Cette série de mesures historique utilisait des fichiers binaires QNN v73 antérieurs à la standardisation ; la segmentation sémantique et OBB utilisaient des entrées de 1024 px. Les tests ont été effectués sur un ordinateur portable Lenovo avec 32 Go de mémoire et Windows 11. Son Snapdragon X Elite (X1E78100) comprend un CPU Qualcomm Oryon à 12 cœurs, un GPU Adreno et un NPU Hexagon (HTP v73) ; le modèle Lenovo exact n'a pas été consigné. Cette comparaison sous Windows sur Snapdragon oppose la référence CPU PyTorch FP32 native, généralement utilisée par les développeurs de bureau, au chemin Hexagon HTP de ONNX Runtime QNN. Chaque cellule indique le temps écoulé total de model.predict() et, en dessous, les durées de prétraitement / inférence / post-traitement indiquées ; le temps total peut inclure des frais généraux du framework en dehors de ces trois étapes. Les valeurs CPU correspondent à PyTorch FP32 (torch==2.10.0+cpu) et celles du NPU à ONNX Runtime QNN (onnxruntime-qnn==2.2.0, poids INT8 / activations 16 bits).
| Modèle | Tâche | taille (pixels) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Détection | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segmentation | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Sémantique | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Classification | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Pose | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Les valeurs de vitesse correspondent aux latences en rafale pour une seule image : la moyenne de 100 exécutions après 10 exécutions de préchauffage sur
bus.jpg, mesurée avectime.perf_counter()autour de l'appel completmodel.predict()sur un appareil refroidi (ultralytics==8.4.67, Python 3.12.10). - Le NPU Hexagon est environ 2 à 4 fois plus rapide que la référence CPU PyTorch pour les tâches de 640 à 1024 px (environ 3,4 fois pour la détection), l'écart se réduisant à environ 1,3 fois pour le classificateur de 224 px, où les coûts fixes du prétraitement dominent cette charge de travail minime.
Tâches prises en charge#
L'exportation Qualcomm QNN prend en charge les sept tâches Ultralytics. La segmentation sémantique et l'estimation de profondeur sont disponibles uniquement avec YOLO26, la seule famille à proposer ces têtes.
| Tâche | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Détecter | ✅ | ✅ | ✅ |
| Segmenter | ✅ | ✅ | ✅ |
| Sémantique | ❌ | ❌ | ✅ |
| Profondeur | ❌ | ❌ | ✅ |
| Classifier | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportation au format QNN : convertir ton modèle YOLO#
Exporte un modèle Ultralytics YOLO au format QNN pour le déployer sur du matériel Qualcomm. Le binaire de contexte est finalisé pour une architecture Hexagon de processeur Tensor (HTP) ou un SoC pris en charge, que tu sélectionnes avec l'argument name — le même argument que celui utilisé pour cibler une puce lors de l'exportation RKNN.
Cibles HTP prises en charge#
Indique l'architecture cible ou le SoC avec name (par exemple, name="73" ou name="iq-8275"). La prise en charge dépend de la cible HTP ; les lignes Snapdragon ci-dessous représentent donc des plateformes, et non une liste exhaustive de tous les SoC. Les appareils Dragonwing sont répertoriés explicitement.
| Statut | name | HTP Hexagon | Appareil ou plateforme en exemple |
|---|---|---|---|
| ✅ Pris en charge | 68 | v68 | Snapdragon 888 |
| ✅ Pris en charge | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ Pris en charge | 73 | v73 | Snapdragon 8 Gen 2, X Elite (par défaut) |
| ✅ Pris en charge | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ Pris en charge | 79 | v79 | Snapdragon 8 Elite |
| ✅ Pris en charge | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ Pris en charge | iq-8275 ou qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275 (modèle SoC QNN 82) |
| ❌ Non pris en charge | — | v66 | Dragonwing IQ-615 / QCS615 |
Dragonwing IQ-615 ne peut pas utiliser l'exportation Ultralytics QNN du binaire de contexte, car ONNX Runtime n'expose pas son DSP v66 comme cible HTP hors ligne. Un exportation ONNX standard peut tout de même être intégrée séparément avec un fournisseur d'exécution CPU ou GPU pris en charge par le BSP de la carte.
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)L'exportation QNN utilise le paquet onnxruntime-qnn. À partir de la version 2.4.0, des roues précompilées sont publiées pour Windows (x64 et ARM64) et Linux (x86-64 et ARM64) avec Python 3.11 ou une version ultérieure ; macOS n'est pas un hôte QNN pris en charge. La génération du binaire de contexte QNN s'effectue sur un hôte x64 et ne nécessite pas d'appareil Snapdragon pour l'étape d'exportation.
Installation#
Pour installer les paquets requis, exécute :
# Install the required package for YOLO
pip install ultralytics
Le paquet onnxruntime-qnn (qui fournit le fournisseur d'exécution ONNX Runtime QNN et regroupe les bibliothèques QAIRT) est installé automatiquement lors de la première exportation. Pour obtenir des instructions détaillées et connaître les bonnes pratiques liées au processus d'installation, consulte notre guide d'installation Ultralytics. Si tu rencontres des difficultés lors de l'installation des paquets requis pour YOLO, consulte notre guide des problèmes courants pour trouver des solutions et des conseils.
Utilisation#
Le format QNN prend en charge les modes Export, Predict et Validate. L'inférence et la validation s'exécutent sur du matériel Qualcomm Snapdragon par l'intermédiaire du fournisseur d'exécution QNN d'ONNX Runtime (le même paquet onnxruntime-qnn que celui utilisé pour l'exportation). Exporte ton modèle, puis charge le modèle exporté sur un appareil Snapdragon pour lancer l'inférence ou valider sa précision.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# # Exporter au format Qualcomm QNN (INT8, appliqué automatiquement) pour la cible HTP v73 par défaut
model.export(format="qnn", name="73", imgsz=640) # utiliser imgsz=224 pour la classificationfrom ultralytics import YOLO
# # Charger le modèle QNN exporté (sur un appareil Snapdragon avec onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # Charger le modèle QNN exporté (sur un appareil Snapdragon avec onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Arguments d’exportation#
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'qnn' | Format cible du modèle exporté, qui définit sa compatibilité avec l'environnement d'exécution Qualcomm QNN. |
imgsz | int ou tuple | 640 | Taille d’image souhaitée pour l’entrée du modèle. Peut être un entier pour les images carrées ou un tuple (height, width). |
batch | int | 1 | Indique la taille de lot du modèle exporté, intégrée au binaire de contexte QNN généré. |
name | str | '73' | Architecture cible Hexagon HTP (68, 69, 73, 75, 79 ou 81) ou SoC pris en charge (iq-8275 ou qcs8275). Le binaire de contexte est finalisé pour cette cible. |
quantize | int ou str | 'w8a16'/auto | Précision de quantification. L'exportation QNN HTP quantifie les poids en INT8 et les activations en 16 bits ('w8a16') ; cette option est activée automatiquement si elle n'est pas spécifiée. Remplace les options obsolètes half/int8. |
simplify | bool | True | Simplifie le graphe ONNX intermédiaire avec onnxslim. |
opset | int | None | Spécifie la version d’opset ONNX du graphe ONNX intermédiaire. Si elle n’est pas définie, la dernière version prise en charge est utilisée. |
data | str | None | Fichier YAML du jeu de données utilisé pour l'étalonnage INT8 ; pour la classification, indique plutôt un répertoire de jeu de données ou le nom d'un jeu de données intégré. Si tu ne précises rien, Ultralytics sélectionne le jeu de données d'étalonnage par défaut pour la tâche du modèle. |
fraction | float, int ou list | 1.0 | Sous-ensemble de calibration exprimé en ratio, en nombre d’images ou en listes [train, val, test] de ratios/de nombres. Les listes de deux éléments laissent test complet, tandis que 0 l’ignore. |
device | str | None | Indique l'appareil utilisé pour l'étape d'exportation ONNX : GPU (device=0) ou CPU (device=cpu). |
L'exportation QNN quantifie le modèle avec des activations 16 bits et des poids INT8 — l'équilibre recommandé entre précision et performances pour le NPU Hexagon — en utilisant le processus de quantification QDQ d'ONNX Runtime avec des images d'étalonnage issues de data. quantize='w8a16' est activé automatiquement.
Pour en savoir plus sur le processus d’export, consulte la page de la documentation Ultralytics consacrée à l’export.
Structure de sortie#
Une fois l'exportation réussie, un fichier ONNX autonome est créé :
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
Le fichier yolo26n_qnn.onnx intègre le binaire de contexte QNN et est chargé par ONNX Runtime avec le fournisseur d'exécution QNN sur l'appareil Snapdragon. Il contient également des métadonnées du modèle, comme les noms des classes, la taille de l'image et la tâche, dans ONNX metadata_props.
Déployer les modèles YOLO QNN exportés#
Les modèles QNN s'exécutent sur du matériel Qualcomm pris en charge, ce qui simplifie le déploiement de modèles sur l'appareil. Sur un appareil compatible où onnxruntime-qnn est installé, exécute directement le modèle exporté avec l'API Ultralytics (yolo predict/yolo val, consulte la section Utilisation ci-dessus) : Ultralytics charge le binaire de contexte HTP via le fournisseur d'exécution QNN d'ONNX Runtime.
Pour tes pipelines personnalisés, tu peux aussi charger directement le fichier ONNX du binaire de contexte avec ONNX Runtime. onnxruntime-qnn est un fournisseur d'exécution enfichable ; il faut donc l'enregistrer à l'exécution :
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# # Sur l'appareil Snapdragon, enregistrer le fournisseur d'exécution QNN enfichable et sélectionner son ou ses appareils
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
Comme le binaire de contexte QNN est précompilé, la session se charge rapidement sans recompilation du graphe sur l'appareil.
Prérequis pour Linux et le BSP Yocto#
La carte cible doit fournir un environnement d'exécution Qualcomm et un BSP mutuellement compatibles. Pour l'inférence HTP, cela comprend le fournisseur d'exécution QNN d'ONNX Runtime, libQnnSystem.so, libQnnHtp.so, les bibliothèques stub et skeleton HTP v75 pour IQ-8275, la prise en charge de FastRPC en espace utilisateur, telle que libcdsprpc.so, le micrologiciel DSP et les pilotes FastRPC/noyau correspondants. La bibliothèque skeleton doit être accessible via le chemin des bibliothèques DSP du BSP.
Ces composants côté cible proviennent du BSP du fabricant de la carte, compatible QAIRT/QNN ; ils ne sont pas intégrés au modèle exporté. L'exécution sur GPU nécessite plutôt libQnnGpu.so et la pile de pilotes en espace utilisateur Adreno correspondante. Le résultat Ultralytics format=qnn est un binaire de contexte spécifique au HTP ; pour un déploiement sur GPU ou CPU, pars donc d'un export ONNX standard plutôt que du fichier précompilé *_qnn.onnx.
Flux de travail recommandé#
- Entraîne ton modèle avec le mode Train d’Ultralytics
- Exporte au format QNN avec
model.export(format="qnn", name="iq-8275", imgsz=640)sur une plateforme prise en charge (utiliseimgsz=224pour la classification) - Déploie le fichier exporté
*_qnn.onnxsur ton appareil Qualcomm - Lance l'inférence avec ONNX Runtime et le fournisseur d'exécution QNN utilisant le backend HTP
Applications concrètes#
Les modèles YOLO exécutés sur du matériel Qualcomm Snapdragon conviennent parfaitement à de nombreuses applications d'IA en périphérie :
- Smartphones : détection d'objets en temps réel et compréhension de scènes dans les applications de caméra et de photos grâce à l'accélération NPU.
- Windows sur Snapdragon : vision par ordinateur sur l'appareil, sur les PC Copilot+, sans transfert vers le cloud.
- Automobile : surveillance du conducteur, détection des occupants et fonctionnalités ADAS sur les plateformes Snapdragon Digital Chassis.
- XR et objets connectés : perception à faible consommation et faible latence pour les casques AR/VR et les lunettes intelligentes.
- IoT et robotique : inférence visuelle efficace sur les caméras, drones et systèmes embarqués équipés de Snapdragon.
Résumé#
Dans ce guide, tu as appris à exporter localement des modèles Ultralytics YOLO au format Qualcomm QNN avec le fournisseur d'exécution QNN d'ONNX Runtime. Le pipeline d'exportation convertit ton modèle en ONNX, puis le compile en binaire de contexte QNN sur ta machine hôte — sans compte Qualcomm ni service cloud — et produit un fichier *_qnn.onnx optimisé pour le CPU Snapdragon, le GPU Adreno et le NPU Hexagon via l'environnement d'exécution QNN/QAIRT.
L'association d'Ultralytics YOLO et de la pile d'IA embarquée de Qualcomm offre une solution efficace pour exécuter des charges de travail avancées de vision par ordinateur au sein du vaste écosystème Snapdragon.
Pour d'autres cibles de déploiement sur appareil et mobile, consulte les guides d'exportation ONNX, CoreML, NCNN, LiteRT, ExecuTorch, RKNN, Sony IMX500 et TensorRT. Pour comparer les formats avant la mise en production, utilise le mode Benchmark. Pour consulter la liste complète des formats et des options, visite la documentation du mode Export et la page du guide des intégrations.
FAQ#
Tu peux exporter ton modèle avec
export(format="qnn", imgsz=640)(imgsz=224pour la classification) ou avec les arguments CLI équivalents. L'exportation crée d'abord un modèle ONNX, puis le compile localement en binaire de contexte QNN avec le fournisseur d'exécution QNN d'ONNX Runtime. Le paquetonnxruntime-qnnest installé automatiquement lors de la première exportation.Exemplefrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # utiliser imgsz=224 pour la classificationNon. L'exportation QNN s'effectue entièrement sur ta machine locale avec le paquet
onnxruntime-qnn, qui regroupe les bibliothèques QAIRT. Aucun compte Qualcomm, jeton API ou accès réseau n'est nécessaire.Qualcomm AI Hub est le service cloud de Qualcomm permettant de compiler, profiler et évaluer des modèles sur des appareils Snapdragon hébergés ; il nécessite un compte Qualcomm. L'exportation Ultralytics QNN cible le même environnement d'exécution QNN/QAIRT (CPU Snapdragon, GPU Adreno et NPU Hexagon), mais compile le binaire de contexte localement avec le fournisseur d'exécution QNN d'ONNX Runtime — sans compte, téléversement ni file d'attente. C'est le moyen le plus rapide de passer d'un modèle
.ptà une version prête pour Snapdragon, directement dans le flux de travail standard d'exportation YOLO.La version 2.4.0 et les versions ultérieures de
onnxruntime-qnnfournissent des roues précompilées pour Windows (x64 et ARM64) et Linux (x86-64 et ARM64) avec Python 3.11 ou une version ultérieure ; macOS n'est pas un hôte QNN pris en charge. La génération du binaire de contexte s'effectue sur un hôte x64 et ne nécessite pas d'appareil Snapdragon physique.Exporte avec
model.export(format="qnn", imgsz=640)(imgsz=224pour la classification), copie le fichieryolo26n_qnn.onnxobtenu sur ton appareil Snapdragon, puis lanceyolo predict model=yolo26n_qnn.onnx source=image.jpg(ouyolo val). Ultralytics charge le binaire de contexte via le fournisseur d'exécution QNN d'ONNX Runtime et l'exécute sur le NPU Hexagon — consulte Déployer les modèles YOLO QNN exportés.QNN (Qualcomm AI Engine Direct, qui fait partie du SDK QAIRT) est la pile d'inférence actuelle de Qualcomm et le remplacement recommandé pour l'ancien SDK Snapdragon de traitement neuronal (SNPE). Les nouveaux déploiements devraient cibler QNN.
Oui, sur un appareil Qualcomm Snapdragon où
onnxruntime-qnnest installé :YOLO("yolo26n_qnn.onnx")charge le binaire de contexte via le fournisseur d'exécution QNN et exécutepredict/valcomme n'importe quel autre format. Sur un hôte x86 dépourvu de matériel QNN, le modèle ne peut pas s'exécuter, car le binaire de contexte cible le NPU Snapdragon.L'exportation crée un fichier ONNX autonome contenant le binaire de contexte (par exemple,
yolo26n_qnn.onnx), avec les noms des classes, la taille de l'image, la tâche et d'autres métadonnées du modèle intégrés dans ONNXmetadata_props.