Segmentation sémantique avec Ultralytics YOLO#
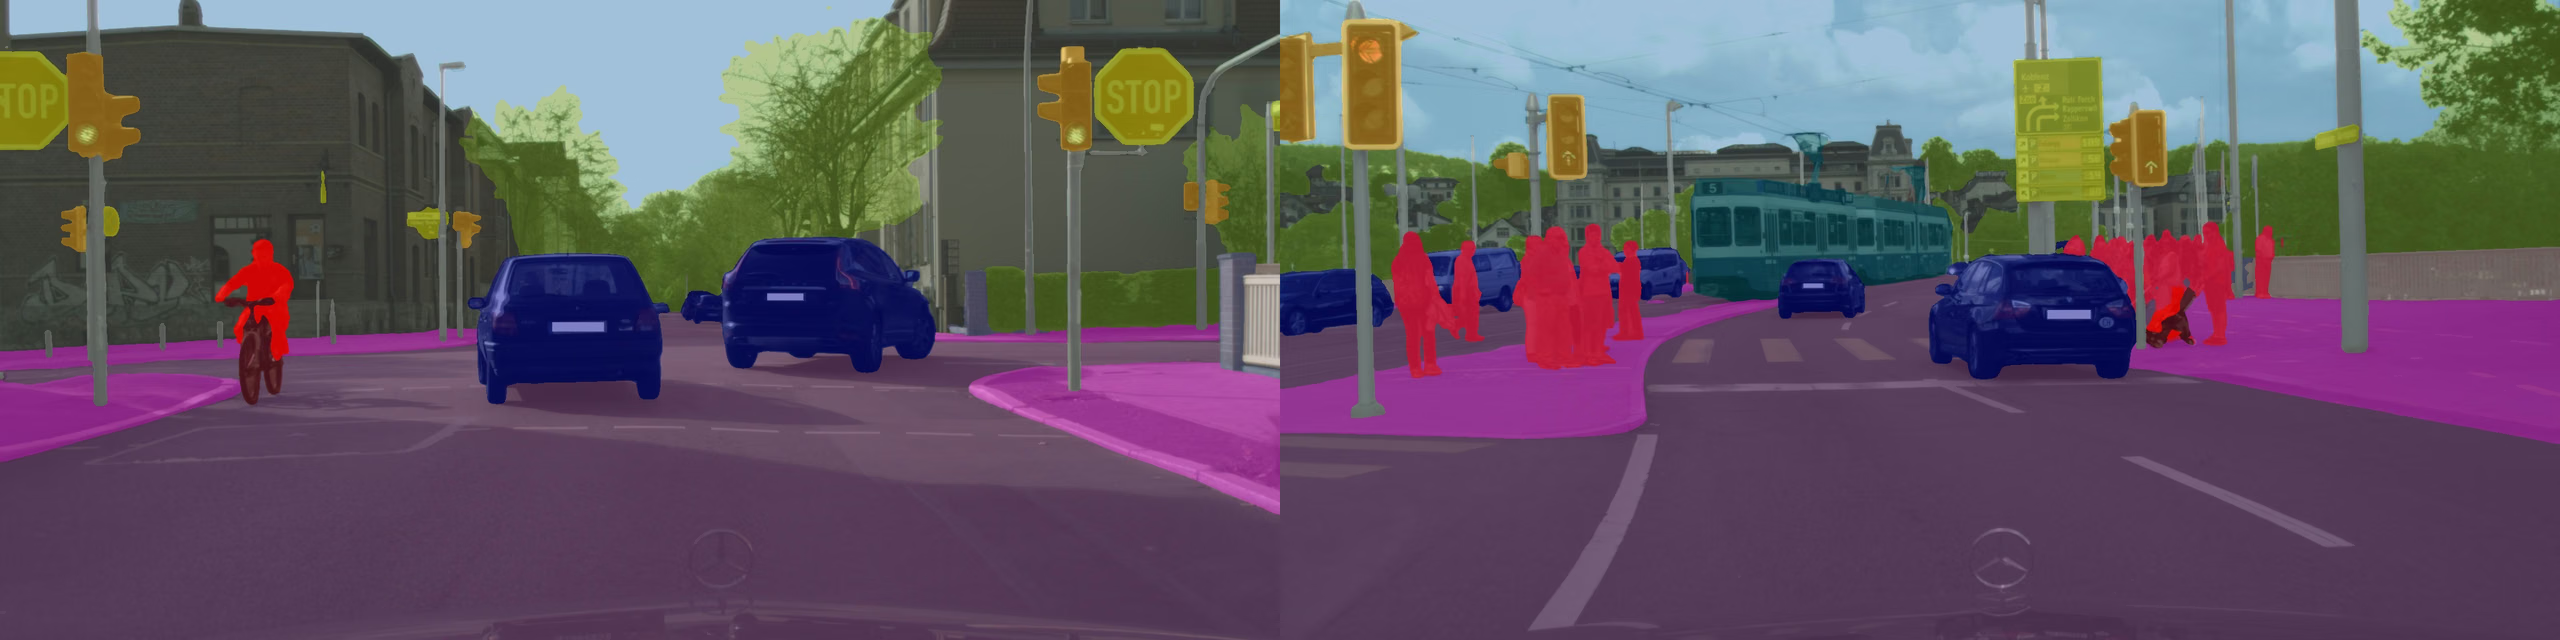
La segmentation sémantique attribue une étiquette de classe à chaque pixel d'une image et produit une carte de classes dense couvrant toute la scène. Contrairement à la segmentation d'instances, qui sépare les objets individuels, la segmentation sémantique regroupe tous les pixels d'une même classe, quel que soit le nombre d'objets distincts présents.
Watch: Semantic Segmentation with Ultralytics YOLO26 | Quickstart Tutorial
La sortie d'un modèle de segmentation sémantique est une carte de classes unique, de hauteur par largeur, où chaque valeur de pixel correspond à un ID de classe prédit. Cela rend la segmentation sémantique idéale pour les tâches d'analyse de scènes telles que la conduite autonome, l'imagerie médicale et la cartographie de l'occupation des sols.
Utilise la tâche task=semantic ou la tâche CLI yolo semantic pour la segmentation sémantique. Les fichiers de modèles de segmentation sémantique YOLO26 utilisent le suffixe -sem, comme dans yolo26n-sem.pt.
Modèles#
Les modèles de segmentation sémantique YOLO26 préentraînés sur le jeu de données Cityscapes sont présentés ci-dessous.
Les modèles sont automatiquement téléchargés depuis la dernière version d’Ultralytics lors de la première utilisation.
| Modèle | taille (pixels) | mIoUval | Vitesse RTX3090 PyTorch (ms) | paramètres (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- Les valeurs de mIoUval correspondent à un modèle unique et une seule échelle sur l'ensemble de validation Cityscapes.
Reproduis-les avecyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - Les métriques de vitesse sont moyennées sur les images de validation Cityscapes à l'aide d'une instance RTX3090.
Reproduis-les avecyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - Les valeurs de Params et de FLOPs correspondent au modèle fusionné après
model.fuse(), qui fusionne les couches Conv et BatchNorm. Les checkpoints préentraînés conservent l'architecture complète d'entraînement et peuvent donc afficher des valeurs plus élevées.
Les modèles de segmentation sémantique YOLO26 préentraînés sur le jeu de données ADE20K sont présentés ci-dessous.
Les modèles sont automatiquement téléchargés depuis la dernière version d’Ultralytics lors de la première utilisation.
| Modèle | taille (pixels) | mIoUval | Vitesse RTX3090 PyTorch (ms) | paramètres (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- Les valeurs de mIoUval correspondent à un modèle unique et une seule échelle sur l'ensemble de validation ADE20K.
Reproduis-les avecyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640, en remplaçantyolo26n-sem-ade20k.ptpar le checkpointyolo26*-sem-ade20k.ptsouhaité. - Les métriques de vitesse sont moyennées sur les images de validation ADE20K à l'aide d'une instance RTX3090.
Reproduis-les avecyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640, en remplaçantyolo26n-sem-ade20k.ptpar le checkpointyolo26*-sem-ade20k.ptsouhaité. - Les valeurs de Params et de FLOPs correspondent au modèle fusionné après
model.fuse(), qui fusionne les couches Conv et BatchNorm. Les checkpoints préentraînés conservent l'architecture complète d'entraînement et peuvent donc afficher des valeurs plus élevées.
Consulte l'aperçu non publié de YOLO27 pour les résultats préliminaires du mIoU sur Cityscapes.
Entraîner#
Entraîne YOLO26n-sem sur le jeu de données Cityscapes8 pendant 100 époques, avec une taille d'image de 1024. Pour obtenir la liste complète des arguments disponibles, consulte la page Configuration.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.yaml")  # build a new model from YAML
model = YOLO("yolo26n-sem.pt")  # load a pretrained model (recommended for training)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # build from YAML and transfer weights

# Train the model
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Consulte tous les détails du mode train sur la page Entraînement. Les modèles de segmentation sémantique peuvent également être entraînés avec l'entraînement cloud d'Ultralytics Platform.
Format du dataset#
Les jeux de données de segmentation sémantique utilisent des images de masques à canal unique, généralement au format PNG, où chaque valeur de pixel représente un ID de classe. Les pixels dont la valeur est 255 sont traités comme « ignore » et exclus du calcul de la perte. Le fichier YAML du jeu de données doit indiquer les chemins vers les images et leurs répertoires de masques correspondants. Consulte le guide des jeux de données de segmentation sémantique pour les détails sur le format. Les jeux de données pris en charge incluent Cityscapes et ADE20K. Tu peux gérer et annoter des jeux de données sémantiques avec l'annotation Ultralytics Platform.
Validation#
Évalue la précision d'un modèle YOLO26n-sem entraîné sur un jeu de données de segmentation sémantique. Passe explicitement data afin que l'évaluation utilise le fichier YAML du jeu de données prévu.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Validate the model
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # mean Intersection over Union
metrics.pixel_accuracy # overall pixel accuracyPrédiction#
Utilise un modèle YOLO26n-sem entraîné pour effectuer des prédictions sur des images.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Predict with the model
results = model("https://ultralytics.com/images/bus.jpg")  # predict on an image

# Access the results
for result in results:
    semantic_mask = result.semantic_mask.data  # class map, shape (H,W), integer dtype selected by class count
Consulte les détails complets du mode predict dans la page Prédiction.
Sortie des résultats#
La segmentation sémantique YOLO renvoie un objet Results par image. Chaque résultat stocke une carte de classes dense pour l'image entière
plutôt qu'une liste de masques d'objets. Les pixels ayant la même classe prédite partagent le même ID de classe, même lorsqu'ils
appartiennent à des objets distincts.
| Attribut | Type | Forme | Description |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Carte dense des classes. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | ID de classe ; dtype sélectionné en fonction du nombre de classes. |
result.masks | - | - | Aucun masque d’instance. |
result.boxes | - | - | Aucune boîte ni confiance d’instance. |
result.masks.xy | - | - | Aucun polygone par défaut. |
Pour connaître les champs Results spécifiques à chaque tâche, consulte la section Résultats des prédictions par tâche.
La segmentation sémantique prédit une carte de classes dense, puis redimensionne cette carte aux dimensions de l'image pour la visualisation et
l'utilisation en aval. Les structures très fines, telles que les marquages de voie, les lignes de terrain, les poteaux ou les câbles, peuvent donc paraître
en escalier lorsque l'inférence s'exécute avec un imgsz bien inférieur à la résolution de l'image d'origine. Si les contours semblent
irréguliers, teste d'abord à nouveau le modèle PyTorch natif .pt avec un imgsz plus grand, comme 1024, 1280, ou la valeur pratique la plus proche
possible de la taille de l'image source. Utilise les modèles exportés uniquement après avoir confirmé que la sortie .pt est acceptable,
car des entrées de résolution inférieure ne peuvent pas récupérer les détails fins absents de la carte de classes prédite.
Segmentation d'instances et segmentation sémantique#
| Aspect | Segmentation d'instances (task="segment") | Segmentation sémantique (task="semantic") |
|---|---|---|
| Objectif de la prédiction | Segmenter chaque objet détecté séparément | Attribuer un ID de classe à chaque pixel |
| Champ de sortie | result.masks | result.semantic_mask |
| Données principales | result.masks.data | result.semantic_mask.data |
| Forme | (N,H,W) | (H,W) |
| Valeurs des pixels | Valeurs de masque binaire : 0 ou 1 | ID de classe : 0, 1, 2, ... |
| Dtype | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Objets d'une même classe | Conservés comme instances distinctes | Fusionnés dans la même région de classe |
| Polygones | Oui, via result.masks.xy et result.masks.xyn | Aucune sortie polygonale par défaut |
| Boîtes et confiance | Oui, via result.boxes | Aucune boîte ni score de confiance par instance |
| Utilisation typique | Comptage, suivi, recadrage, mesure au niveau des objets | Étiquetage dense de scènes, zones carrossables, occupation des sols, régions médicales |
Exportation#
Exporte un modèle YOLO26n-sem vers un autre format tel que ONNX, CoreML, etc.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Export the model
model.export(format="onnx")
Les formats d'exportation disponibles pour la segmentation sémantique YOLO26 sont présentés dans le tableau ci-dessous. Tu peux exporter vers n'importe quel format à l'aide de l'argument format, c'est-à-dire format='onnx' ou format='engine'. Tu peux effectuer directement des prédictions ou des évaluations sur les modèles exportés, par exemple avec yolo predict model=yolo26n-sem.onnx. Des exemples d'utilisation sont présentés pour ton modèle une fois l'exportation terminée.
| Format | Argument format | Modèle | Métadonnées | Arguments |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, keras, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
nms=None utilise par défaut des sorties brutes pour NMS externe. Définis nms=False pour sélectionner une tête sans NMS disponible ; les formats non pris en charge reviennent à leur chemin de sortie natif. Les entrées nms ci-dessus identifient les formats capables d'intégrer NMS avec nms=True.
Consulte les détails complets du mode export dans la page Exportation.
FAQ#
La segmentation d'instances et la segmentation sémantique sont toutes deux des tâches au niveau du pixel, mais elles diffèrent sur un point essentiel :
- La segmentation sémantique attribue une étiquette de classe à chaque pixel, mais ne distingue pas les objets individuels d'une même classe. Par exemple, toutes les voitures d'une scène partagent la même étiquette de classe.
- La segmentation d'instances identifie chaque objet individuel séparément et produit des masques distincts pour chaque objet, même s'ils appartiennent à la même classe.
La segmentation sémantique convient particulièrement aux tâches de compréhension de scènes comme la conduite autonome et la cartographie de l'occupation des sols, tandis que la segmentation d'instances est préférable lorsque le comptage ou le suivi des objets individuels est important.
Oui. Si ton jeu de données utilise des annotations polygonales Ultralytics YOLO (un
.txtpar image), ometmasks_dirdu fichier YAML du jeu de données et vérifie qu'aucun dossiermasks/n'existe à côté de tes images à la racine du jeu de données (sa seule présence active le mode des masques PNG, même simasks_dirn'est pas défini). Le chargeur convertit alors automatiquement les polygones en masques sémantiques par image. Pour les jeux de données multiclasse (N > 1), une classebackgroundsupplémentaire est automatiquement ajoutée ànames. Pour les jeux de données à classe unique (N == 1), l'entraînement reste à 1 classe : ta classe déclarée devient1dans le masque et les pixels non couverts deviennent0. Consulte le guide des jeux de données de segmentation sémantique pour plus de détails.Ultralytics YOLO26 fournit des configurations intégrées pour plusieurs jeux de données de segmentation sémantique :
- Cityscapes : scènes de rues urbaines comportant 19 classes, largement utilisées pour la recherche sur la conduite autonome.
- ADE20K : jeu de données d'analyse de scènes à grande échelle comportant 150 classes.
Tu peux également utiliser n'importe quel jeu de données personnalisé fournissant des annotations de masques PNG dans lesquelles les valeurs des pixels correspondent aux ID de classe.
Évalue un modèle de segmentation sémantique YOLO26 préentraîné avec le fichier YAML du jeu de données utilisé pour l'évaluation :
Exemplefrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Validate the model metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Ces étapes te fourniront des métriques d'évaluation telles que l'intersection moyenne sur union (mIoU) et la précision au niveau du pixel, qui sont des mesures standard pour évaluer les performances de la segmentation sémantique.
Exporte un modèle de segmentation sémantique YOLO26 au format ONNX avec des commandes Python ou CLI :
Exemplefrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Export the model to ONNX format model.export(format="onnx")Pour plus de détails sur l’exportation vers différents formats, consulte la page Exportation.
Pour entraîner un modèle de segmentation sémantique YOLO26 sur un jeu de données personnalisé, tu dois préparer des images de masques PNG où chaque valeur de pixel représente un ID de classe (0, 1, 2, ...) et où les pixels dont la valeur est 255 sont ignorés pendant l'entraînement. Crée un fichier YAML de jeu de données indiquant les répertoires de tes images et de tes masques, puis entraîne le modèle :
Consulte la page Configuration pour découvrir les autres arguments disponibles.