Estimation monoculaire de la profondeur avec Ultralytics YOLO#
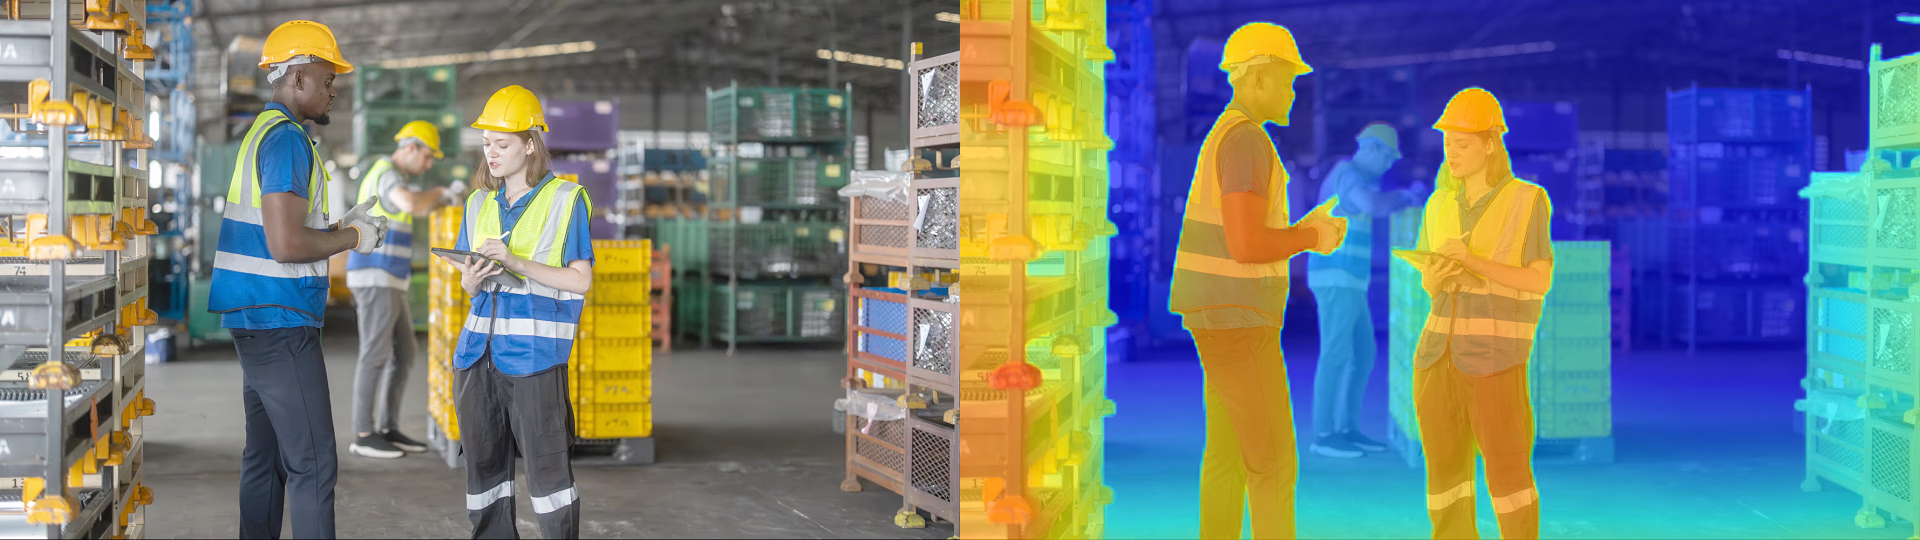
L'estimation monoculaire de la profondeur prédit une carte de profondeur par pixel à partir d'une seule image RGB. Chaque pixel de sortie contient une valeur de profondeur en mètres représentant la distance estimée entre la caméra et le point de surface correspondant.
La sortie d'un modèle de profondeur est une carte dense de nombres flottants de forme (H, W), alignée sur l'image d'entrée. Cette représentation par pixel rend l'estimation monoculaire de la profondeur particulièrement adaptée à la reconstruction de scènes 3D, à la navigation des robots, à la création de contenu AR/VR et à toute application nécessitant une disposition spatiale à partir d'une seule caméra.
Regarder : Estimation monoculaire de la profondeur avec Ultralytics YOLO26 | Tutoriel Python | Vision par IA 🚀
Utilise task=depth ou la tâche CLI yolo depth pour l'estimation monoculaire de la profondeur. Les fichiers des modèles de profondeur YOLO26 portent le suffixe -depth, par exemple yolo26n-depth.pt.
Modèles#
Les modèles de profondeur YOLO26 préentraînés sur un vaste mélange de plusieurs jeux de données (intérieur + extérieur, ~2.19M images) sont présentés ci-dessous. Les colonnes de métriques correspondent au découpage de test Eigen de NYU Depth V2.
Les modèles sont automatiquement téléchargés depuis la dernière version d’Ultralytics lors de leur première utilisation.
| Modèle | taille (pixels) | delta1NYU | abs_relNYU | rmseNYU | Vitesse CPU ONNX (ms) | Vitesse T4 TensorRT10 (ms) | paramètres (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU est la proportion de pixels pour lesquels la profondeur prédite se situe dans un facteur de 1.25 de la vérité terrain, sur le découpage de test Eigen de NYU Depth V2 (654 images), avec TTA à plusieurs échelles et retournement horizontal, et alignement par moindres carrés logarithmiques.
- La précision à une seule échelle sans TTA peut être reproduite avec
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0(remplacemodel=par chaque taille), qui utilise un alignement médian (échelle uniquement) et obtient des scores plus faibles : delta1 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel est l'erreur relative absolue moyenne entre les valeurs de profondeur prédites et celles de la vérité terrain.
- rmse est la racine de l'erreur quadratique moyenne, en mètres.
- Vitesse correspond à la latence d'inférence uniquement (hors prétraitement et post-traitement) à
imgsz=768,batch=1, rapportée comme moyenne ± écart-type sur les exécutions chronométrées après échauffement. CPU ONNX correspond à ONNX Runtime fp32 sur un Intel Xeon à 32 cœurs (Skylake) ; T4 TensorRT10 correspond à TensorRT fp16 sur une Tesla T4. - params et FLOPs sont mesurés à 768×768, la résolution d'entraînement des poids publiés.
Consulte l'aperçu non publié de YOLO27 pour les résultats préliminaires sur NYU Depth V2.
Vitesse comparée à Depth Anything V2#
Depth Anything V2 est une référence ouverte largement utilisée pour la profondeur monoculaire. Son backbone DINOv2 vision transformer et son décodeur DPT nécessitent beaucoup de calcul ; sur la même Tesla T4 avec TensorRT fp16, le plus petit modèle publié de Depth Anything V2 est donc plus lent que tous les modèles de profondeur YOLO26 — y compris YOLO26x-depth, qui compte plus de deux fois plus de paramètres.
À ~768 px — imgsz=768 pour YOLO26, la résolution d'entraînement de ses poids publiés, et 770 px pour Depth Anything V2, dont le backbone DINOv2 nécessite un multiple de sa taille de patch de 14 :
| Modèle | paramètres (M) | FLOPs (B) | T4 TensorRT10 (ms) | FPS | Accélération par rapport à V2 Small | Accélération par rapport à V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
À ~640 px — imgsz=640 et 644 px respectivement — le classement reste inchangé, et YOLO26n-depth est 5.9× plus rapide que Depth Anything V2 Small :
| Modèle | T4 TensorRT10 (ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- La latence correspond à l'inférence uniquement,
batch=1, TensorRT fp16 sur une Tesla T4 — le même banc de test que pour le tableau des modèles ci-dessus, affichée ici avec deux décimales ; les FPS sont l'inverse de la latence non arrondie. Les colonnes Accélération divisent les latences de Depth Anything V2 Small (20.99 ms) et Base (55.40 ms) par la latence de YOLO26. - Depth Anything V2 Small et Base sont les points de contrôle ViT-S et ViT-B publiés.
- La comparaison porte uniquement sur la latence : les deux familles de modèles ne sont pas évaluées ici selon un protocole de précision commun.
Plage de profondeur et tête de profondeur logarithmique#
La tête de profondeur prédit exp(logit) — sans limite (~0.02–150 m) — et découple la forme de la scène de l'échelle absolue : le réseau prédit un champ de profondeur logarithmique relative, et les mètres absolus sont définis par une transformation distincte à deux paramètres (exp(a·log d + b)), obtenue lors de l'évaluation, par un étalonnage léger ou par un ajustement fin. L'alternative courante, une tête sigmoid × max_depth bornée, intègre plutôt un plafond fixe dans l'architecture, de sorte que toute profondeur supérieure à max_depth est écrêtée — ce qui empêche l'entraînement sur des scènes à plus longue portée et leur prédiction.
Comparaison A/B contrôlée — mêmes données, même planification, seule la tête diffère. En entraînant les deux têtes depuis zéro sur un mélange identique de données d'intérieur (≤10 m) et d'extérieur (≤80 m) :
| Tête | Plage de sortie | δ1 de validation sur plage mixte | Comportement à l'entraînement |
|---|---|---|---|
sigmoid × max_depth (10 m) | bornée de 0 à 10 m | 0.221 | plafonne à l'époque 1 |
log (sans limite) | 0–~150 m | 0.367 (+66%) | continue de s'améliorer |
La tête bornée ne peut pas représenter la majorité des pixels extérieurs à plus de 10 m et cesse donc presque immédiatement de s'améliorer ; la tête log apprend à partir de toute la plage.
Le problème corrigé — ajustement fin sur un seul jeu de données, stratifié par plage. L'ajustement fin d'une tête bornée (10 m) sur des jeux de données individuels fonctionne lorsque les données respectent la limite, mais échoue lorsqu'elles la dépassent :
| Jeu de données | Plage de profondeur | δ1 de la tête bornée |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | principalement ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 — l'écart d'échelle 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
L'effondrement se produit précisément à la limite supérieure. La tête log n'a pas cette limite.
Modèles publiés — performances sur différentes plages. La famille publiée de têtes log, évaluée sur des benchmarks couvrant de 10 m (NYU, iBims-1) à 80 m (KITTI), avec δ1 aligné sur l'échelle :
| Benchmark | Plage | YOLO26x-depth (log) | ancienne version à tête bornée |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Moyenne | — | 0.819 | 0.799 |
Les deux colonnes sont telles que publiées. Les autres lignes sont évaluées selon le protocole TTA et moindres carrés logarithmiques décrit sur les pages de leurs jeux de données, que le validateur de ce dépôt n'implémente pas ; la ligne KITTI ne peut donc pas être réévaluée dans les mêmes conditions. La page KITTI présente plutôt les chiffres mesurés sur le découpage Eigen canonique de 652 images.
Les gains les plus importants concernent les benchmarks extérieurs à plus longue portée (KITTI, ETH3D) — précisément ceux où un plafond fixe de 10 m pénalise le plus — tandis que les performances en intérieur sont conservées.
Entraînement#
Entraîne YOLO26n-depth sur le jeu de données Depth8 pendant 100 époques avec une taille d'image de 640. Pour consulter la liste complète des arguments disponibles, voir la page Configuration.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-depth.yaml")  # créer un nouveau modèle à partir du fichier YAML
model = YOLO("yolo26n-depth.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # créer à partir du fichier YAML et transférer les poids

# Entraîner le modèle
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Consulte la page Entraînement pour obtenir tous les détails du mode train. Les modèles de profondeur peuvent également être entraînés avec l'entraînement cloud d'Ultralytics Platform.
Format du jeu de données#
Les jeux de données d'estimation de profondeur associent chaque image RGB à une carte de profondeur PNG uint16 mise à l'échelle ou à une carte de profondeur NPY à virgule flottante en mètres. Par défaut, les valeurs PNG sont en millimètres ; pour les jeux de données utilisant une autre convention, définis depth_scale dans leur YAML. Le chargeur déduit le chemin de la carte de profondeur en remplaçant le composant images par depth, en privilégiant .png et en utilisant .npy à défaut.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Par exemple, une image à images/train/scene_001.jpg est associée à une carte de profondeur à depth/train/scene_001.png. Consulte le Guide des jeux de données d'estimation de profondeur pour connaître toutes les spécifications du format.
Ajustement fin sur tes propres données#
Lorsque tu adaptes un modèle de profondeur préentraîné à un jeu de données personnalisé, réduis le taux d'apprentissage et utilise l'optimiseur AdamW. Les paramètres d'optimiseur par défaut sont réglés pour un entraînement depuis zéro ; appliqués à un modèle de profondeur déjà convergé, ils peuvent écraser les connaissances préentraînées et dégrader les résultats — en particulier lors d'un ajustement fin sur un seul domaine.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # partir de poids préentraînés

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100x en dessous de la valeur par défaut pour un entraînement depuis zéro
    warmup_bias_lr=1e-4,  # garder aussi un warmup progressif
)
Conseils supplémentaires :
- L’augmentation est contrôlée par les arguments standard (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v) ; la déformation géométrique et les retournements sont appliqués de la même manière à la carte de profondeur associée. Pour voir la recette exacte utilisée pour les poids YOLO26-Depth publiés, examine letrain_argsenregistré dans le checkpoint — voir Inspection des arguments d’entraînement d’un checkpoint YOLO26. mosaic,mixup,cutmixetcopy_pastene sont pas implémentés pour la profondeur. Le chargeur du jeu de données de profondeur définit automatiquement ces probabilités sur 0 ; les transmettre n’a donc aucun effet. Ces augmentations ne sont pas prises en charge, car elles combinent plusieurs images, ce qui produirait des cartes de profondeur associées invalides.- Toutes les plages de profondeur fonctionnent directement. Les modèles
logprédisent une profondeur non bornée ; ils s’adaptent donc aux données à courte portée (macro) ou à longue portée (extérieur/conduite) sans modification. Définirmax_depth:dans le YAML de ton jeu de données (en mètres) délimite les pixels GT pris en compte dans les métriques de validation. - Préserver les performances générales. Si tu veux que le modèle reste précis sur des scènes qui ne figurent pas dans ton jeu d’entraînement, ajoute une petite proportion (~5–10 %) d’images généralistes variées à tes données d’entraînement ; cela réduit considérablement l’oubli pendant le fine-tuning.
- Entraîner depuis zéro (
model=yolo26s-depth.yaml) uniquement si ton domaine est très différent et que tu disposes d’un grand jeu de données — dans ce cas, la valeur par défautoptimizer=autoconvient, puisqu’il n’y a pas de poids préentraînés à préserver.
Calibrer l’échelle de profondeur#
La tête de profondeur distingue la forme (structure relative de la scène) de l’échelle (mètres absolus). Si un modèle produit déjà une bonne profondeur relative pour tes scènes, mais que les valeurs absolues ne correspondent pas à ta caméra, tu peux corriger l’échelle en quelques secondes avec model.calibrate() — un ajustement de forme fermée, limité à l’échelle, de la transformation log-affine de la tête sur un petit ensemble annoté, conservé uniquement s’il améliore δ1 sur les données de validation croisée mises de côté, sans entraînement par gradient ni modification des poids du réseau ; la structure relative ne peut donc pas se dégrader.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Ajuster l’échelle sur une partition annotée (~100 images ou plus suffisent), puis la conserver
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
La calibration nécessite une profondeur de référence pour effectuer l’ajustement ; elle s’exécute donc sur une partition annotée — elle ne peut pas avoir lieu lors d’une inférence à l’aveugle. Elle ajuste et évalue les mêmes pixels que ceux utilisés pour les métriques de validation : les valeurs GT supérieures ou égales à max_depth du YAML du jeu de données (100 m par défaut) sont exclues. Utilise-la lorsque la profondeur relative est déjà bonne et que seule l’échelle/plage est incorrecte ; si la structure relative elle-même doit changer pour ton domaine, effectue plutôt un fine-tuning.
L’entraînement s’en charge automatiquement : une fois model.train(...) terminé, les meilleurs checkpoints et les derniers checkpoints sont calibrés sur le jeu de validation afin de produire directement une profondeur à l’échelle métrique.
Les checkpoints yolo26*-depth.pt publiés intègrent déjà cette calibration, ajustée sur le mélange de validation du préentraînement. Il s’agit d’une échelle globale unique pour tous les domaines ; pour obtenir la profondeur absolue la plus précise avec une caméra ou un type de scène donné, exécute model.calibrate() sur une petite partition annotée de tes propres données — cela remplace l’ajustement intégré.
Obtenir une profondeur de vérité terrain sans caméra de profondeur#
Si ta caméra n’a pas de capteur de profondeur, tu peux tout de même la calibrer. La calibration ajuste une échelle globale et ignore les pixels dont la profondeur est égale à 0 : quelques points mesurés par image suffisent donc.
-
Collecte des images. Prends 50 à 150 images avec ta caméra à la résolution et avec les réglages d’objectif que tu utiliseras en production, puis place-les dans
dataset/images/val/. La calibration lit la partitionval. -
Annote la profondeur. Utilise l’une des deux méthodes ci-dessous. Les deux enregistrent une carte de profondeur par image dans
dataset/depth/val/, au format du jeu de données.
Mesure la distance jusqu’à quelques points de chaque image à l’aide d’un télémètre laser ou d’un mètre ruban, sur des surfaces planes éloignées des contours des objets, puis note la position en pixels de chaque point dans points.csv :
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
Écris ensuite les cartes de profondeur en laissant à 0 tous les pixels non mesurés. Chaque point est représenté par un petit disque afin qu’il subsiste après le redimensionnement vers imgsz :
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Un télémètre mesure la distance en ligne droite jusqu’à un point, tandis que les cartes de profondeur stockent la distance le long de l’axe optique de la caméra. Les deux mesures correspondent au centre de l’image et diffèrent d’environ 3,5 % à 15° du centre. Mesure donc des points près du centre ou convertis chaque lecture avec meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) en utilisant les paramètres intrinsèques de ta caméra.
-
Écris le YAML du jeu de données sous le nom
calib.yaml.depth_scale: 100lit les PNG en centimètres issus des points mesurés et est ignoré pour les cartes NPY :path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Effectue la calibration et enregistre-la, puis charge
yolo26s-depth-calibrated.ptpour la prédiction ou l’exportation :from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
Lors de tests avec yolo26s-depth.pt et 150 images par caméra, la calibration publiée présentait un écart de 4 % à 46 % par rapport à l’ajustement d’échelle réalisé sur les données de vérité terrain complètes pour NYU, KITTI et une caméra à objectif étroit. Une calibration basée sur 5 points mesurés par image s’approchait à moins de 1 % de cet ajustement, et une calibration basée sur les annotations DA3METRIC-LARGE, à moins de 7 %. Ajouter des images est plus utile qu’ajouter des points par image : 150 images avec 1 point chacune s’approchaient à environ 3 %, tandis que 20 images avec 5 points chacune présentaient un écart pouvant atteindre 9 %.
Validation#
Évalue la précision d’un modèle YOLO26n-depth entraîné sur un jeu de données d’estimation de profondeur. Passe explicitement data afin que l’évaluation utilise le YAML du jeu de données voulu. Les poids publiés sont entraînés à imgsz=768 sur des images étirées au format carré plutôt que redimensionnées avec des bandes de remplissage. Pour obtenir la meilleure précision, effectue donc l’évaluation et la prédiction à cette taille. La prédiction, l’évaluation et model.calibrate() étirent toutes l’image d’entrée de la même manière.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-depth.pt")  # charger un modèle officiel
model = YOLO("path/to/best.pt")  # charger un modèle personnalisé

# Valider le modèle
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # fraction de pixels sous le seuil δ=1.25
metrics.abs_rel  # erreur relative absolue moyenne
metrics.rmse  # racine de l’erreur quadratique moyenne (mètres)
metrics.silog # erreur logarithmique invariante à l’échellePrédiction#
Utilise un modèle YOLO26n-depth entraîné pour effectuer des prédictions sur des images.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-depth.pt")  # charger un modèle officiel
model = YOLO("path/to/best.pt")  # charger un modèle personnalisé

# Effectuer des prédictions avec le modèle
results = model("https://ultralytics.com/images/bus.jpg")  # effectuer une prédiction sur une image

# Accéder aux résultats
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, forme (H, W), mètres
Consulte les détails complets du mode predict sur la page Predict.
Sortie des résultats#
L’estimation de profondeur YOLO renvoie un objet Results par image. Chaque résultat contient une carte de profondeur flottante dense couvrant l’image entière.
| Attribut | Type | Forme | Description |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Carte de profondeur dense, pixel par pixel. |
result.depth.data | torch.Tensor | (H,W) | Valeurs de profondeur en mètres ; appelle .cpu().numpy() pour obtenir un tableau NumPy. |
result.boxes | - | - | Aucune boîte d’instance. |
result.masks | - | - | Aucun masque d’instance. |
Pour connaître les champs Results propres à chaque tâche, consulte la section Résultats des prédictions par tâche.
Profondeur par objet avec segmentation d’instance#
Combine la segmentation d’instance à la profondeur pour estimer la distance de chaque objet détecté. Exécute les deux modèles sur la même image avec retina_masks=True afin que les masques partagent la résolution de la carte de profondeur de l’image d’origine, puis calcule la médiane des pixels de profondeur valides à l’intérieur de chaque masque.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
La médiane résiste bien aux pixels d’arrière-plan situés aux bords des masques, mais elle décrit la surface visible de l’objet plutôt que son centre, et sa précision dépend de l’échelle de profondeur du modèle (voir Calibrer l’échelle de profondeur).
Coloriser la carte de profondeur#
La carte de profondeur brute est un tableau flottant à un seul canal, exprimé en mètres — utile pour les calculs, mais difficile à lire directement. Pour la convertir en image couleur, utilise l’assistant colorize_depth dans ultralytics.utils.plotting, qui transforme le tableau de profondeur (H, W) en image BGR uint8 au format (H, W, 3) (les pixels invalides <= 0 sont affichés en noir).
result.plot() superpose déjà cette colorisation à l’image d’entrée en utilisant les valeurs par défaut (cmap="jet", mode="disparity") ; appelle directement colorize_depth si tu veux une image de profondeur colorisée autonome, une autre palette de couleurs ou une autre normalisation.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Coloriser avec le proche en teintes chaudes et enregistrer
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Fixer la plage à 0–20 m pour que la même couleur corresponde à la même distance d’une image à l’autre
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Superposition fusionnée directement depuis l’objet Results (utilise cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Toutes les palettes de couleurs vont des tons froids/sombres aux tons chauds/lumineux. mode détermine quelle extrémité correspond au proche, et vmin/vmax fixe la plage d’une image à l’autre afin qu’une couleur corresponde toujours à la même distance.
| Argument | Valeur | Description |
|---|---|---|
cmap | jet (par défaut) | Contraste élevé, du bleu au vert puis au rouge, la palette utilisée par result.plot(). |
cmap | inferno | Du noir au violet, puis à l’orange et au jaune. Uniforme sur le plan perceptuel, adaptée aux personnes daltoniennes et lisible en niveaux de gris. |
cmap | spectral | Du rouge au jaune, puis au vert et au bleu (Spectral_r de matplotlib). |
mode | disparity (par défaut) | Normalise la profondeur inverse (1/d) entre les 2e et 98e percentiles ; les teintes chaudes indiquent le proche et les valeurs aberrantes éloignées sont absorbées. |
mode | metric | Normalise linéairement la profondeur en mètres entre vmin et vmax ; les teintes chaudes indiquent le lointain, les couleurs représentent donc les distances réelles. |
Export#
Exporter un modèle YOLO26n-depth vers un autre format comme ONNX, CoreML, etc.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-depth.pt")  # charger un modèle officiel
model = YOLO("path/to/best.pt")  # charger un modèle personnalisé

# Exporter le modèle
model.export(format="onnx")
Les formats d’export disponibles pour l’estimation de la profondeur avec YOLO26 figurent dans le tableau ci-dessous. Tu peux exporter vers n’importe quel format à l’aide de l’argument format, par exemple format='onnx' ou format='engine'. Tu peux effectuer des prédictions ou valider directement sur les modèles exportés, par exemple yolo predict model=yolo26n-depth.onnx. Des exemples d’utilisation de ton modèle s’affichent une fois l’export terminé.
| Format | Argument format | Modèle | Métadonnées | Arguments |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None produit par défaut des sorties brutes pour la NMS externe. Définis nms=False pour sélectionner une tête disponible sans NMS ; les formats non pris en charge utilisent leur voie de sortie native. Les entrées nms ci-dessus désignent les formats qui peuvent intégrer la NMS avec nms=True.
Consulte tous les détails de export sur la page Exportation.
FAQ#
Prépare des images RVB associées à des PNG de profondeur 16 bits ou à des cartes de profondeur NPY à virgule flottante en mètres, puis crée un YAML de jeu de données qui pointe vers ton répertoire
images/. Le chargeur trouve automatiquement les fichiers de profondeur en remplaçantimagespardepthdans le chemin, en privilégiant.pnget en utilisant.npyen solution de repli.Pars de poids préentraînés et utilise un faible taux d’apprentissage avec AdamW afin que le fine-tuning conserve les connaissances déjà acquises par le modèle (voir Fine-tuning sur tes propres données pour en savoir plus) :
Exemplefrom ultralytics import YOLO # Charger un modèle YOLO26 de profondeur préentraîné model = YOLO("yolo26s-depth.pt") # Effectuer un fine-tuning sur un jeu de données de profondeur personnalisé results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Consulte la page Configuration pour découvrir d’autres arguments disponibles.
La validation de l’estimation de la profondeur fournit le jeu de métriques utilisé par Depth Anything et les travaux connexes sur la profondeur monoculaire :
- delta1 / delta2 / delta3 — proportion de pixels pour lesquels le rapport entre la profondeur prédite et la profondeur de référence (ou son inverse) est inférieur à 1.25, 1.25² et 1.25³, respectivement. Plus la valeur est élevée, mieux c’est.
- abs_rel — erreur relative absolue moyenne. Plus la valeur est faible, mieux c’est.
- rmse — racine de l’erreur quadratique moyenne en mètres. Plus la valeur est faible, mieux c’est.
- silog — erreur logarithmique invariante à l’échelle. Plus la valeur est faible, mieux c’est.
Chaque prédiction est alignée sur la médiane de sa vérité terrain, image par image ; chaque métrique est calculée pour cette image, puis les résultats par image sont moyennés sur le jeu de validation, de sorte que chaque image ait le même poids, quel que soit le nombre de pixels de profondeur valides qu’elle contient. Les images ayant moins de 10 pixels de vérité terrain valides sont ignorées et ne sont pas incluses dans cette moyenne, car aligner la médiane de quelques pixels n’a pas de sens ; les prédictions non finies sont plutôt évaluées aux limites de profondeur. Cette méthode correspond à la moyenne par échantillon et au seuil minimal de 10 pixels utilisés par Depth Anything V2.
La carte de profondeur est stockée sous la forme d’un
torch.Tensorde forme(H, W), où chaque valeur correspond à la profondeur prédite en mètres (utiliseresult.depth.data.cpu().numpy()pour obtenir un tableau NumPyfloat32). Accède-y viaresult.depth.dataaprès avoir lancé la prédiction. La carte est alignée sur la résolution de l’image d’entrée.Ultralytics YOLO26 fournit des configurations YAML intégrées pour plusieurs jeux de données d’estimation de la profondeur, notamment NYU Depth V2, KITTI, Hypersim, SUN RGB-D et ARKitScenes. Consulte le Guide des jeux de données d’estimation de la profondeur pour obtenir la liste complète et les détails des formats.
Valide un modèle YOLO26 de profondeur préentraîné en fournissant le YAML du jeu de données utilisé pour l’évaluation :
Exemplefrom ultralytics import YOLO # Charger un modèle préentraîné model = YOLO("yolo26n-depth.pt") # Valider le modèle metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Exporte un modèle YOLO26 de profondeur vers ONNX avec Python ou la CLI :
Exemplefrom ultralytics import YOLO # Charger un modèle préentraîné model = YOLO("yolo26n-depth.pt") # Exporter le modèle au format ONNX model.export(format="onnx")Pour plus de détails sur l’exportation vers différents formats, consulte la page Exportation.