Intégration Azure Blob Storage
L’intégration Azure Blob Storage connecte les conteneurs de ton compte de stockage à Ultralytics Platform. Tes images restent dans tes conteneurs : Platform les indexe sur place, pour que tu puisses parcourir, annoter et entraîner des modèles YOLO sans en téléverser de copie. Lorsque les fonctionnalités d’IA sont activées, Platform peut également les utiliser pour l’annotation intelligente, l’annotation automatique, la recherche d’images similaires et l’entraînement dans le cloud.
Les jeux de données Azure Blob Storage nécessitent un forfait Pro ou Enterprise. Les espaces de travail gratuits voient l’intégration et sont invités à passer à un forfait supérieur lors de la connexion. Les jeux de données Azure Blob Storage existants restent entièrement accessibles si un abonnement prend fin ; seuls les nouvelles connexions et les nouveaux imports nécessitent Pro.
Obtenir une chaîne de connexion#
Platform lit tes blobs et n’en crée de nouveaux que pour la génération d’images ; il ne les modifie ni ne les supprime jamais. L’intégration actuelle nécessite une chaîne de connexion avec la clé d’accès au compte, qui accorde des privilèges à l’échelle du compte :
- Dans le portail Azure, ouvre ton compte de stockage.
- Accède à Security + networking > Access keys.
- Copie une connection string.
La chaîne doit contenir AccountName, AccountKey et HTTPS comme protocole — c’est le format qu’Azure fournit sous Access keys. Les chaînes de connexion avec jeton SAS, qui contiennent SharedAccessSignature à la place de AccountKey, sont refusées.
Les connexions utilisent le point de terminaison standard blob.core.windows.net. Les clouds souverains (Azure China, Azure Government) et les points de terminaison blob personnalisés ne sont pas pris en charge.
Se connecter à Platform#
- Accède à Settings > Integrations et sélectionne Azure Blob Storage dans la liste des intégrations.
- Colle la chaîne de connexion.
- Clique sur Find available containers, puis sélectionne les conteneurs à connecter. Tu peux aussi saisir manuellement le nom d’un conteneur.
- Clique sur Connect. Avant tout enregistrement, Platform vérifie qu’il peut répertorier et lire chaque conteneur sélectionné. Les clés de compte peuvent toujours créer des blobs ; les conteneurs connectés ou reconnectés depuis le lancement de la génération d’images autorisent donc les écritures.
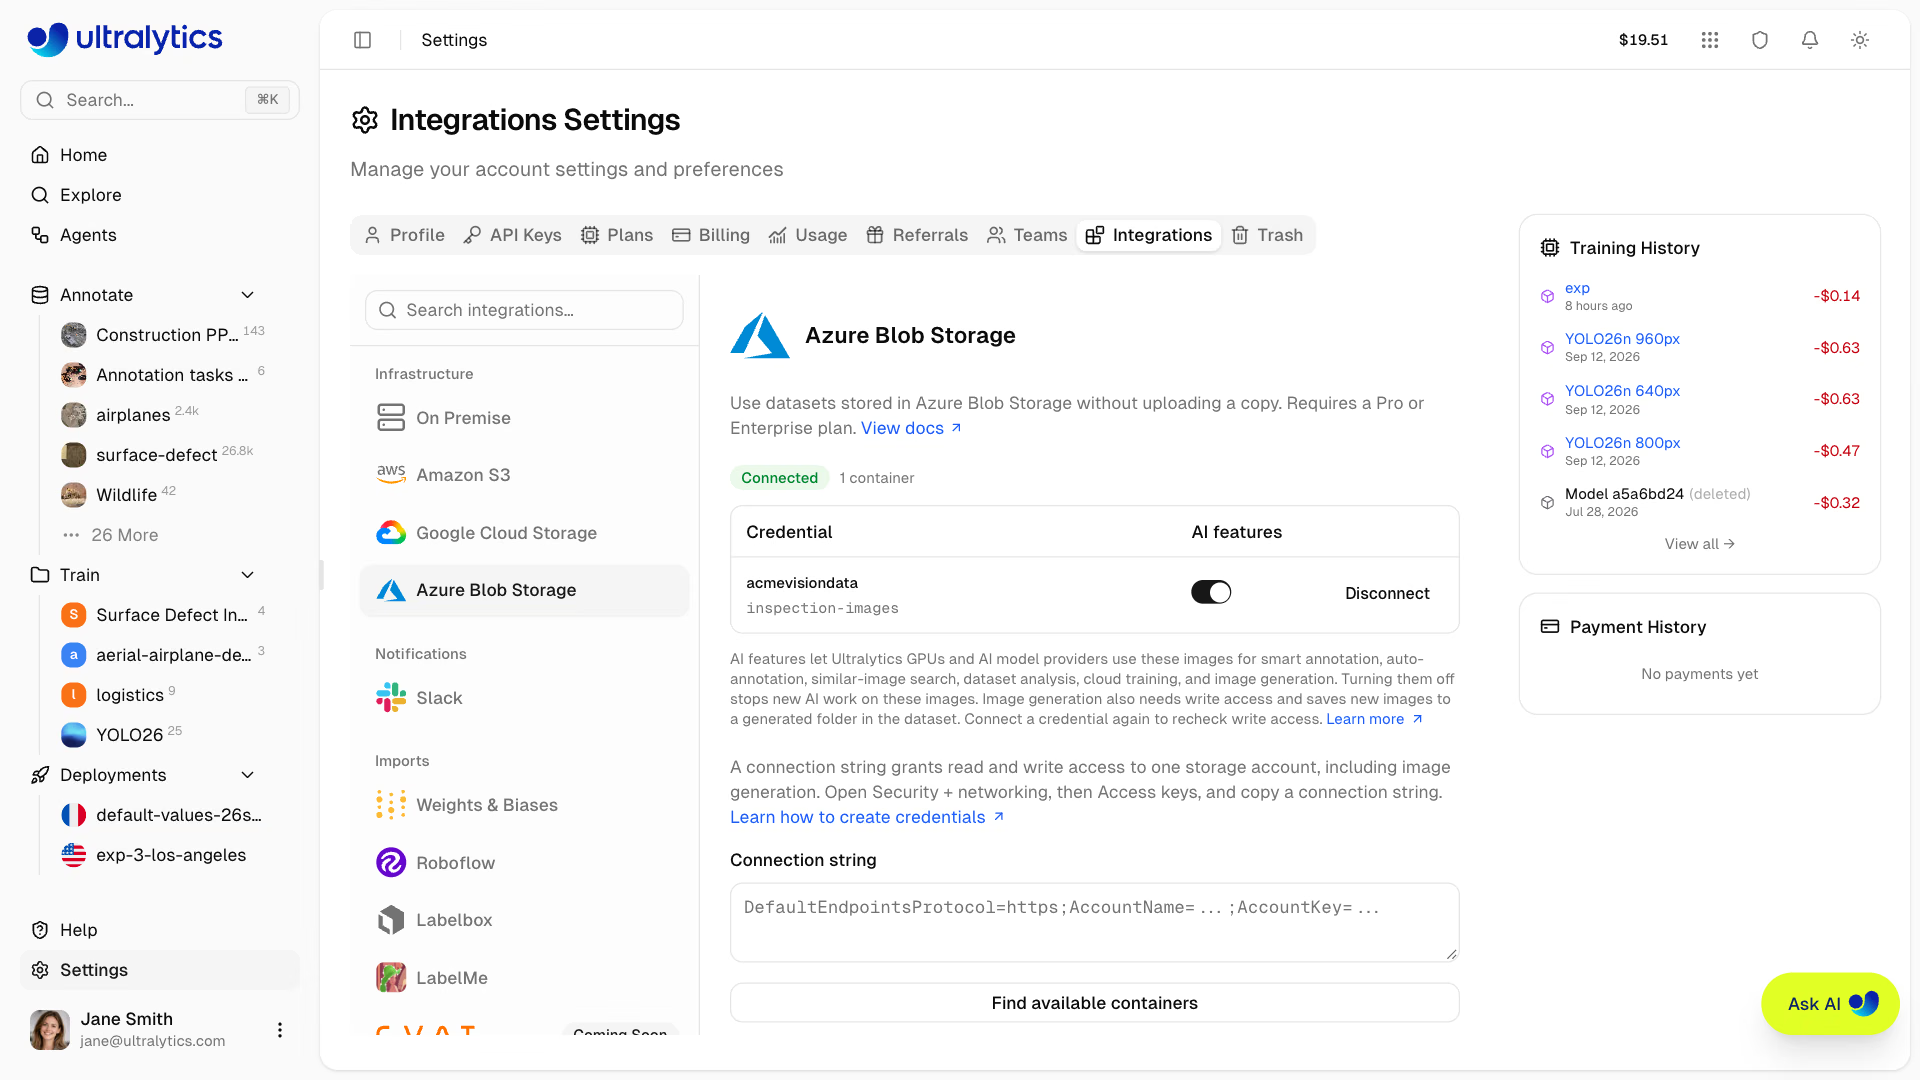
Chaque identifiant connecté comporte une option AI features.
Tu dois avoir le rôle d’administrateur ou de propriétaire de l’espace de travail pour connecter un stockage cloud. Tu peux ajouter jusqu’à 50 conteneurs à la fois ; la détection répertorie jusqu’à 300 conteneurs dans le compte de stockage.
Si tu reconnectes le même compte de stockage ultérieurement, de nouveaux conteneurs sont ajoutés à l’intégration existante. Un identifiant enregistré n’est remplacé que si son remplaçant peut toujours lire tous les conteneurs que tu as déjà connectés. Si un conteneur ne peut pas être lu, l’erreur indique son nom, y compris pour les conteneurs connectés précédemment avec le même compte de stockage.
Une clé de compte peut autoriser des opérations d’écriture et de suppression, ou la création de jetons SAS, si elle est exposée en dehors de Platform. Les identifiants sont chiffrés au repos avec AES-256-GCM, ne sont jamais renvoyés au navigateur et ne sont jamais exposés aux charges de travail d’entraînement. Dans la mesure du possible, utilise un compte de stockage dédié. Pour révoquer l’accès, renouvelle les clés d’accès du compte de stockage dans Azure.
Fonctionnalités d’IA#
Chaque identifiant connecté comporte une option AI features dans Settings > Integrations, activée par défaut. Lorsqu’elle est activée, les GPU Ultralytics et les fournisseurs de modèles d’IA peuvent utiliser les images de cet identifiant pour :
- L’annotation intelligente SAM, ainsi que l’annotation automatique d’une image ou par lot
- La recherche d’images similaires et l’analyse de regroupement
- L’entraînement dans le cloud
- La génération d’images, pour les conteneurs autorisant l’écriture
Les fournisseurs de modèles d'IA interviennent uniquement pour la génération d'images, dont Google Gemini élabore les requêtes à partir de l'image source, et pour les modèles d'annotation payants, qui utilisent la propre clé fournisseur de ton espace de travail. Platform ne conserve aucune copie de tes images : les fonctionnalités les lisent à la demande, l'entraînement cloud en utilise des copies temporaires pendant l'exécution, et la recherche d'images similaires conserve une représentation vectorielle de chaque image, supprimée lorsque l'image quitte Platform.
Désactive l’option pour empêcher l’envoi des images aux GPU Ultralytics et aux fournisseurs de modèles d’IA. Sa désactivation interrompt le lancement de nouveaux traitements d’IA, mais les traitements déjà en cours vont jusqu’au bout. Les jeux de données associés à cet identifiant affichent alors AI features off, avec un lien vers ces paramètres, et chaque fonctionnalité indisponible en indique la raison. L’annotation manuelle, le partage et l’entraînement local restent disponibles, et les étiquettes, modèles et résultats de recherche déjà créés sont conservés.
Tu dois avoir le rôle d’administrateur ou de propriétaire de l’espace de travail pour modifier cette option : rôle. Tu peux aussi le faire avec la REST API, à l’aide de l’identifiant d’intégration renvoyé par GET /api/integrations/buckets :
curl -X PATCH \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"processing": false}' \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
Génération d’images#
La fonction Générer des images similaires est disponible pour les jeux de données Azure Blob Storage lorsque les fonctionnalités d’IA sont activées. Les images que tu ajoutes sont enregistrées dans un dossier generated/ du dossier du jeu de données, puis ajoutées au jeu de données comme toute autre image indexée. Platform crée uniquement de nouveaux blobs à cet emplacement et ne remplace ni ne supprime jamais les blobs existants. Si l’action indique qu’un accès en écriture est nécessaire, reconnecte le même compte de stockage dans Settings > Integrations.
Créer un jeu de données à partir d’un conteneur blob#
- Clique sur Nouveau jeu de données, puis ouvre l’onglet Cloud.
- Choisis un conteneur connecté et accède au dossier contenant tes données.
- Confirme le dossier, ajuste le nom du jeu de données, puis crée-le.
Platform répertorie le dossier une fois et indexe les éléments trouvés :
- Images — Les blobs
.jpg,.jpeg,.png,.webpet.avifsont indexés à l’aide de requêtes limitées pour lire leurs dimensions. Platform ne conserve pas de deuxième copie de l’image source. - Labels — les fichiers annexes YOLO
.txtsont analysés et convertis en annotations Platform, associées selon la structure standardimages/→labels/ou comme fichiers frères dans le même dossier. - Métadonnées — un fichier YAML fournit les noms de classes et la structure des points clés de pose, exactement comme lors d’un téléversement d’archive. Les fichiers
data.yamletdata.ymlsont prioritaires lorsque le dossier en contient plusieurs. - Tâche — un échantillon des fichiers de labels détermine la tâche ; les dossiers de segmentation, de pose et OBB sont donc reconnus à partir de la structure de leurs labels, et non de la tâche choisie dans la boîte de dialogue.
- Sous-ensembles — Les noms de dossier
train,valettestdans le chemin du blob attribuent automatiquement les sous-ensembles.
Le jeu de données fonctionne ensuite comme n’importe quel autre : tu peux le parcourir et l’annoter, le rendre public ou privé, le partager avec ton équipe et l’utiliser pour l’entraînement via l’entraînement géré. Les originaux sont transmis à la demande, et les images indexées ne consomment pas ton quota de stockage Platform.
Une importation unique indexe jusqu’à 500 000 blobs, ainsi que des fichiers d’annotations ou YAML de 1 Mo maximum chacun. Les conteneurs plus volumineux doivent être répartis sur plusieurs jeux de données.
Chaque image indexée est épinglée à l’ETag de son blob, et Platform bloque l’accès si un blob est modifié en arrière-plan. Ajoute de nouveaux blobs au lieu d’écraser ceux qui existent déjà.
Échecs d’importation#
Si une importation échoue — dossier vide, faute de frappe dans le chemin ou autorisations révoquées — le jeu de données affiche l’erreur sur sa page. Les éditeurs peuvent cliquer sur Réessayer l’importation pour la relancer avec le conteneur et le dossier enregistrés, ou créer un nouveau jeu de données en indiquant le chemin corrigé.
Une nouvelle tentative réénumère le dossier au lieu de reprendre l’importation : les blobs ajoutés depuis la première tentative sont récupérés, et ceux qui n’y figurent plus sont retirés du jeu de données.
Entraînement#
L’entraînement géré suit le flux d’entraînement habituel lorsque les fonctionnalités d’IA sont activées. Pendant toute la durée de l’exécution, l’entraînement utilise les propres copies par Platform des images épinglées ; tes identifiants Azure ne sont jamais exposés aux charges de travail d’entraînement. Si les fonctionnalités d’IA sont désactivées, la boîte de dialogue d’entraînement explique pourquoi l’entraînement dans le cloud n’est pas disponible et propose plutôt l’entraînement local.
Déconnecter une intégration#
La déconnexion supprime la chaîne de connexion enregistrée sans rien modifier dans Azure. Les jeux de données créés à partir de ces conteneurs restent dans ton espace de travail avec leurs classes, leurs étiquettes et leurs annotations, mais leurs images ne peuvent pas être chargées, prévisualisées ni utilisées pour l’entraînement tant que le même compte de stockage n’est pas reconnecté. Tu peux toujours les renommer, modifier leurs étiquettes ou les supprimer lorsqu’ils sont déconnectés.
Pour te déconnecter, accède à Settings > Integrations, sélectionne Azure Blob Storage, clique sur Disconnect à côté de l’identifiant, puis confirme. Si tu ouvres l’un de ses jeux de données, le message Azure Blob Storage Disconnected s’affiche, avec un lien vers ces paramètres. Le jeu de données redevient automatiquement accessible une fois la connexion rétablie.
Tu peux aussi te déconnecter avec l’API REST, en utilisant l’identifiant d’intégration renvoyé par GET /api/integrations/buckets :
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")Pour révoquer l’accès à la source, renouvelle plutôt les clés d’accès du compte de stockage dans Azure.
Limites actuelles#
Les jeux de données adossés à Azure n’offrent pas les fonctionnalités qui nécessitent des copies des images gérées par Platform : le clonage de jeux de données, les instantanés de version immuables, le floutage des visages et le collage d’images provenant d’autres jeux de données. L’annotation intelligente, l’annotation automatique, la recherche d’images similaires, le regroupement, l’entraînement dans le cloud et la génération d’images nécessitent que les fonctionnalités d’IA soient activées.
La suppression d’un jeu de données Azure, ou des images qu’il contient, supprime uniquement les références de Platform — tes blobs ne sont jamais touchés.
Consulte aussi les intégrations Google Cloud Storage et Amazon S3.
FAQ#
Non. Platform répertorie le conteneur une fois, puis indexe les dimensions et les étiquettes des images qu’il trouve. Les originaux sont transmis à la demande pour la navigation et l’annotation. Lorsque les fonctionnalités d’IA sont activées, les GPU Ultralytics lisent les images à la demande, l’entraînement géré utilise des copies temporaires pendant la durée d’une exécution, et la recherche d’images similaires conserve un plongement de chaque image, qui est supprimé avec l’image. Les seuls blobs écrits par Platform sont les images générées que tu ajoutes, dans
generated/. Les images indexées ne sont pas décomptées de ton quota de stockage.Un jeu de données est indexé une seule fois, lors de sa création. Les nouveaux objets ne sont pas détectés tant que tu n'as pas créé un nouveau jeu de données ou relancé un import échoué. Chaque image indexée est associée à sa version ; si tu remplaces un objet, Platform bloque alors l'accès à cette image par mesure de sécurité. Ajoute de nouveaux objets au lieu de remplacer ceux qui existent.
Uniquement pour la génération d’images, et seulement lorsque les fonctionnalités d’IA sont activées. Platform crée de nouveaux blobs sous
generated/dans le dossier du jeu de données et ne remplace ni ne supprime jamais les blobs existants.Déconnecte l’intégration dans Settings > Integrations pour supprimer les identifiants enregistrés, ou renouvelle les clés d’accès du compte de stockage dans Azure. Aucune de ces actions ne touche aux données de tes conteneurs. Pour empêcher l’envoi des images aux GPU Ultralytics sans déconnecter l’intégration, désactive les fonctionnalités d’IA.


Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.