Fashion-MNISTデータセット#
Fashion-MNISTデータセットは、Zalandoの衣料品を写した28x28グレースケール画像70,000枚からなる画像分類ベンチマークです。Tシャツ/トップス、ズボン、プルオーバー、ドレス、コート、サンダル、シャツ、スニーカー、バッグ、アンクルブーツの10クラスに均等に分割されています。トレーニング画像60,000枚とテスト画像10,000枚(各クラス7,000枚)の事前定義済み分割が含まれ、元のMNISTデータセットに代わるベンチマーク用データセットとして、機械学習アルゴリズムの評価に使われています。カラー画像版については、関連するCIFAR-10データセットをご覧ください。
Ultralytics PlatformのFashion-MNISTでサンプルをプレビューし、データセットの統計情報を確認して、トレーニング用にクローンできます。
主な機能#
- Fashion-MNISTには、28x28ピクセルのグレースケール画像が70,000枚含まれており、10クラスに均等に分割されています。
- 各クラスには画像がちょうど7,000枚あり、トレーニング用6,000枚、テスト用1,000枚に分かれているため、データセットは完全にバランスが取れています。
- MNISTの置き換え用データセットとしてそのまま使用できます。画像サイズ、形式、分割構造は同一ですが、手書き数字ではなく、より難易度の高い衣料品カテゴリが含まれています。
- データセットにはトレーニング/テストの分割があらかじめ定義されているため、手動または自動で分割する必要はありません。
- Fashion-MNISTは、画像分類およびディープラーニング研究で標準的なベンチマークとして使われています。
データセットの構成#
Fashion-MNISTには公式の事前定義済み分割が含まれているため、自動または手動で分割する必要はありません。
- クラス: 10(Tシャツ/トップス、ズボン、プルオーバー、ドレス、コート、サンダル、シャツ、スニーカー、バッグ、アンクルブーツ)
- 画像総数: 70,000枚(28x28グレースケール)
- トレーニングセット: 60,000枚(各クラス6,000枚)
- テストセット: 10,000枚(各クラス1,000枚)
Fashion-MNISTには独立した検証用フォルダがないため、デフォルトではトレーニング中に10,000枚のテストセットを検証用分割として使用します。
用途#
Fashion-MNISTは、従来型の畳み込みニューラルネットワーク(CNNs)やサポートベクターマシン(SVMs)から最新のディープアーキテクチャまで、画像分類モデルのトレーニングと評価に広く使われています。小さなグレースケール画像と10種類の衣料品カテゴリにより、アルゴリズムの比較やコンピュータービジョンの実験に適した、高速で再現性の高いベンチマークとなっており、MNISTの手書き数字より難易度が高くなっています。
使用方法#
Fashion-MNISTでYOLOモデルをトレーニングするには、画像サイズを28に設定し、100エポック実行します。使用可能な引数の一覧については、トレーニングページと画像分類タスクガイドをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="fashion-mnist", epochs=100, imgsz=28)サンプル画像とアノテーション#
Fashion-MNISTデータセットのサンプル画像:
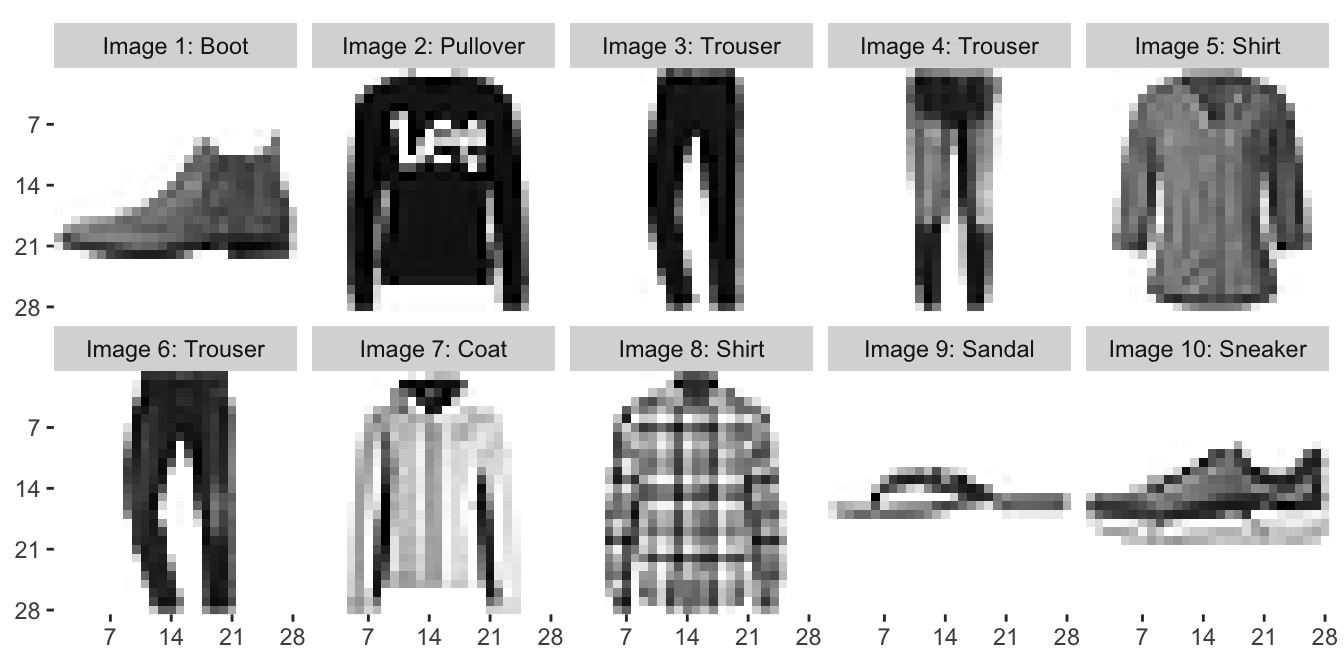
サンプルはFashion-MNISTデータセットに含まれる衣料品カテゴリの多様性を示しており、堅牢な画像分類モデルのトレーニングに多様なデータセットが重要であることを裏付けています。
引用と謝辞#
研究または開発でFashion-MNISTデータセットを使用する場合は、以下の論文を引用してください。
@article{xiao2017fashion,
         title={Fashion-MNIST: a Novel Image Dataset for Benchmarking Machine Learning Algorithms},
         author={Han Xiao and Kashif Rasul and Roland Vollgraf},
         year={2017},
         eprint={1708.07747},
         archivePrefix={arXiv},
         primaryClass={cs.LG}
}Fashion-MNISTデータセットを作成・管理し、機械学習およびコンピュータービジョンの研究コミュニティに貴重なリソースを提供しているZalando Researchに感謝いたします。Fashion-MNISTデータセットとその作成者の詳細については、Fashion-MNISTのGitHubリポジトリをご覧ください。
よくある質問#
Fashion-MNISTデータセットは、Zalandoの衣料品を写した28x28グレースケール画像70,000枚を10クラスに分類したベンチマークで、元のMNISTデータセットの置き換え用として作成されました。MNISTと画像サイズ、形式、60,000/10,000のトレーニング/テスト分割が完全に同じですが、手書き数字の代わりにTシャツ/トップス、ズボン、アンクルブーツなど難易度の高いファッションカテゴリを扱うため、画像分類モデルにとってより難易度の高いベンチマークとなっています。
Fashion-MNISTでUltralytics YOLOモデルをトレーニングするには、以下のコードスニペットを使用します。初回使用時にデータセットが自動的にダウンロードされます。引数の一覧については、モデルのトレーニングページをご覧ください。
トレーニング例from ultralytics import YOLO # モデルを読み込む model = YOLO("yolo26n-cls.pt") # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します) # モデルをトレーニングする results = model.train(data="fashion-mnist", epochs=100, imgsz=28)Fashion-MNISTには、Tシャツ/トップス、ズボン、プルオーバー、ドレス、コート、サンダル、シャツ、スニーカー、バッグ、アンクルブーツの10クラスがあり、各クラスに画像がちょうど7,000枚、合計70,000枚含まれています。各画像にはZalandoの衣料品1点が28x28のグレースケールで写っており、クラスは完全にバランスが取れています。
Fashion-MNISTには、トレーニング画像60,000枚とテスト画像10,000枚の事前定義済み分割が含まれ、各クラスにトレーニング画像6,000枚、テスト画像1,000枚が割り当てられています。Ultralyticsが自動分割するフォルダベースの分類データセットとは異なり、Fashion-MNISTでは公式の分割をそのまま使用し、デフォルトではトレーニング中にテストセットを検証用分割として使用します。
はい。Ultralytics Platformでは、データセットの管理、画像分類モデルのトレーニング、モデルのデプロイを、複雑なコーディングなしで行えます。Fashion-MNISTの実験をクラウドで実行するのに便利です。また、分類データセットの概要で、ほかの選択肢もご確認いただけます。