Ultralytics YOLO를 사용한 포즈 추정#
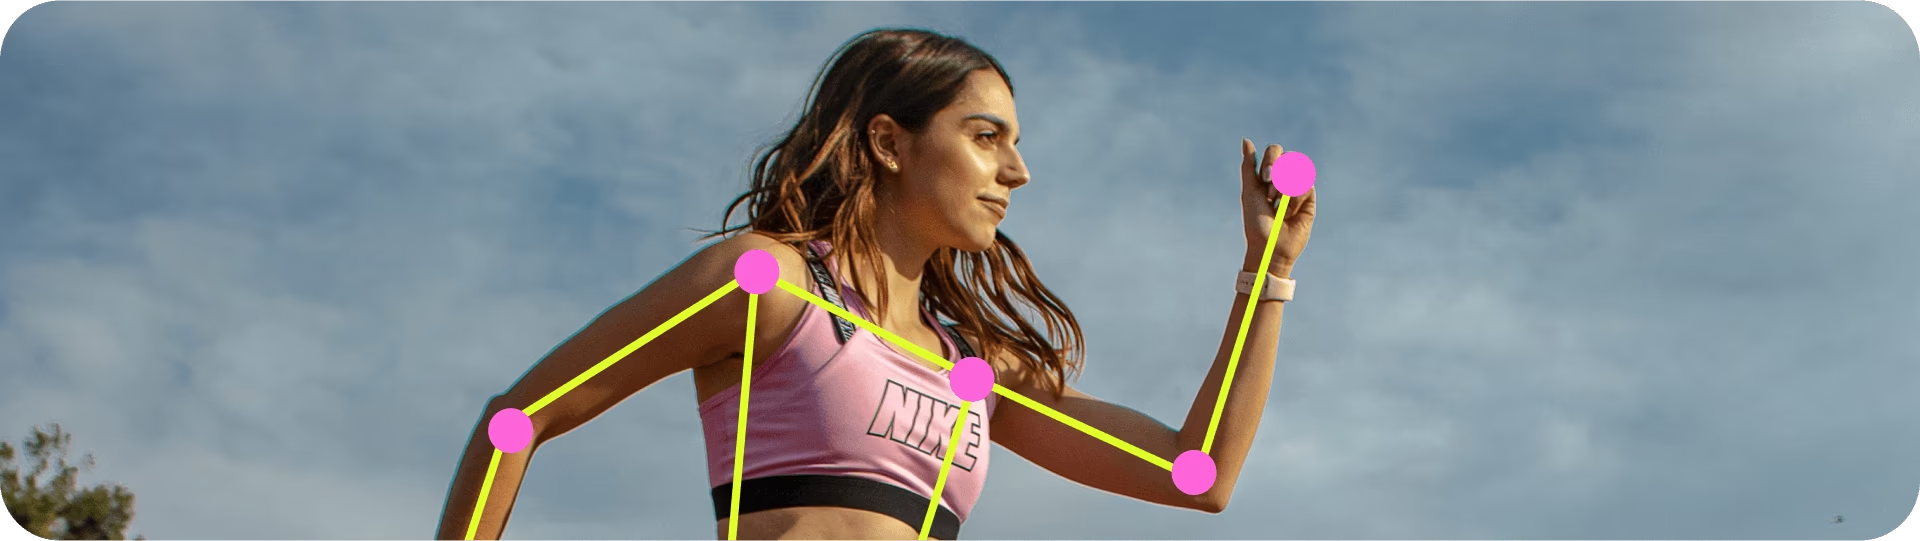
포즈 추정은 이미지에서 특정 지점의 위치를 식별하는 작업으로, 이러한 지점을 일반적으로 키포인트라고 합니다. 키포인트는 관절, 랜드마크 또는 기타 뚜렷한 특징처럼 객체의 다양한 부분을 나타낼 수 있습니다. 키포인트 위치는 일반적으로 2D [x, y] 좌표 집합으로 표현하며, 필요에 따라 가시성 플래그 [x, y, visible]를 포함합니다.
포즈 추정 모델의 출력은 이미지 속 객체의 키포인트를 나타내는 점들의 집합이며, 일반적으로 각 점의 신뢰도 점수도 함께 포함합니다. 장면에서 객체의 특정 부분과 해당 부분 간의 상대적 위치를 식별해야 할 때 포즈 추정이 적합합니다.
시청: Ultralytics YOLO26으로 실시간 포즈 추정을 실행하는 방법 | 추적 및 키포인트 추출 🕺
YOLO26 Pose 모델은 -pose 접미사(예: yolo26n-pose.pt)를 사용하며, COCO 키포인트로 사전 학습됩니다.
모델#
COCO 키포인트 데이터셋으로 사전 학습된 YOLO26 Pose 모델은 아래와 같습니다.
모델은 처음 사용할 때 최신 Ultralytics 릴리스에서 자동으로 다운로드됩니다.
| 모델 | 크기 (픽셀) | mAPpose 50-95(e2e) | mAPpose 50(e2e) | 속도 CPU ONNX (ms) | 속도 T4 TensorRT10 (ms) | 파라미터 (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-pose | 640 | 57.2 | 83.3 | 40.3 ± 0.5 | 1.8 ± 0.0 | 2.9 | 7.6 |
| YOLO26s-pose | 640 | 63.0 | 86.6 | 85.3 ± 0.9 | 2.7 ± 0.0 | 10.4 | 24.1 |
| YOLO26m-pose | 640 | 68.8 | 89.6 | 218.0 ± 1.5 | 5.0 ± 0.1 | 21.5 | 73.3 |
| YOLO26l-pose | 640 | 70.4 | 90.5 | 275.4 ± 2.4 | 6.5 ± 0.1 | 25.9 | 91.7 |
| YOLO26x-pose | 640 | 71.6 | 91.6 | 565.4 ± 3.0 | 12.2 ± 0.2 | 57.6 | 202.3 |
- mAPval 값은 COCO Keypoints val2017 데이터셋에서 단일 모델, 단일 스케일로 측정한 값입니다.
yolo pose val data=coco-pose.yaml device=0 nms=False로 재현할 수 있습니다. - 속도는 CPU의 ONNX와 NVIDIA T4 GPU의 TensorRT10을 사용하여 COCO val 이미지에서 측정한 평균값입니다.
yolo pose val data=coco-pose.yaml batch=1 device=0|cpu nms=False로 재현할 수 있습니다. - Params 및 FLOPs 값은 Conv/BatchNorm 폴딩과 사용하지 않는 감지 브랜치 제거 후의 융합 모델 기준입니다. 사전 학습된 체크포인트에는 전체 학습 아키텍처가 유지되므로 값이 더 높을 수 있습니다.
예비 COCO 키포인트 결과는 미출시 YOLO27 미리 보기를 참조하세요.
학습#
이미지 크기 640으로 COCO8-pose 데이터셋에서 YOLO26n-pose를 100 에포크 동안 학습합니다. 사용 가능한 전체 인수 목록은 구성 페이지를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-pose.yaml")  # YAML에서 새 모델을 생성합니다.
model = YOLO("yolo26n-pose.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).
model = YOLO("yolo26n-pose.yaml").load("yolo26n-pose.pt")  # YAML에서 모델을 생성하고 가중치를 전이합니다.

# 모델 학습
results = model.train(data="coco8-pose.yaml", epochs=100, imgsz=640)
전체 train 모드 세부 정보는 학습 페이지를 참조하세요. Ultralytics Platform 클라우드 학습을 사용하여 포즈 모델을 학습할 수도 있습니다.
데이터셋 형식#
YOLO 포즈 데이터셋 형식에 대한 자세한 내용은 데이터셋 가이드를 참조하세요. 기존 COCO 키포인트 JSON 데이터셋을 YOLO 형식으로 변환하려면 COCO에서 YOLO로 변환하는 가이드에 설명된 대로 기본 제공 convert_coco 함수를 use_keypoints=True와 함께 사용하세요. Ultralytics Platform 주석은 사람, 손, 얼굴 및 사용자 지정 키포인트 레이아웃을 위한 기본 제공 스켈레톤 템플릿과 포즈 라벨도 지원합니다.
사용자 지정 포즈 추정 작업에는 동물 포즈 추정을 위한 Tiger-Pose, 손 추적을 위한 Hand Keypoints, 개의 포즈 분석을 위한 Dog-Pose와 같은 특수 데이터셋도 살펴볼 수 있습니다.
검증#
학습된 YOLO26n-pose 모델의 정확도를 검증합니다. model은 학습에 사용된 data와 인수를 모델 속성으로 유지하므로 별도의 인수가 필요하지 않습니다. 학습 예제의 path/to/best.pt은 COCO8-pose에서 검증을 수행합니다. 공식 가중치에는 사용자의 컴퓨터에 존재하지 않는 학습 데이터셋 경로가 기록되어 있으므로, 경고와 함께 작업 기본값 coco8-pose.yaml를 사용합니다. 다른 데이터셋에서 검증하려면 data을 전달하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-pose.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델을 검증합니다
metrics = model.val()  # 데이터셋과 설정이 기억되므로 인수가 필요하지 않습니다
metrics.box.map  # map50-95
metrics.box.map50  # map50
metrics.box.map75  # map75
metrics.box.maps  # 각 카테고리의 mAP50-95를 포함하는 목록
metrics.box.image_metrics  # 이미지별 박스 정밀도, 재현율, F1, TP, FP, FN을 담은 지표 딕셔너리
metrics.pose.map  # map50-95(P)
metrics.pose.map50  # map50(P)
metrics.pose.map75  # map75(P)
metrics.pose.maps  # 각 카테고리의 mAP50-95(P)를 포함하는 목록
metrics.pose.image_metrics # 이미지별 포즈 정밀도, 재현율, F1, TP, FP, FN을 담은 지표 딕셔너리예측#
학습된 YOLO26n-pose 모델을 사용하여 이미지에서 예측을 수행합니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-pose.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델로 예측을 수행합니다
results = model("https://ultralytics.com/images/bus.jpg")  # 이미지에 대해 예측을 수행합니다

# 결과에 액세스합니다
for result in results:
    xy = result.keypoints.xy  # x 및 y 좌표
    xyn = result.keypoints.xyn  # normalized
    kpts = result.keypoints.data  # x, y, 가시성(사용 가능한 경우)
Predict 페이지에서 predict 모드의 전체 세부 정보를 확인하세요.
결과 출력#
포즈 추정은 이미지마다 Results 객체 하나를 반환합니다. 주요 예측 필드는 포즈 좌표를 나타내는 result.keypoints과 해당 키포인트가 속한 감지 인스턴스를 나타내는 result.boxes입니다.
| 속성 | 유형 | 형태 | 설명 |
|---|---|---|---|
result.keypoints | Keypoints | (N) | 키포인트입니다. |
result.keypoints.data | torch.float32 | (N,K,2/3) | x,y과 선택적 가시성/신뢰도 값입니다. |
result.keypoints.xy | torch.float32 | (N,K,2) | 픽셀 좌표의 키포인트입니다. |
result.keypoints.xyn | torch.float32 | (N,K,2) | 정규화된 키포인트입니다. |
result.boxes | Boxes | (N) | 인스턴스 박스입니다. |
모든 작업에서 작업별 Results 필드를 확인하려면 작업별 예측 결과 섹션을 참조하세요.
키포인트 인덱스 맵#
기본 YOLO26 Pose 모델은 COCO 키포인트 17개를 예측하므로, result.keypoints.xy[:, k]에서 인덱스 k은 다음을 나타냅니다.
- 코
- 왼쪽 눈
- 오른쪽 눈
- 왼쪽 귀
- 오른쪽 귀
- 왼쪽 어깨
- 오른쪽 어깨
- 왼쪽 팔꿈치
- 오른쪽 팔꿈치
- 왼쪽 손목
- 오른쪽 손목
- 왼쪽 엉덩이
- 오른쪽 엉덩이
- 왼쪽 무릎
- 오른쪽 무릎
- 왼쪽 발목
- 오른쪽 발목
내보내기#
YOLO26n-pose 모델을 ONNX, CoreML 등의 다른 형식으로 내보냅니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-pose.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델을 내보냅니다
model.export(format="onnx")
사용 가능한 YOLO26-pose 내보내기 형식은 아래 표에 나와 있습니다. format 인수를 사용하여 어떤 형식으로든 내보낼 수 있습니다(예: format='onnx' 또는 format='engine'). 내보낸 모델에서 바로 예측을 수행하거나 검증할 수도 있습니다(예: yolo predict model=yolo26n-pose.onnx). 내보내기가 완료되면 모델에 사용할 수 있는 예제가 표시됩니다.
| 형식 | format 인수 | 모델 | 메타데이터 | 인수 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-pose.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-pose.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-pose.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-pose_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-pose.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-pose.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-pose.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-pose_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-pose.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-pose_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-pose.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-pose_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-pose.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-pose_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-pose_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-pose_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-pose_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-pose_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-pose_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-pose_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-pose_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-pose_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-pose_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None은 외부 NMS를 위한 원시 출력을 기본값으로 사용합니다. 사용 가능한 NMS-free head를 선택하려면 nms=False을 설정합니다. 지원되지 않는 형식은 해당 형식의 기본 출력 경로로 대체됩니다. 위의 nms 항목은 nms=True을 사용해 NMS를 포함할 수 있는 형식을 나타냅니다.
자세한 export 내용은 내보내기 페이지를 참조하세요.
자주 묻는 질문#
Ultralytics YOLO26의 포즈 추정은 이미지에서 키포인트라고 하는 특정 지점을 식별하는 작업입니다. 이러한 키포인트는 일반적으로 관절이나 객체의 기타 주요 특징을 나타냅니다. 출력에는 각 지점의
[x, y]좌표와 신뢰도 점수가 포함됩니다. YOLO26-pose 모델은 이 작업을 위해 특별히 설계되었으며,-pose접미사(예:yolo26n-pose.pt)를 사용합니다. 이러한 모델은 COCO 키포인트와 같은 데이터셋으로 사전 학습되며 다양한 포즈 추정 작업에 사용할 수 있습니다. 자세한 내용은 포즈 추정 페이지를 참조하세요.사용자 지정 데이터셋으로 YOLO26-pose 모델을 학습하려면 YAML 파일로 정의한 새 모델 또는 사전 학습된 모델을 로드해야 합니다. 그런 다음 지정한 데이터셋과 매개변수를 사용하여 학습을 시작할 수 있습니다.
예제from ultralytics import YOLO # 모델 로드 model = YOLO("yolo26n-pose.yaml") # YAML에서 새 모델을 생성합니다. model = YOLO("yolo26n-pose.pt") # 사전 학습된 모델을 불러옵니다(학습에 권장). # 모델 학습 results = model.train(data="your-dataset.yaml", epochs=100, imgsz=640)학습에 대한 자세한 내용은 학습 섹션을 참조하세요. 코드 없이 사용자 지정 포즈 추정 모델을 학습하려면 Ultralytics Platform 클라우드 학습을 사용할 수도 있습니다.
YOLO26-pose 모델의 검증은 학습 중에 유지된 동일한 데이터셋 매개변수를 사용하여 정확도를 평가하는 과정입니다. 예시는 다음과 같습니다.
예제from ultralytics import YOLO # 모델 로드 model = YOLO("yolo26n-pose.pt") # 공식 모델을 불러옵니다 model = YOLO("path/to/best.pt") # 사용자 지정 모델 로드 # 모델을 검증합니다 metrics = model.val() # 데이터셋과 설정이 기억되므로 인수가 필요하지 않습니다자세한 내용은 검증 섹션을 참조하세요.
예, YOLO26-pose 모델은 ONNX, CoreML, TensorRT 등 다양한 형식으로 내보낼 수 있습니다. Python 또는 명령줄 인터페이스(CLI)를 사용하면 됩니다.
예제from ultralytics import YOLO # 모델 로드 model = YOLO("yolo26n-pose.pt") # 공식 모델을 불러옵니다 model = YOLO("path/to/best.pt") # 사용자 지정 모델 로드 # 모델을 내보냅니다 model.export(format="onnx")자세한 내용은 내보내기 섹션을 참조하세요. 내보낸 모델은 피트니스 추적, 스포츠 분석 또는 로보틱스와 같은 실시간 애플리케이션을 위해 엣지 디바이스에 배포할 수 있습니다.
Ultralytics YOLO26은 YOLO26n-pose, YOLO26s-pose, YOLO26m-pose 등 다양한 사전 학습 포즈 모델을 제공합니다. 각 모델은 크기, 정확도(mAP), 속도가 다릅니다. 모델별 COCO 키포인트 mAP, 속도, 매개변수 및 FLOPs 전체 목록은 모델 섹션을 참조하세요.