Dataset COCO-Pose#
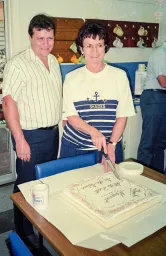
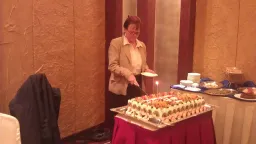
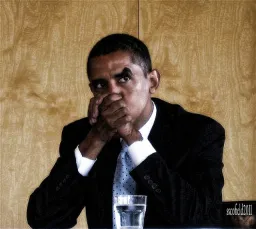
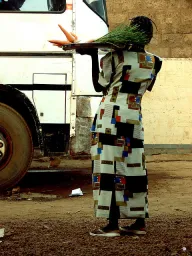
O dataset COCO-Pose adapta o COCO (Objetos Comuns em Contexto) para estimativa de pose: 58.945 imagens do COCO Keypoints 2017, anotadas com 156.165 pessoas usando um esquema de 17 pontos-chave. É o conjunto padrão para treinar e avaliar modelos de pontos-chave, como o Ultralytics YOLO26, e o subconjunto de 8 imagens COCO8-Pose replica o seu formato para verificações rápidas de sanidade.
Modelos pré-treinados COCO-Pose#
| Modelo | tamanho (píxeis) | mAPpose 50-95(e2e) | mAPpose 50(e2e) | Velocidade CPU ONNX (ms) | Velocidade T4 TensorRT10 (ms) | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-pose | 640 | 57.2 | 83.3 | 40.3 ± 0.5 | 1.8 ± 0.0 | 2.9 | 7.6 |
| YOLO26s-pose | 640 | 63.0 | 86.6 | 85.3 ± 0.9 | 2.7 ± 0.0 | 10.4 | 24.1 |
| YOLO26m-pose | 640 | 68.8 | 89.6 | 218.0 ± 1.5 | 5.0 ± 0.1 | 21.5 | 73.3 |
| YOLO26l-pose | 640 | 70.4 | 90.5 | 275.4 ± 2.4 | 6.5 ± 0.1 | 25.9 | 91.7 |
| YOLO26x-pose | 640 | 71.6 | 91.6 | 565.4 ± 3.0 | 12.2 ± 0.2 | 57.6 | 202.3 |
Principais funcionalidades#
- O COCO-Pose baseia-se no desafio COCO Keypoints 2017, que identifica 1.710.498 pontos-chave individuais em 156.165 pessoas anotadas.
- Cada anotação de pessoa usa 17 tipos de pontos-chave — nariz, olhos, orelhas, ombros, cotovelos, pulsos, ancas, joelhos e tornozelos — armazenados como triplos
(x, y, visibility). - Tal como o COCO, fornece métricas de avaliação padronizadas, incluindo a Similaridade de Pontos-Chave de Objetos (OKS) para tarefas de estimativa de pose, o que o torna adequado para comparar o desempenho dos modelos.
- Tamanho do download: ~20,2 GB na primeira utilização (
train2017.zip+val2017.zip+ etiquetas). Otest2017.zipde 7 GB não é obtido automaticamente, uma vez que essas imagens têm a verdade fundamental retida e só são necessárias para uma submissão test-dev2017.
Estrutura do Conjunto de Dados#
Para treino e validação, o COCO-Pose inclui apenas imagens do COCO 2017 com pessoas anotadas com pontos-chave, pelo que as suas divisões anotadas são menores do que as do COCO completo. O seu YAML define três subconjuntos:
- Train2017: Este subconjunto contém 56.599 imagens do dataset COCO, anotadas para treinar modelos de estimativa de pose.
- Val2017: Este subconjunto tem 2.346 imagens utilizadas para validação durante o treino do modelo.
- Test-dev2017: Um subconjunto de 20.288 imagens do conjunto test2017 completo de 40.670 imagens, com a verdade fundamental retida. O YAML do dataset liga esta divisão ao servidor de avaliação de pontos-chave COCO test-dev.
É neste nível de escala que a Ultralytics Platform é mais útil — gere a computação para que possas iniciar e monitorizar execuções sem aprovisionar as tuas próprias GPUs.
Aplicações#
O dataset COCO-Pose é utilizado especificamente para treinar e avaliar modelos de aprendizagem profunda na deteção de pontos-chave e na estimativa de pose. O grande número de imagens anotadas e as métricas de avaliação padronizadas do dataset fazem dele um recurso essencial para investigadores e profissionais de visão computacional que trabalham com pose humana.
YAML do Conjunto de Dados#
Um ficheiro YAML é utilizado para definir a configuração do dataset. Contém informações sobre os caminhos, as classes e outras informações relevantes do dataset. No caso do dataset COCO-Pose, o ficheiro coco-pose.yaml é mantido em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 Keypoints dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/pose/coco
# Example usage: yolo train data=coco-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco-pose ← downloads here (20.2 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco-pose # dataset root dir
train: train2017.txt # train images (relative to 'path') 56599 images
val: val2017.txt # val images (relative to 'path') 2346 images
test: test-dev2017.txt # 20288 of 40670 images, submit to https://codalab.lisn.upsaclay.fr/competitions/7403

# Keypoints
kpt_shape: [17, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)
flip_idx: [0, 2, 1, 4, 3, 6, 5, 8, 7, 10, 9, 12, 11, 14, 13, 16, 15]

# Classes
names:
  0: person

# Keypoint names per class
kpt_names:
  0:
    - nose
    - left_eye
    - right_eye
    - left_ear
    - right_ear
    - left_shoulder
    - right_shoulder
    - left_elbow
    - right_elbow
    - left_wrist
    - right_wrist
    - left_hip
    - right_hip
    - left_knee
    - right_knee
    - left_ankle
    - right_ankle

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  dir = Path(yaml["path"])  # dataset root dir

  urls = [f"{ASSETS_URL}/coco2017labels-pose.zip"]
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the CodaLab test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Utilização#
Para treinar um modelo YOLO26n-pose no dataset COCO-Pose durante 100 épocas, com um tamanho de imagem de 640, podes utilizar os seguintes trechos de código. Para obter uma lista completa dos argumentos disponíveis, consulta a página de Treino do modelo.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-pose.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco-pose.yaml", epochs=100, imgsz=640)
Imagens de exemplo e anotações#
O dataset COCO-Pose contém um conjunto diversificado de imagens com figuras humanas anotadas com pontos-chave. Eis alguns exemplos de imagens do dataset, juntamente com as respetivas anotações:
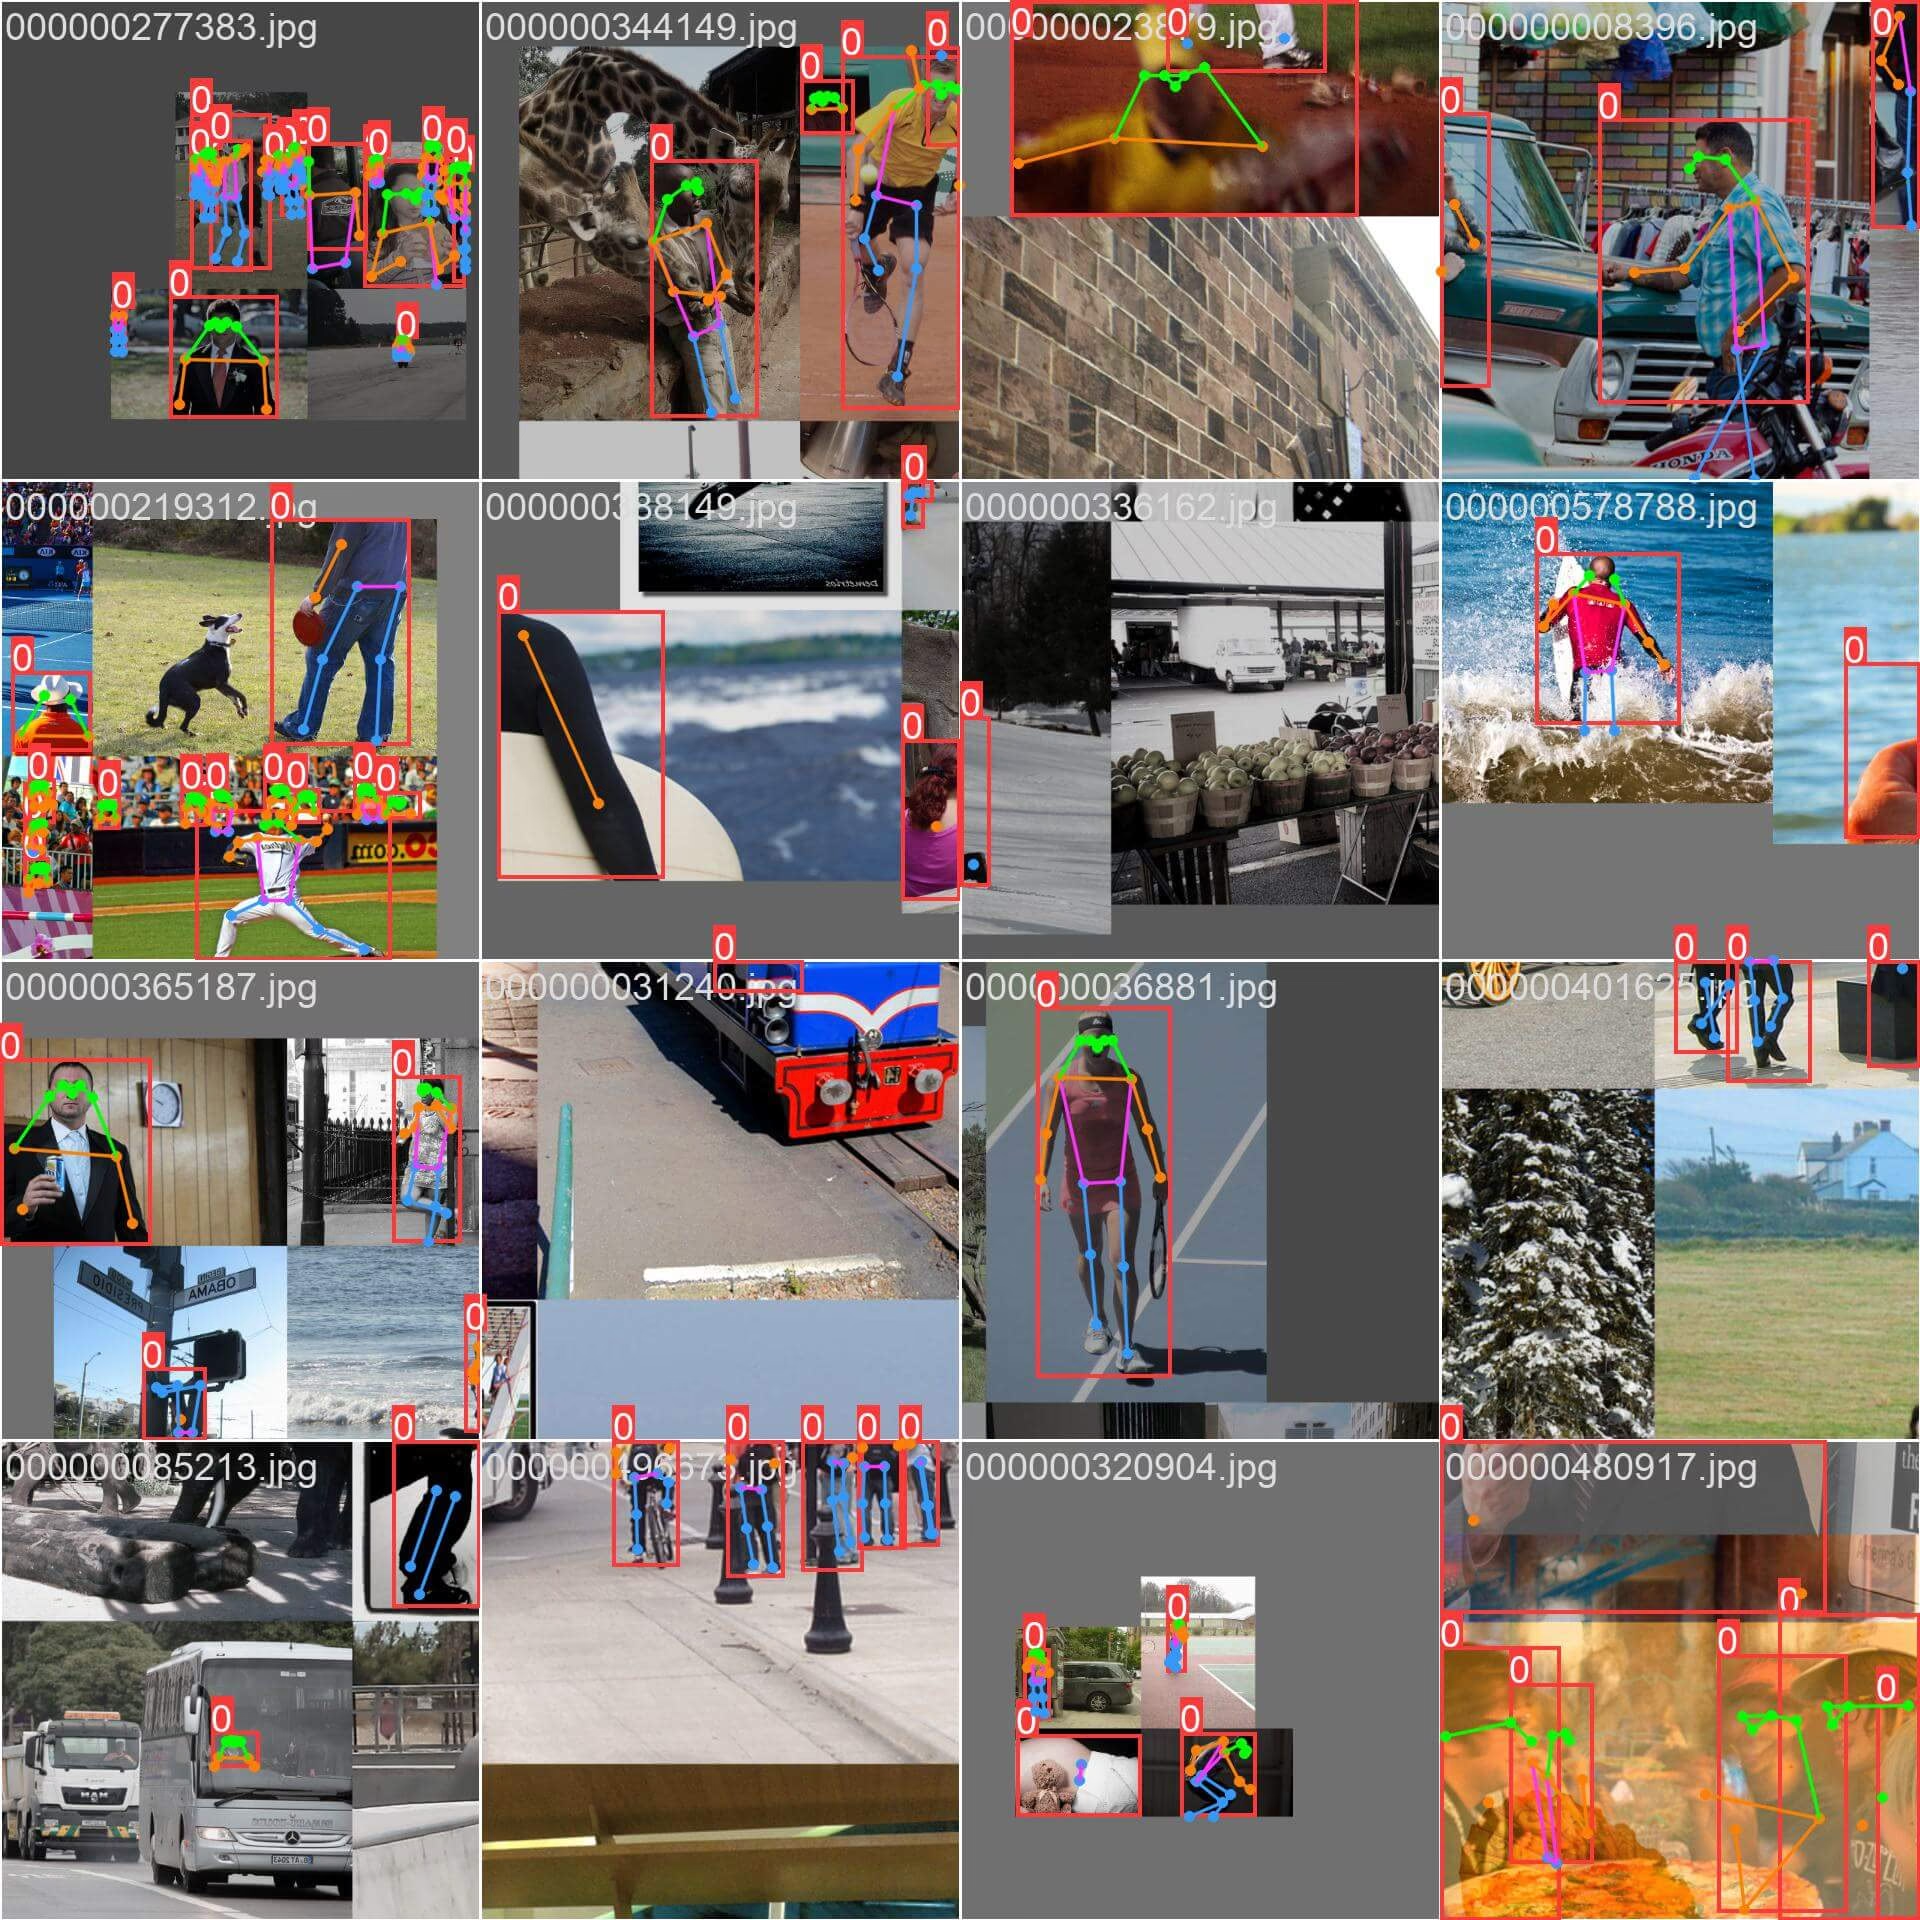
- Imagem em mosaico: esta imagem demonstra um lote de treino composto por imagens do dataset combinadas em mosaico. A combinação em mosaico é uma técnica utilizada durante o treino que combina várias imagens numa única imagem para aumentar a variedade de objetos e cenas em cada lote de treino. Isto ajuda a melhorar a capacidade do modelo de generalizar para diferentes tamanhos de objetos, proporções e contextos.
O exemplo demonstra a variedade e a complexidade das imagens do dataset COCO-Pose, bem como os benefícios da utilização de mosaicos durante o processo de treino.
Citações e agradecimentos#
Se utilizares o dataset COCO-Pose no teu trabalho de investigação ou desenvolvimento, cita o seguinte artigo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Gostaríamos de agradecer ao COCO Consortium por criar e manter este recurso valioso para a comunidade de visão computacional. Para obter mais informações sobre o dataset COCO-Pose e os seus criadores, visita o site do dataset COCO.
Perguntas frequentes#
O COCO-Pose fornece as imagens e anotações do COCO Keypoints 2017 convertidas para o formato de pontos-chave YOLO, utilizando um esquema de 17 pontos-chave em 58.945 imagens. Indica qualquer modelo de pose Ultralytics YOLO para o dataset com
data=coco-pose.yaml, e a página de Treino documenta todos os argumentos que podes ajustar a partir daí.Carrega
yolo26n-pose.pte chamamodel.train(data="coco-pose.yaml", epochs=100, imgsz=640)— consulta o Exemplo de treino acima para obter os trechos completos em Python e CLI, e a página de treino para obter uma lista completa de argumentos.O dataset COCO-Pose fornece várias métricas de avaliação padronizadas para tarefas de estimativa de pose, semelhantes às do dataset COCO original. As principais métricas incluem a Similaridade de Pontos-Chave de Objetos (OKS), que avalia a precisão dos pontos-chave previstos em relação às anotações de verdade fundamental. Estas métricas permitem comparações detalhadas de desempenho entre diferentes modelos. Por exemplo, os modelos pré-treinados COCO-Pose, como YOLO26n-pose, YOLO26s-pose e outros, têm métricas de desempenho específicas listadas na documentação, como mAPpose50-95 e mAPpose50.
O COCO-Pose inclui duas divisões anotadas: 56.599 imagens train2017 e 2.346 imagens val2017. Uma terceira divisão, test-dev2017 (20.288 das 40.670 imagens test2017 completas), mantém a verdade fundamental privada; o YAML do dataset liga-a ao servidor de avaliação de pontos-chave COCO test-dev. Consulta a secção Estrutura do dataset ou o ficheiro
coco-pose.yamlno GitHub para obter os caminhos exatos das divisões.O COCO-Pose utiliza 17 tipos de pontos-chave humanos e herda as métricas padronizadas do COCO, incluindo a Similaridade de Pontos-Chave de Objetos (OKS), para comparar modelos. Essa combinação é adequada para aplicações de pose humana, como análise desportiva, cuidados de saúde e interação homem-computador. Os pesos pré-treinados YOLO26-pose estão listados em Modelos pré-treinados COCO-Pose.
Para obter mais informações sobre modelos de pontos-chave, consulta a documentação da tarefa Estimativa de pose.