Conjunto de dados COCO-Seg
O conjunto de dados COCO-Seg fornece máscaras de segmentação de instâncias COCO (Objetos Comuns em Contexto) — 118.287 imagens de treino e 5.000 imagens de validação com máscaras poligonais em 80 categorias de objetos — no formato de rótulos Ultralytics YOLO. Usa as imagens originais e as anotações de segmentação nativas do COCO, convertidas para o treino YOLO, o que o torna um recurso padrão para investigadores e programadores que trabalham em tarefas de segmentação de instâncias.
Modelos pré-treinados COCO-Seg#
| Modelo | tamanho (pixels) | mAPcaixa50-95 (e2e) | mAPmáscara50-95 (e2e) | Velocidade CPU ONNX (ms) | Velocidade T4 TensorRT10 (ms) | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-seg | 640 | 39.6 | 33.9 | 53.3 ± 0.5 | 2.1 ± 0.0 | 2.7 | 9.3 |
| YOLO26s-seg | 640 | 47.3 | 40.0 | 118.4 ± 0.9 | 3.3 ± 0.0 | 10.4 | 34.5 |
| YOLO26m-seg | 640 | 52.5 | 44.1 | 328.2 ± 2.4 | 6.7 ± 0.1 | 23.6 | 121.7 |
| YOLO26l-seg | 640 | 54.4 | 45.5 | 387.0 ± 3.7 | 8.0 ± 0.1 | 28.0 | 140.1 |
| YOLO26x-seg | 640 | 56.5 | 47.0 | 787.0 ± 6.8 | 16.4 ± 0.1 | 62.8 | 314.0 |
Principais funcionalidades#
- O COCO-Seg oferece máscaras de segmentação de instâncias para 123.287 imagens rotuladas do COCO train2017/val2017 (118.287 de treino + 5.000 de validação), dentro do conjunto mais amplo de cerca de ~330 mil imagens do COCO.
- O conjunto de dados contém as mesmas 80 categorias de objetos do conjunto de dados COCO original.
- As anotações fornecem máscaras de segmentação de instâncias no formato de rótulos poligonais YOLO.
- O COCO-Seg oferece métricas mAP e mAR padronizadas para avaliar o desempenho da segmentação de instâncias, permitindo comparar modelos de forma eficaz.
- Tamanho do download: cerca de ~20,3 GB na primeira utilização (
train2017.zip+val2017.zip+ rótulos). O arquivotest2017.zip, de 7 GB, não é baixado automaticamente, pois essas imagens não têm dados de referência disponíveis e só são necessárias para uma submissão test-dev2017.
Estrutura do conjunto de dados#
O conjunto de dados COCO-Seg está dividido em três subconjuntos:
- Train2017: 118.287 imagens para treinar modelos de segmentação de instâncias.
- Val2017: 5.000 imagens usadas para validação durante o desenvolvimento do modelo.
- Test-dev2017: 20.288 das 40.670 imagens test2017, usadas para benchmarking. As anotações de ground truth desse subconjunto não estão disponíveis publicamente, então as predições devem ser enviadas ao servidor de avaliação do COCO para pontuação.
Para experimentos em menor escala, veja os subconjuntos COCO128-Seg (128 imagens) e COCO8-Seg (8 imagens).
Aplicações#
O COCO-Seg é amplamente utilizado para treinar e avaliar modelos de aprendizagem profunda em segmentação de instâncias, como os modelos YOLO. O grande número de imagens anotadas, a diversidade das categorias de objetos e as métricas de avaliação padronizadas fazem dele um recurso padrão para investigadores e profissionais de visão computacional. Também podes explorar e gerir todas as anotações do COCO-Seg na Ultralytics Platform.
YAML do conjunto de dados#
Um arquivo YAML é usado para definir a configuração do conjunto de dados. Ele contém informações sobre os caminhos, as classes e outros dados relevantes do conjunto de dados. No caso do conjunto de dados COCO-Seg, o arquivo coco.yaml é mantido em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Uso#
Para treinar um modelo YOLO26n-seg no conjunto de dados COCO-Seg durante 100 épocas, com tamanho de imagem 640, podes utilizar os seguintes exemplos de código.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-seg.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Imagens de exemplo e anotações#
O COCO-Seg contém as mesmas imagens diversificadas, categorias de objetos e cenas complexas do COCO, com máscaras de segmentação de instâncias no formato de rótulo YOLO. Veja alguns exemplos de imagens do conjunto de dados e as respectivas máscaras de segmentação de instâncias:
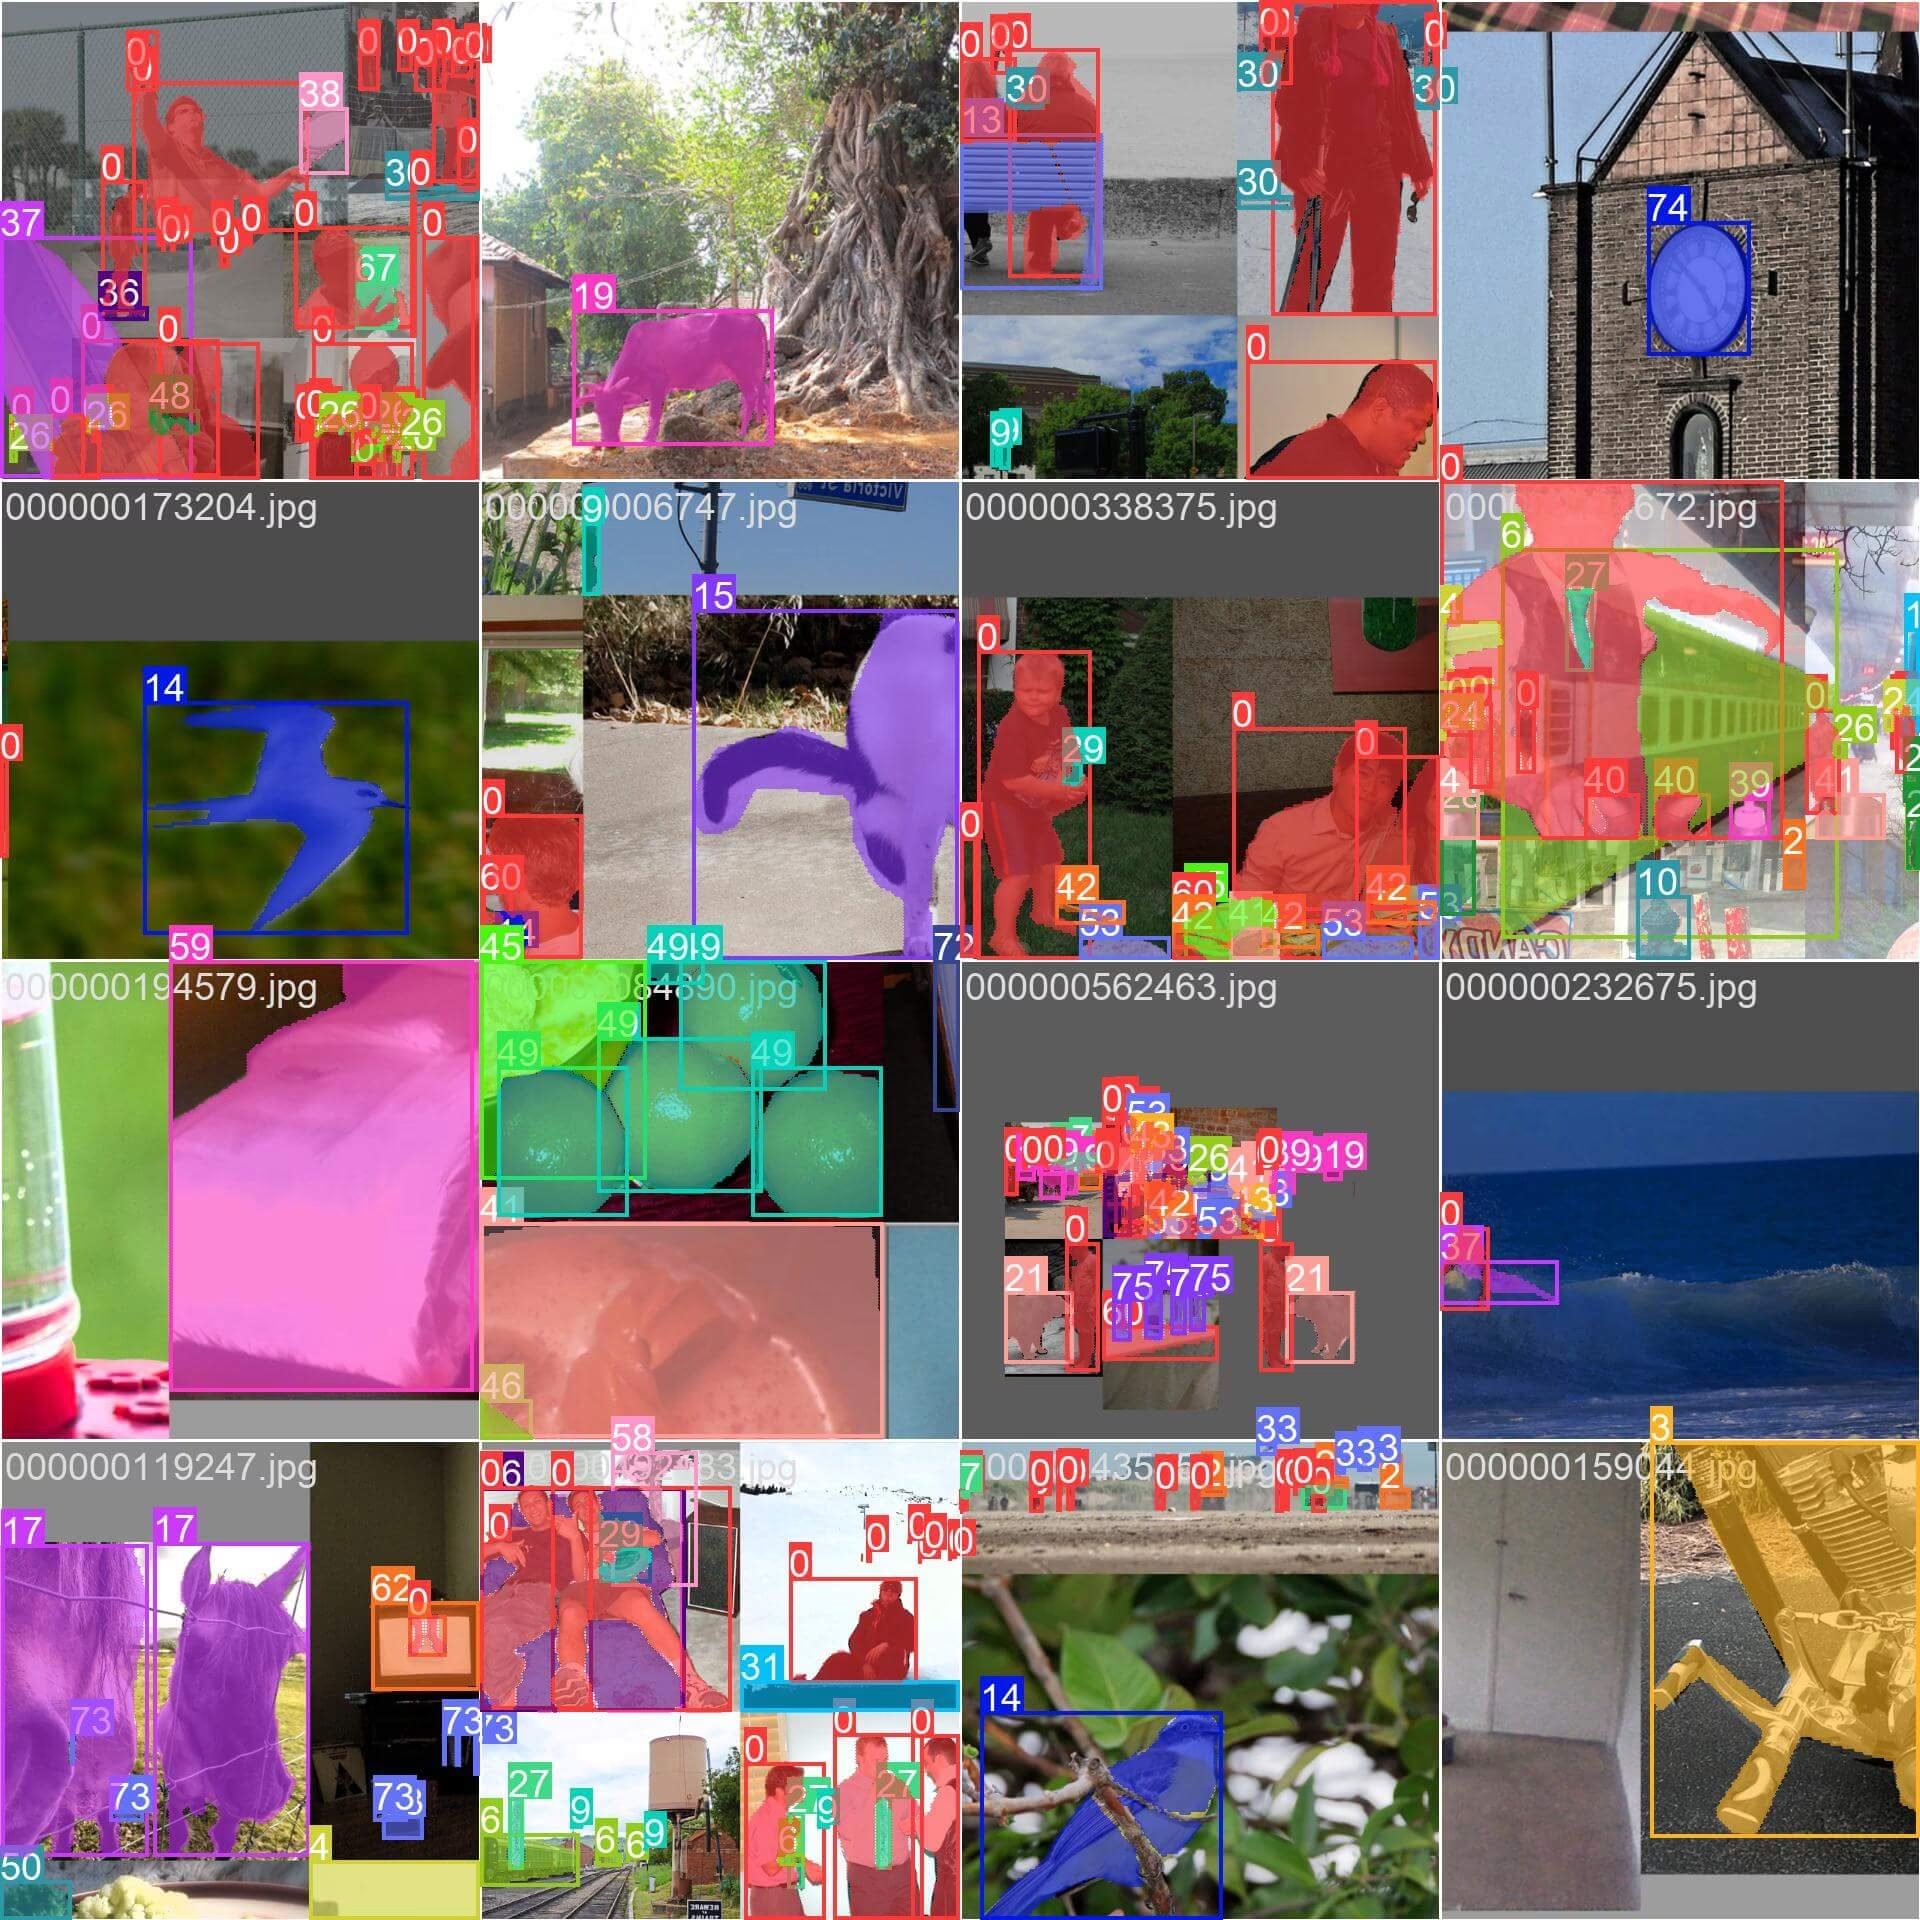
- Imagem em mosaico: esta imagem mostra um lote de treinamento composto por imagens do conjunto de dados organizadas em mosaico. O mosaico é uma técnica usada durante o treinamento que combina várias imagens em uma só para aumentar a variedade de objetos e cenas em cada lote de treinamento. Isso ajuda o modelo a generalizar para diferentes tamanhos de objetos, proporções e contextos.
Citações e agradecimentos#
Se você usar o conjunto de dados COCO-Seg em seus trabalhos de pesquisa ou desenvolvimento, cite o artigo original do COCO e reconheça a extensão COCO-Seg:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Agradecemos ao Consórcio COCO por criar e manter este valioso recurso para a comunidade de visão computacional.
Perguntas frequentes#
O COCO-Seg é o empacotamento no formato Ultralytics YOLO das máscaras nativas de segmentação de instâncias do COCO (Objetos Comuns em Contexto) para as mesmas 118.287 imagens train2017 e 5.000 imagens val2017. As anotações originais do COCO já incluem estas máscaras poligonais para todas as 80 categorias de objetos; o COCO-Seg converte-as para o formato de rótulos YOLO utilizado no treino de segmentação de instâncias de objetos.
Para treinar um modelo YOLO26n-seg no conjunto de dados COCO-Seg por 100 épocas, com tamanho de imagem 640, você pode usar os trechos de código a seguir. Para ver uma lista detalhada dos argumentos de treinamento disponíveis, consulte a página de treinamento do modelo.
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n-seg.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="coco.yaml", epochs=100, imgsz=640)O conjunto de dados COCO-Seg inclui vários recursos importantes:
- Fornece máscaras de segmentação de instâncias para 123.287 imagens COCO train2017/val2017 rotuladas (118.287 train + 5.000 val).
- Anota as mesmas 80 categorias de objetos encontradas no COCO original.
- Fornece máscaras de segmentação de instâncias no formato de rótulo poligonal YOLO.
- Usa métricas de avaliação padronizadas, como a precisão média média (mAP) e a revocação média (mAR), para tarefas de segmentação de instâncias.
O conjunto de dados COCO-Seg é compatível com vários modelos YOLO26 de segmentação pré-treinados, com diferentes métricas de desempenho. Veja um resumo dos modelos disponíveis e suas principais métricas:
Modelo tamanho
(pixels)mAPcaixa50-95
(e2e)mAPmáscara50-95
(e2e)Velocidade
CPU ONNX
(ms)Velocidade
T4 TensorRT10
(ms)parâmetros
(M)FLOPs
(B)YOLO26n-seg 640 39.6 33.9 53.3 ± 0.5 2.1 ± 0.0 2.7 9.3 YOLO26s-seg 640 47.3 40.0 118.4 ± 0.9 3.3 ± 0.0 10.4 34.5 YOLO26m-seg 640 52.5 44.1 328.2 ± 2.4 6.7 ± 0.1 23.6 121.7 YOLO26l-seg 640 54.4 45.5 387.0 ± 3.7 8.0 ± 0.1 28.0 140.1 YOLO26x-seg 640 56.5 47.0 787.0 ± 6.8 16.4 ± 0.1 62.8 314.0 Estes modelos vão do leve YOLO26n-seg ao mais preciso YOLO26x-seg, oferecendo diferentes equilíbrios entre velocidade e precisão para responder aos requisitos de várias aplicações.
O conjunto de dados COCO-Seg está dividido em três subconjuntos para atender a necessidades específicas de treinamento e avaliação:
- Train2017: contém 118.287 imagens usadas principalmente para treinar modelos de segmentação de instâncias.
- Val2017: Inclui 5.000 imagens utilizadas para validação durante o processo de treino.
- Test-dev2017: Contém 20.288 das 40.670 imagens test2017 reservadas para testar e avaliar modelos treinados. Nota que as anotações de referência deste subconjunto não estão disponíveis publicamente e que os resultados de desempenho são submetidos ao servidor de avaliação COCO para análise.
Para experimentos em menor escala, você também pode considerar o conjunto de dados COCO128-Seg (128 imagens) ou o conjunto de dados COCO8-Seg, uma versão compacta com apenas 8 imagens do conjunto COCO train 2017.


Comentários10
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
liujieKermit
what the label format if I want to train my custom dataset, please give the solution step by step like label, train, val, export, predict
 Glenn JocherUltralytics(editado)
@liujieKermit for custom segmentation training with YOLO26, follow these steps:
-
Label Format: Use YOLO segmentation format - one text file per image with class index and normalized polygon coordinates (minimum 3 points per object). Example:
<class> <x1> <y1> <x2> <y2> ... <xn> <yn> -
Dataset YAML: Create a YAML file (example
data.yaml):
path: /path/to/dataset train: images/train val: images/val names: 0: class1 1: class2- Train:
from ultralytics import YOLO model = YOLO('yolo26n-seg.pt') model.train(data='data.yaml', epochs=100, imgsz=640)- Export/Predict:
model.export(format='onnx')  # export
model.predict('image.jpg')  # predict
For full details see our Dataset Format Guide and Auto-Annotation Tools. For commercial use, review our license terms.
-
YingdiZhang
Thanks for the great work. I am new to YOLO and AI. How to download the COCO dataset? is just running python coco.yaml?
- Glenn JocherUltralytics(editado)
@YingdiZhang to download the COCO dataset, you can run
yolo segment train data=coco.yamlin your terminal. This will automatically download the dataset for you. For more details, you can visit the Ultralytics documentation.
SacherTorte280
Dear developpers, I need to build a much simpler case where I'll only need <=5 labels, can I remove the others that i'll never use ?
 Paula DerrengerUltralytics(editado)
@SacherTorte280 yes, you can customize the dataset to include only the labels you need. To do this, modify the
coco.yamlfile to include only the desired classes in thenamessection and adjust the dataset paths accordingly. Also make sure the class indices in your label files are remapped to match the newnames(0 to N-1) and remove labels of the dropped classes. This will allow you to train your model with a simplified set of labels. For more details on configuring the dataset, please refer to the COCO-Seg documentation.
MoAbbasid
i get a list out of index error when running convert_coco function please help
- Paula DerrengerUltralytics
Hi there! It looks like you're encountering a
list index out of rangeerror with theconvert_cocofunction. This can often happen if the script is trying to access an element that doesn't exist in a list. To help you resolve this issue, please ensure that:- The data paths in your
coco.yamlconfig file are correctly set and point to valid files. - The COCO dataset is correctly downloaded and structured as expected by the script.
If the paths and dataset structure are correct, it might be helpful to check if the specific segment of data causing the error is formatted correctly or missing elements.
Here's a quick check you can perform:
try:
    # Assuming convert_coco is called here
    convert_coco()
except IndexError as e:
    print("An index error occurred: ", e)
    # You can add more debugging information here to understand which part of the data is causing the problem
This snippet will catch the
IndexErrorand print it, potentially providing more insight on what's going wrong. If you need further assistance, please don't hesitate to share a snippet of the data or more details on the error! - The data paths in your
mohamed-ladjal
Greetings, I possess medical imagery depicting bone lesions. These images comprise 3D volumes of dimensions (256, 256, 128), with each volume containing 128 slices. Corresponding masks of identical dimensions are available. My objective is to either fine-tune or train a model using these slices to accurately segment the lesions mohamed mohamed.laadjel2019@gmail.com
- Glenn JocherUltralytics(editado)
Hello Mohamed,
Great to hear about your project on segmenting bone lesions from medical imagery! For your 3D volumes, you can approach this by treating each slice as a separate 2D image for segmentation.
Given your setup, you might consider using our YOLO26-seg models, which are well-suited for segmentation tasks. Here’s a basic example of how you could set up your training with YOLO26:
from ultralytics import YOLO

# Load a pretrained segmentation model
model = YOLO('yolo26n-seg.pt')  # Choose the appropriate model size

# Prepare your dataset in a compatible format
# Ensure your dataset directory structure and annotations are correctly set up

# Train the model
results = model.train(data='your_dataset_config.yaml', epochs=100, imgsz=640)
Make sure your dataset is annotated similarly to how COCO-Seg annotations are structured, with masks corresponding to each slice. You might need to adjust the
your_dataset_config.yamlto correctly point to your training, validation, and test images along with their annotations.For more detailed guidance on preparing your dataset and annotations, you can refer to our documentation on COCO-Seg Dataset.
If you have any more questions or need further assistance, feel free to ask. Happy training! 🚀