Labelbox 集成#
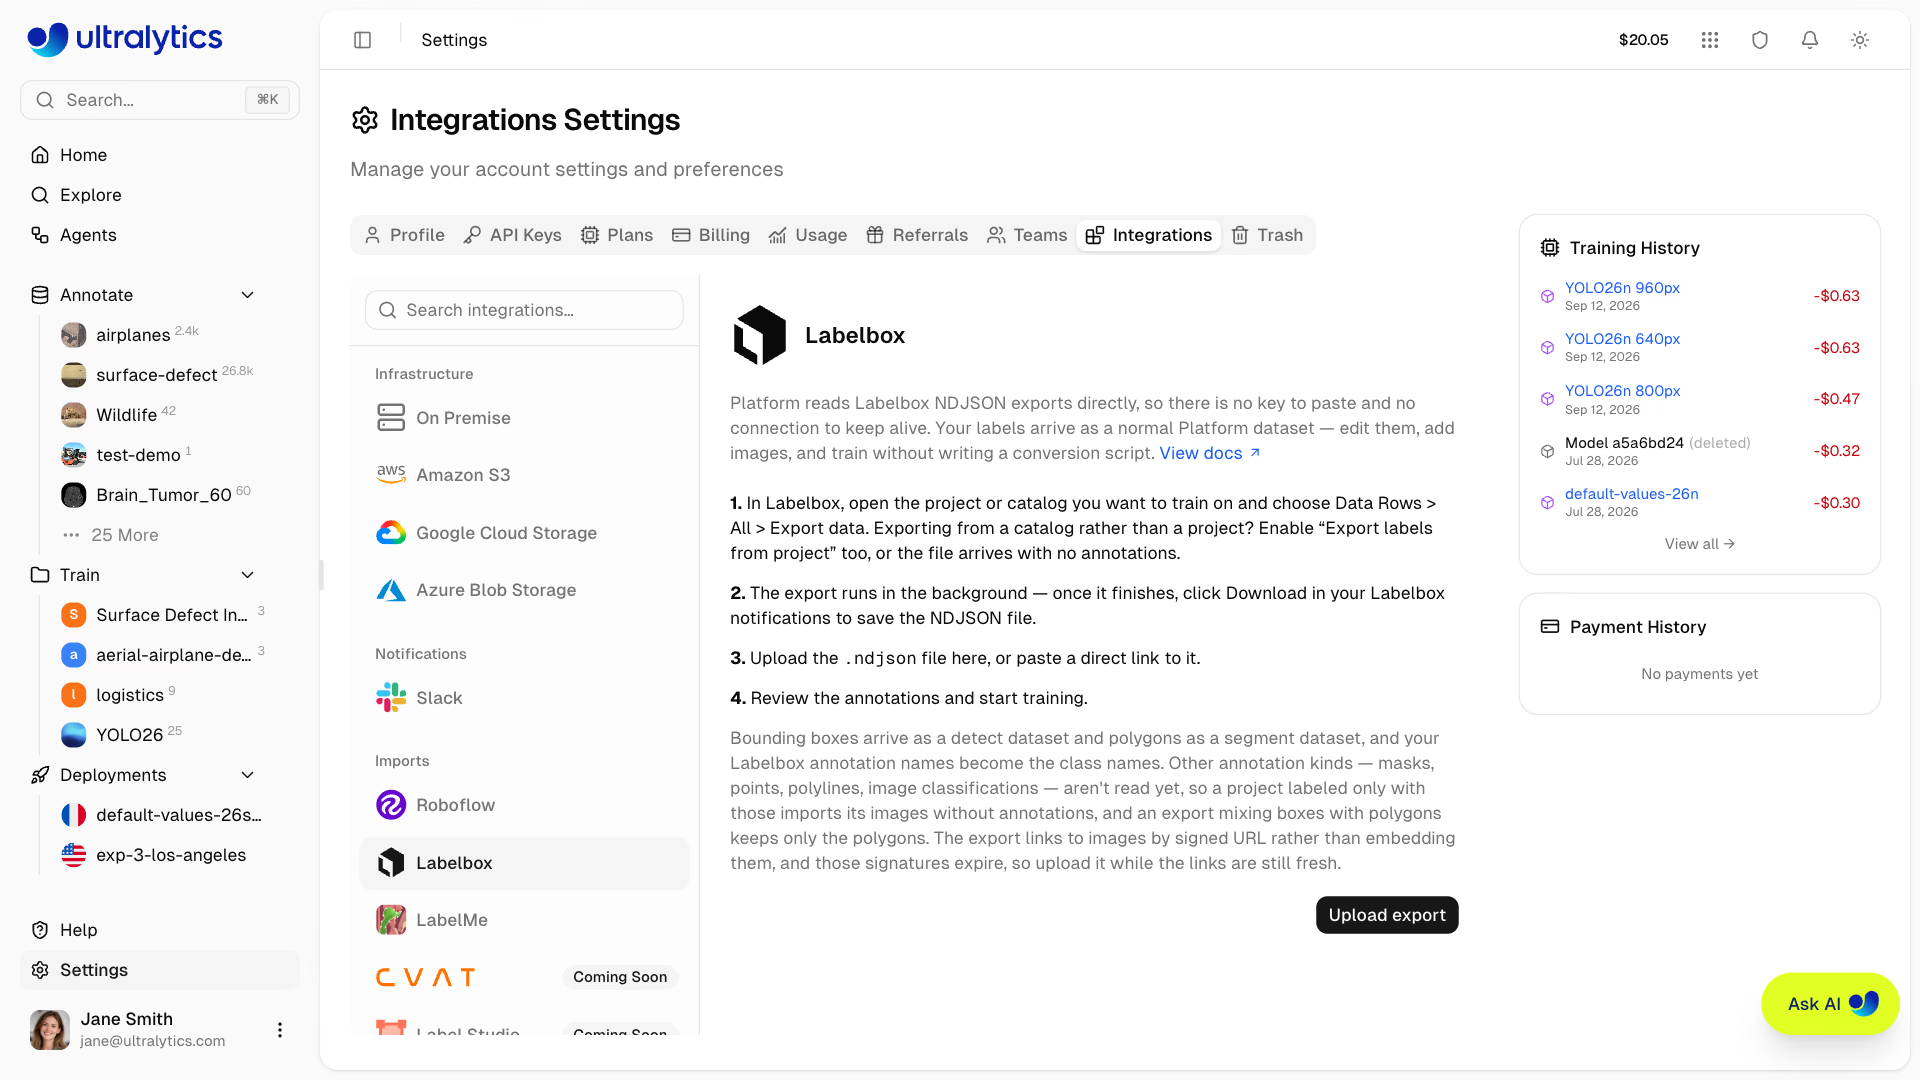
Ultralytics Platform 可直接读取 Labelbox NDJSON 导出文件。无需粘贴密钥、维持连接或维护转换脚本——从 Labelbox 导出文件并上传,你的标签就会作为普通 Platform 数据集导入。
从 Labelbox 导入#
- 从 Labelbox 导出。对于标注项目,打开其 Data Rows 选项卡,选择 All,点击 Export data,选择要包含的字段,然后确认。在 Catalog 中,选择数据行并选择 Manage selection > Export data,然后启用 Export labels from project 并选择项目;否则生成的文件将完全不含标注。
- 下载文件。Labelbox 会在后台运行导出任务。请在通知中查看任务状态,完成后点击 Download,保存
.ndjson文件。 - 上传到 Platform。创建新数据集并上传
.ndjson文件,或粘贴该文件的直接链接。你也可以从 Settings > Integrations > Labelbox 开始操作。 - 训练。处理完成后,你可以像处理任何其他 Platform 数据集一样编辑标注并训练。
与 CVAT 和 Label Studio 不同,这里无需选择格式——支持的格式就是 Labelbox 自带的导出格式。
使用 SDK 导出#
Labelbox 也在其 Python SDK 中提供导出任务,这是构建可重复运行的流水线的简便方法。以流式方式处理任务,并每行写入一个 JSON 对象:
import json

import labelbox

client = labelbox.Client(api_key="YOUR_LABELBOX_API_KEY")
export_task = labelbox.ExportTask.get_task(client, "YOUR_EXPORT_TASK_ID")
export_task.wait_till_done()  # 对尚未处于 COMPLETE 状态的任务进行流式处理会引发异常

with open("dataset.ndjson", "w") as f:
f.writelines(json.dumps(data_row.json) + "\n" for data_row in export_task.get_buffered_stream())NDJSON 是每行一个 JSON 对象。json.dump(list_of_rows, f) 则会写入单个数组,而 Platform 会跳过所有不是 JSON 对象的行——导入时完全找不到数据行。请使用上面的循环,或使用 "\n".join(json.dumps(r) for r in rows)。
导入内容#
Platform 会自动识别 Labelbox 格式,并将边界框和多边形映射到对应的 YOLO 任务类型:
每个对象的 name 会成为类别名称——因此,"name": "Dog" 标注会作为类别 Dog 导入,而不是使用其小写形式 value——导出文件中的像素坐标会根据 media_attributes 尺寸进行归一化,因此请在导出文件中保留媒体属性:没有宽度和高度的数据行会导入图像,但不包含标注。只有 Platform 能导入的对象才会注册类别,因此掩码、点和折线工具不会向数据集添加空类别。每张图像会以其 data_row.external_id 命名,其次使用 global_key;如果导出文件中两者都没有,则使用签名 URL 中的文件名。图像数据行会被导入;视频、文本和其他非图像数据行会被跳过。没有标注的 Catalog 导出文件会作为未标注图像数据集导入,可在 Platform 的标注编辑器中进行标注。
单条数据行如下所示,这里只保留 Platform 会读取的字段:
{
    "data_row": {
        "external_id": "000000000307.jpg",
        "global_key": "000000000307.jpg",
        "row_data": "https://storage.labelbox.com/...?Expires=...&Signature=..."
    },
    "media_attributes": { "height": 480, "width": 640, "mime_type": "image/jpeg" },
    "projects": {
        "<project-id>": {
            "labels": [
                {
                    "annotations": {
                        "objects": [
                            {
                                "name": "Dog",
                                "annotation_kind": "ImageBoundingBox",
                                "bounding_box": { "top": 200.0, "left": 407.0, "height": 172.0, "width": 176.0 }
                            }
                        ]
                    }
                }
            ]
        }
    }
}导出文件中的其他所有内容——embeddings、metadata_fields、attachments、project_details——都会被忽略。导出时最好取消选择嵌入项:在一个样例导出文件中,嵌入项约占文件大小的五分之四,而 Platform 实际读取的字段仅占五分之一。
目前只读取边界框和多边形,且只读取对象标注——图像级分类位于导出文件的其他位置,会被跳过。如果项目中的标注全部使用分割掩码(画笔)工具、点、折线或分类创建,图像仍会导入,但不包含标注,也不会报错。你可以在数据集页面查看:保留了标签的已导入数据集会在图像数量旁显示带标签图像数和标注数;标签丢失的数据集则不会显示这两项。
Labelbox 导出文件通过签名 URL 引用每张图像,而不是直接嵌入像素数据,且这些签名会过期。Platform 会从这些 URL 下载图像,并在开始前抽样检查;如果导出文件中的链接全部失效,导入会立即失败并说明原因——请从 Labelbox 重新导出并上传新文件。如果只有部分链接过期,仍可访问的图像会被导入,其余图像则会被跳过,因此请在导出后尽快上传。
同时包含边界框和多边形的导出文件会作为分割数据集导入,而分割数据集只保留多边形几何——框标注不会用于训练,也不会包含在版本导出文件中。如果两者都需要,请将框和多边形分别导出为独立的 Labelbox 项目。多边形至少需要三个点才能被读取。
常见问题#
Platform 读取 NDJSON,即每行一个 JSON 对象。以单个 JSON 数组形式保存的导出文件会被整体跳过。请使用上面的 SDK 循环,或下载 Labelbox 自带的 Export data 文件,该文件本身就是 NDJSON。
Labelbox 导出文件通过签名 URL 引用图像,这些签名会过期。请从 Labelbox 重新导出,并在导出完成后尽快上传新文件。
不可以。混合导出文件会作为分割数据集导入,且只会使用多边形。如果两者都需要,请将边界框和多边形分别导出为独立的 Labelbox 项目。