Azure Blob Storage 集成#
Azure Blob Storage 集成可将你的存储帐户容器连接到 Ultralytics Platform。你的图像会留在容器中,Platform 会直接为其建立索引,因此你可以浏览、标注并训练 YOLO 模型,无需上传副本。
Azure Blob Storage 数据集需要专业版或企业版套餐。免费工作区可以看到此集成,但在连接时会收到升级提示。如果订阅到期,现有 Azure Blob Storage 数据集仍可完全访问;只有新建连接和导入才需要专业版套餐。
获取连接字符串#
Platform 只会读取你的存储,不会写入、修改或删除你的 Blob。当前集成要求使用帐户访问密钥连接字符串;虽然 Platform 只执行列出和读取操作,但该字符串授予的权限覆盖整个帐户:
- 在 Azure 门户中打开你的存储帐户。
- 前往 安全性 + 网络 > 访问密钥。
- 复制连接字符串。
该字符串必须包含 AccountName、AccountKey,并使用 HTTPS 作为协议,也就是 Azure 在 访问密钥下提供的格式。SAS 令牌连接字符串会被拒绝,因为其中包含 SharedAccessSignature,而不是 AccountKey。
连接使用标准的 blob.core.windows.net 终结点。不支持主权云(Azure China、Azure Government)和自定义 Blob 终结点。
连接到 Platform#
- 前往 设置 > 集成,然后从集成列表中选择 Azure Blob Storage。
- 粘贴连接字符串。
- 点击 查找可用容器,然后选择要连接的容器。你也可以手动输入容器名称。
- 点击 连接。Platform 会在保存任何信息之前,验证是否能够列出并读取每个选定的容器。
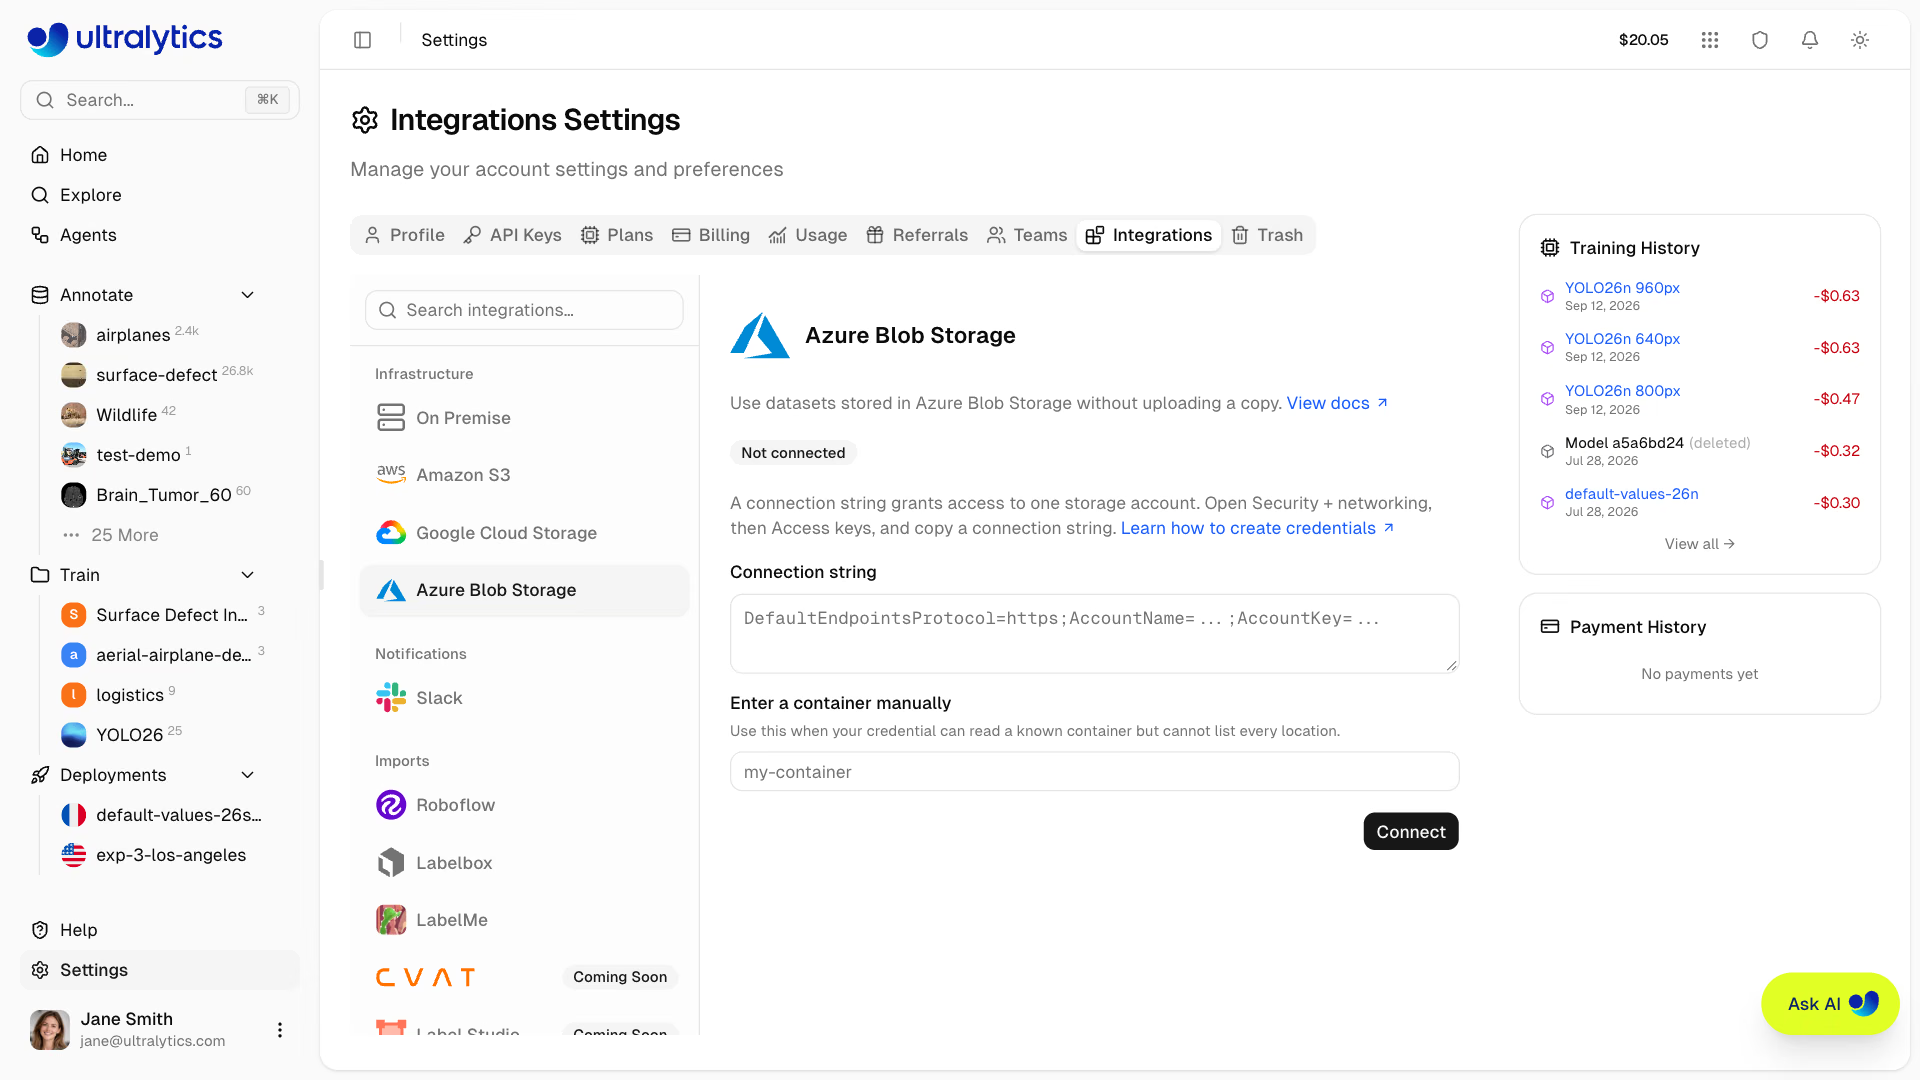
你需要拥有工作区管理员或所有者角色,才能连接云存储。一个连接最多可包含 50 个容器,发现功能最多可列出存储帐户中的 300 个容器。
之后重新连接同一存储帐户时,新容器会添加到现有集成中。只有在新凭据仍能读取你已连接的所有容器时,才会替换已保存的凭据。
如果帐户密钥在 Platform 之外泄露,它可用于授权写入和删除操作,或创建 SAS 令牌。凭据采用 AES-256-GCM 静态加密,不会返回给浏览器,也不会暴露给训练工作负载。条件允许时,请使用专用存储帐户。若要撤销访问权限,请在 Azure 中轮换存储帐户访问密钥。
从 Blob 容器创建数据集#
- 点击 New Dataset,然后打开 Cloud 标签页。
- 选择一个已连接的容器,然后浏览到包含数据的文件夹。
- 确认文件夹,调整数据集名称,然后创建数据集。
Platform 会列出该文件夹一次,并为找到的内容建立索引:
- 图像 —
.jpg、.jpeg、.png、.webp和.avifBlob 会建立索引,图像尺寸通过有界请求读取。Platform 不会持久保存源图像的第二份副本。 - 标签 — YOLO
.txt附属文件会解析为 Platform 标注,并按照标准的images/→labels/目录结构进行匹配,或与同一文件夹中的文件进行匹配。 - 元数据 — YAML 文件会提供类别名称和姿态关键点形状,与压缩包上传的处理方式完全相同。如果文件夹中有多个文件,则优先使用
data.yaml和data.yml。 - 任务 — 系统会根据部分标签文件判断任务,因此会依据标签形状识别分割、姿态和 OBB 文件夹,而不是依据你在对话框中选择的任务。
- 数据集划分 — Blob 路径中的
train、val和test文件夹名称会自动分配数据集划分。
此后,该数据集的使用方式与其他数据集相同:你可以浏览并标注,将其设为公开或私有,与团队共享,并通过托管训练在其上训练。原始图像会按需流式传输,已建立索引的图像不会占用 Platform 的存储配额。
单次导入最多可为 500,000 个 Blob 建立索引,标签文件或 YAML 文件的大小上限为每个 1 MB。较大的容器应拆分到多个数据集中。
每张已建立索引的图像都会绑定到其 Blob ETag;如果 Blob 在此期间发生变化,Platform 会拒绝继续操作。请添加新 Blob,而不要覆盖现有 Blob。
导入失败#
如果导入失败(例如文件夹为空、路径拼写错误或权限被撤销),数据集页面会显示错误。编辑者可以点击 重试导入,使用已保存的容器和文件夹重新启动导入;也可以创建指向正确路径的新数据集。
重试时会重新列出文件夹,而不是从中断处继续:首次尝试后添加的 Blob 会被纳入,不再存在的 Blob 则会从数据集中移除。
训练#
托管训练采用常规训练流程。训练期间会使用 Platform 自己保存的已固定图像副本;你的 Azure 凭据绝不会暴露给训练工作负载。
断开连接#
断开连接会删除已存储的连接字符串,但不会触及 Azure 中的任何内容。基于这些容器构建的数据集仍会保留在你的工作区中,包括类别、标签和标注;但在重新连接同一存储帐户之前,无法加载、预览或训练其中的图像。
使用 REST API 和 GET /api/integrations/buckets 返回的集成 ID:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")若要直接从源端撤销访问权限,请在 Azure 中轮换存储帐户访问密钥。
当前限制#
Azure 支持的数据集目前不支持需要由 Platform 保存图像副本的功能:自动标注、聚类分析、数据集克隆和不可变的版本快照。
删除 Azure 支持的数据集或其中的单张图像,只会移除 Platform 保存的引用,不会触及你的 Blob。
另请参阅 Google Cloud Storage 和 Amazon S3 集成。
常见问题#
不会。Platform 会列出容器一次,并为找到的图像尺寸和标签建立索引。浏览和标注时会按需流式传输原始图像;托管训练则只会在训练期间使用 Platform 自己保存的已固定图像副本。已建立索引的图像不会计入你的存储配额。
数据集在创建时只建立一次索引。只有创建新数据集或重试失败的导入,才能纳入新对象;每张已建立索引的图像都会绑定到其版本,因此覆盖对象会导致 Platform 对该图像采取关闭失败措施。请添加新对象,而不要替换现有对象。
在 设置 > 集成中断开集成,以删除已存储的凭据;或者在 Azure 中轮换存储帐户访问密钥。这两种操作都不会触及容器中的数据。