Google Cloud Storage 集成#
Google Cloud Storage集成可将你的 GCS 存储桶连接到 Ultralytics Platform。图像会保留在你的存储桶中 — Platform 会直接为其创建索引,因此你无需上传副本即可浏览、标注并训练 YOLO 模型。
Google Cloud Storage 数据集需要Pro 或 Enterprise 计划。免费工作区可以看到此集成,连接时系统会提示你升级。如果订阅到期,现有 Google Cloud Storage 数据集仍可正常访问 — 只有新连接和导入需要 Pro。
创建只读服务账号#
Platform 只会读取你的存储空间 — 从不写入、修改或删除对象。请创建一个只有读取权限的专用服务账号:
- 在 Google Cloud 控制台中,前往 IAM & Admin > Service Accounts,然后创建服务账号。
- 为该账号授予要连接的存储桶上的 Storage Object Viewer(
roles/storage.objectViewer)角色。 - 打开服务账号,选择 Keys > Add key > Create new key,选择 JSON,然后下载密钥文件。
roles/storage.objectViewer 涵盖 Platform 对你的数据执行的所有操作,但不允许列出 项目中的存储桶。如果希望 Platform 自动查找存储桶,请添加包含 storage.buckets.list 的角色; 否则,连接时请手动输入每个存储桶的名称。
连接到 Platform#
- 前往 Settings > Integrations,然后从集成列表中选择 Google Cloud Storage。
- 粘贴服务账号 JSON 密钥的内容。
- 点击 Find available buckets,然后选择要连接的存储桶。如果服务账号无法列出存储桶, 请手动输入已知的存储桶名称。
- 点击 Connect。Platform 会先验证能否列出并读取每个选定的存储桶,然后才会保存任何内容。
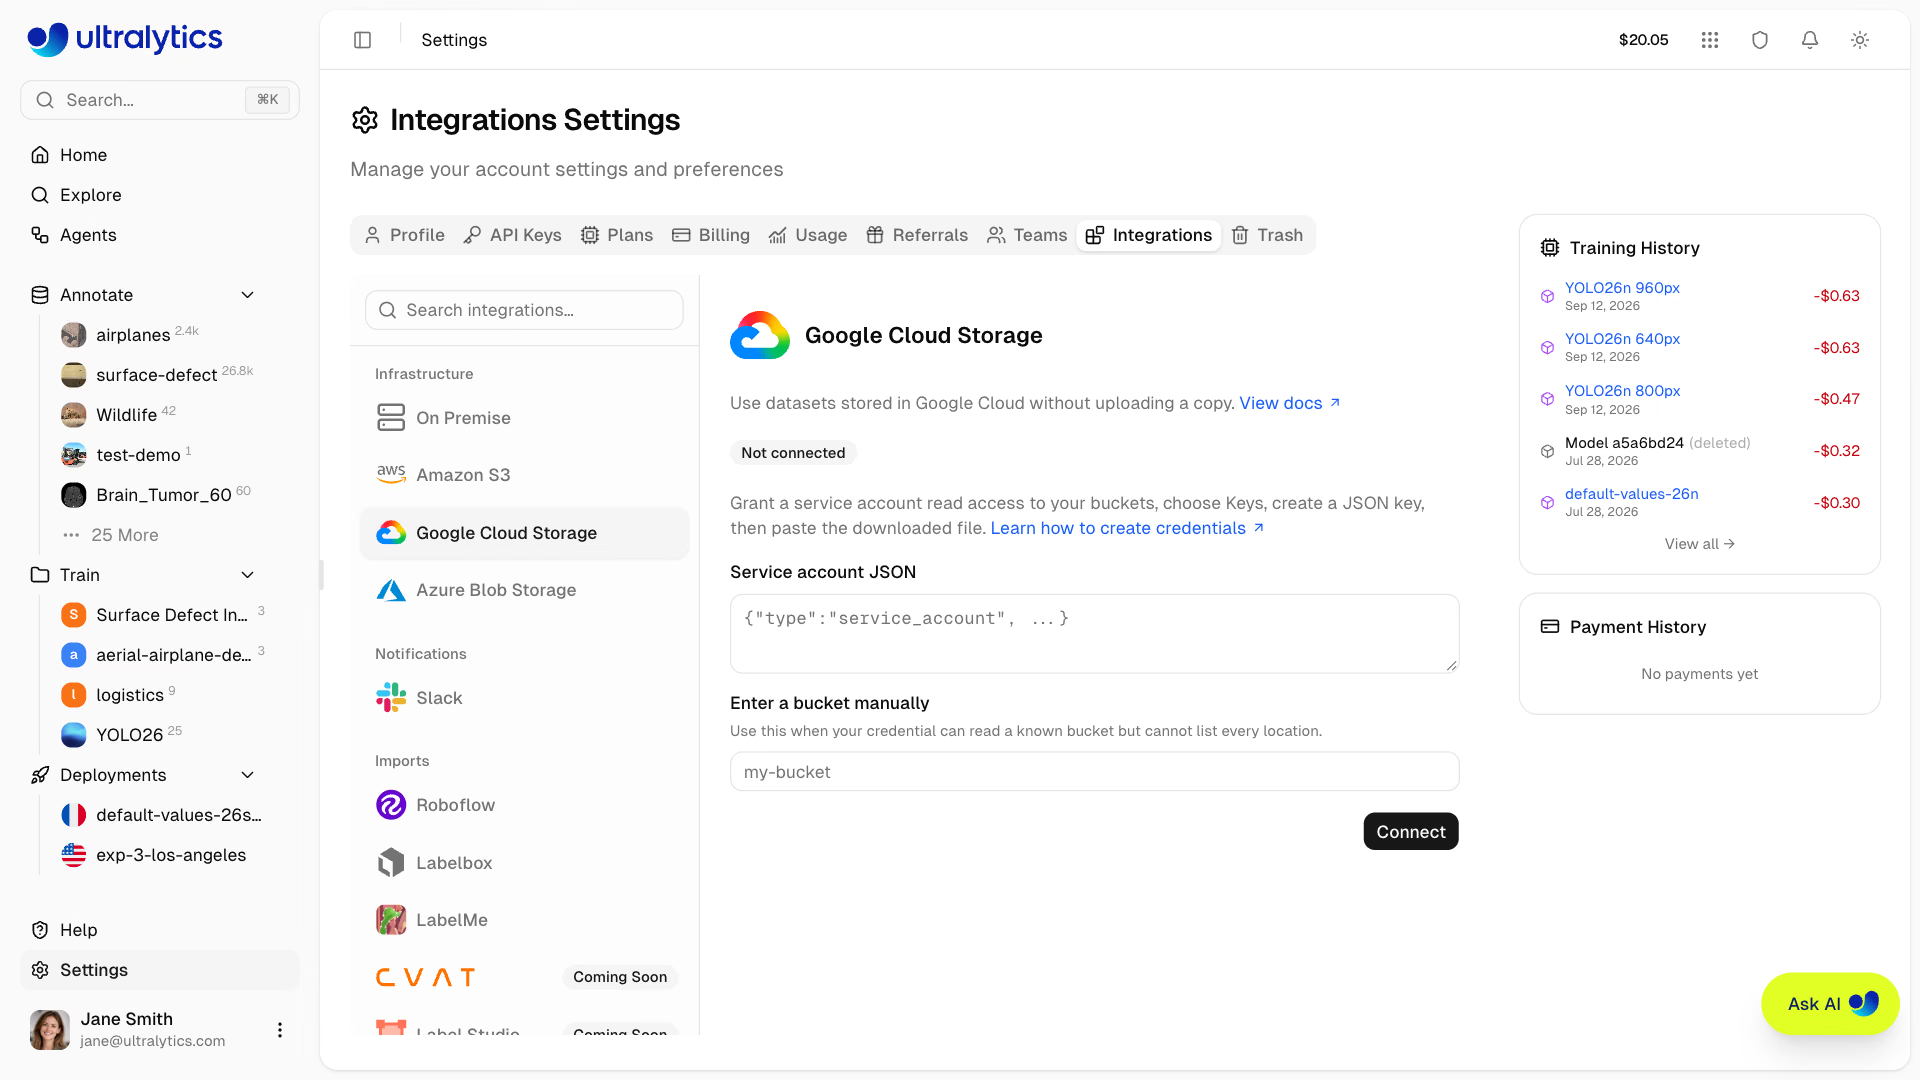
你需要拥有工作区管理员或所有者角色才能连接云存储。你 每次最多可以添加 50 个存储桶,发现功能最多会列出服务账号可见的 300 个存储桶。
浏览器会读取你粘贴的密钥文件,只发送 Platform 所需的三个字段 — client_email、private_key, 以及 project_id。JSON 中的其他内容不会离开当前页面。
稍后重新连接同一个服务账号时,新存储桶会添加到现有集成中。只有在替换凭据仍能读取你已连接的所有存储桶时,已保存的凭据才会被替换。如果任何存储桶无法读取,错误信息会指出该存储桶,包括之前使用同一服务账号连接的存储桶。
凭据使用 AES-256-GCM 加密静态存储,不会返回到浏览器,也不会暴露给训练工作负载。若要撤销访问权限,请在 Google Cloud 中删除服务账号密钥。
从 GCS 存储桶创建数据集#
- 点击 New Dataset,然后打开 Cloud 选项卡。
- 选择已连接的存储桶,然后浏览到包含数据的文件夹。
- 确认文件夹,调整数据集名称,然后创建数据集。
Platform 会列出该文件夹一次,并为找到的内容创建索引:
- 图像 —
.jpg、.jpeg、.png、.webp和.avif对象会被编入索引,图像尺寸通过有界 请求读取。Platform 不会持久保存源图像的第二份副本。 - 标签 — YOLO
.txt旁路文件会被解析为 Platform 标注,并按照标准的images/→labels/目录结构进行匹配,也可以作为同一文件夹中的同级文件匹配。 - 元数据 — YAML 文件会提供类别名称和姿态关键点形状,与压缩包上传的处理方式完全相同。如果文件夹中有多个文件,则优先使用
data.yaml和data.yml。 - 任务 — 系统会根据一组标签文件判断任务,因此即使你在对话框中选择了其他任务,也能根据标签形状识别分割、姿态和 OBB 文件夹。
- 划分 — 对象路径中的
train、val和test文件夹名称会自动指定数据划分。
此数据集之后的使用方式与其他数据集相同:浏览并标注,将其设为公开或私有,与团队共享,并通过托管训练进行训练。原始文件会按需流式传输,已编入索引的图像不会占用 Platform 的存储配额。
单次导入最多可索引 500,000 个对象,标签文件或 YAML 文件大小最多为 1 MB。较大的存储桶应拆分到多个数据集中。
每张已索引图像都固定到其 GCS 对象的代次;如果对象在此期间发生变化,Platform 会采取默认拒绝策略。请添加新对象,而不要覆盖现有对象。
导入失败#
如果导入失败(例如文件夹为空、路径拼写错误或权限被撤销),数据集页面会显示错误。编辑者可以点击 重试导入,使用已存储的存储桶和文件夹重新开始导入;也可以创建一个指向正确路径的新数据集。
重试时会重新列出文件夹,而不是从中断处继续:首次尝试后新增的对象会被纳入,不再存在的对象则会从数据集中移除。
训练#
托管训练可通过常规训练流程进行。训练期间会使用 Platform 自己保存的已固定图像副本,你的 Google Cloud 凭据绝不会暴露给训练工作负载。
断开连接#
断开连接会删除已存储的凭据,但不会触及 Google Cloud 中的任何内容。基于这些存储桶构建的数据集会保留在你的工作区中,其中的类别、标签和标注也会保留;但在重新连接同一服务账号之前,无法加载、预览或训练其中的图像。断开连接期间,你仍可重命名数据集、编辑标签或删除数据集。
如需断开连接,请前往 Settings > Integrations,选择 Google Cloud Storage,点击凭据旁边的 Disconnect,然后确认。之后打开相关数据集时,会显示 Google Cloud Storage Disconnected,并提供返回这些设置的链接;重新连接后,数据集会自动恢复。
你也可以使用 REST API 断开连接,并使用 GET /api/integrations/buckets 返回的集成 ID:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")如果要直接在源端撤销访问权限,请在 Google Cloud 中删除服务账号密钥。
当前限制#
GCS 数据集目前不支持需要 Platform 自己保存图像副本的功能:自动标注、聚类分析、数据集克隆,以及不可变的版本快照。
删除 GCS 数据集或其中的单张图像,只会移除 Platform 对这些对象的引用,不会触及你的对象。
另请参阅 Amazon S3 和 Azure Blob Storage 集成。
常见问题#
不会。Platform 只会列出存储桶一次,并索引找到的图像尺寸和标签。浏览和标注时会按需流式传输原始图像;托管训练则只会在训练期间使用 Platform 自己保存的已固定图像副本。已索引图像不计入你的存储配额。
数据集在创建时只会索引一次。只有创建新数据集或重试失败的导入,才能纳入新对象;每张已索引图像都会固定到其版本,因此覆盖对象会导致 Platform 对相应图像采取默认拒绝策略。请添加新对象,而不要替换现有对象。
在 Settings > Integrations 中断开集成以删除已存储的凭据,或者在 Google Cloud 中删除服务账号密钥。这两种操作都不会触及存储桶中的数据。