Ultralytics YOLO26 auf NVIDIA Jetson mit DeepStream SDK und TensorRT#
Ansehen: So verwendest du Ultralytics YOLO26-Modelle mit NVIDIA DeepStream auf Jetson Orin NX 🚀
Diese umfassende Anleitung führt dich Schritt für Schritt durch die Bereitstellung von Ultralytics YOLO26 auf NVIDIA Jetson-Geräten mit DeepStream SDK und TensorRT. Hier verwenden wir TensorRT, um die Inferenzleistung auf der Jetson-Plattform zu maximieren.
Diese Anleitung führt dich durch die DeepStream-Konfiguration für YOLO26, die INT8-Kalibrierung, die Einrichtung mehrerer Streams und die Benchmark-Ergebnisse.
Diese Anleitung wurde mit dem NVIDIA Jetson Orin Nano Super Developer Kit getestet, auf dem die JetPack-Version JP6.1 läuft, mit dem Seeed Studio reComputer J4012, das auf NVIDIA Jetson Orin NX 16GB basiert und mit der JetPack-Version JP5.1.3 läuft, sowie mit dem Seeed Studio reComputer J1020 v2, das auf NVIDIA Jetson Nano 4GB basiert und mit der JetPack-Version JP4.6.4 läuft. Die Anleitung sollte mit der gesamten NVIDIA-Jetson-Hardwarepalette funktionieren, einschließlich der neuesten und älteren Modelle.
Was ist NVIDIA DeepStream?#
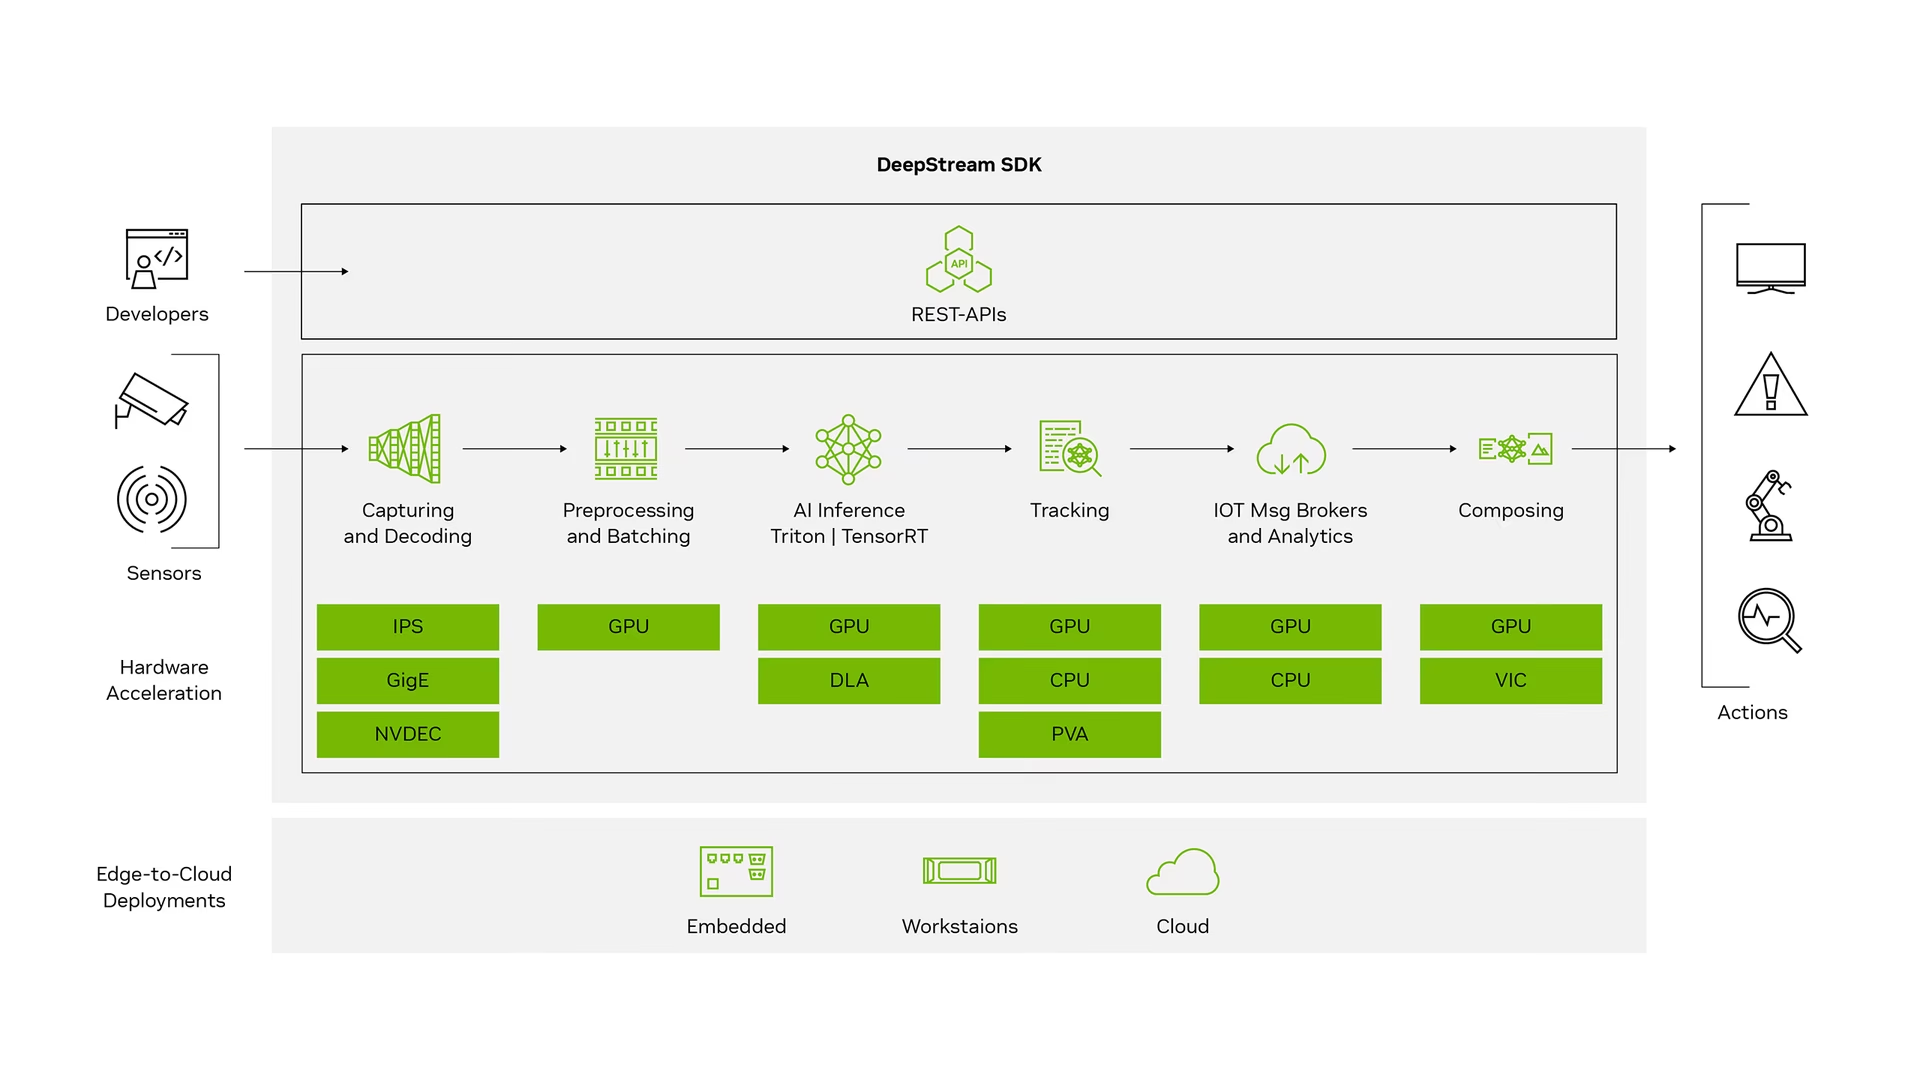
Das DeepStream SDK von NVIDIA ist ein umfassendes Streaming-Analyse-Toolkit auf GStreamer-Basis für KI-gestützte Verarbeitung mehrerer Sensoren sowie für Video-, Audio- und Bildverarbeitung. Es eignet sich ideal für Entwickler von Vision-KI, Softwarepartner, Start-ups und OEMs, die IVA-Apps (Intelligente Videoanalyse) und -Dienste entwickeln. Du kannst jetzt Pipelines zur Stream-Verarbeitung erstellen, die neuronale Netze und andere komplexe Verarbeitungsaufgaben wie Tracking, Video-Kodierung und -Dekodierung sowie Videorendering umfassen. Diese Pipelines ermöglichen Echtzeitanalysen von Video-, Bild- und Sensordaten. Dank der Unterstützung mehrerer Plattformen kannst du mit DeepStream schneller und einfacher Vision-KI-Anwendungen und -Dienste lokal, am Edge und in der Cloud entwickeln.
Voraussetzungen#
Bevor du mit dieser Anleitung beginnst:
- Richte dein NVIDIA-Jetson-Gerät mit Ultralytics YOLO26 anhand unserer Dokumentation ein: Kurzanleitung: NVIDIA Jetson mit Ultralytics YOLO26
- Installiere DeepStream SDK passend zu deiner JetPack-Version.
- Installiere für JetPack 4.6.4 DeepStream 6.0.1.
- Installiere für JetPack 5.1.3 DeepStream 6.3.
- Installiere für JetPack 6.1 DeepStream 7.1.
- Installiere für JetPack 7.1 DeepStream 9.0.
In dieser Anleitung verwenden wir die Debian-Paketmethode, um DeepStream SDK auf dem Jetson-Gerät zu installieren. Unter DeepStream SDK auf Jetson (archiviert) findest du auch ältere DeepStream-Versionen.
DeepStream-Konfiguration für YOLO26#
Hier verwenden wir das GitHub-Repository marcoslucianops/DeepStream-Yolo, das Unterstützung für YOLO-Modelle mit NVIDIA DeepStream SDK bietet. Wir schätzen die Beiträge von marcoslucianops sehr!
-
Installiere Ultralytics mit den erforderlichen Abhängigkeiten
pip install ultralytics onnx onnxslim -
Klone das DeepStream-Yolo-Repository
cd ~ git clone https://github.com/marcoslucianops/DeepStream-Yolo -
Lade ein Ultralytics-YOLO26-Erkennungsmodell (.pt) deiner Wahl aus dem YOLO26-Projekt herunter. Hier verwenden wir yolo26s.pt.
wget https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26s.pt
Du kannst auch ein benutzerdefiniert trainiertes YOLO26-Modell verwenden.
-
Konvertiere das Modell in ONNX und schreibe die Datei
labels.txt, aus der DeepStream die Klassennamen liest.from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # erstellt 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))
nms=False exportiert den NMS-freien Kopf, und agnostic_nms=True behält eine einzelne Klasse pro Erkennung bei, damit cluster-mode=4 (kein Clustering) in der DeepStream-Konfiguration keine Box doppelt zeichnet. Füge imgsz=1280 hinzu, um die Inferenzgröße zu ändern (Standard: 640), batch=4 für eine Batchgröße von 4 (der exportierte Batch ist statisch und muss daher mit batch-size in der DeepStream-Konfiguration übereinstimmen) und opset=12 für TensorRT 8.2 oder älter (DeepStream 6.0.1 und früher). Die vollständige Liste findest du unter Exportargumente.
-
Kopiere die generierte Modelldatei
.onnxund die Dateilabels.txtin den OrdnerDeepStream-Yolo.cp yolo26s.onnx labels.txt ~/DeepStream-Yolo cd ~/DeepStream-Yolo -
Lege die CUDA-Version entsprechend der installierten JetPack-Version fest.
Für JetPack 4.6.4:
export CUDA_VER=10.2Für JetPack 5.1.3:
export CUDA_VER=11.4Für JetPack 6.1:
export CUDA_VER=12.6Für JetPack 7.1:
export CUDA_VER=13.0 -
Kompiliere die Bibliothek.
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Bearbeite die Datei
config_infer_primary_yolo26.txtpassend zu deinem Modell (für YOLO26s mit 80 Klassen).[property] ... onnx-file=yolo26s.onnx ... num-detected-classes=80 ... parse-bbox-func-name=NvDsInferParseYolo ...
YOLO26 passt die Eingabegröße durch zentriertes Padding an und läuft ohne NMS. Für die beste Genauigkeit füge Folgendes im Abschnitt [property] der Datei config_infer_primary_yolo26.txt hinzu:
[property]
...
maintain-aspect-ratio=1
symmetric-padding=1
cluster-mode=4
...-
Bearbeite die Datei
deepstream_app_config.... [primary-gie] ... config-file=config_infer_primary_yolo26.txt -
Du kannst auch die Videoquelle in der Datei
deepstream_app_configändern. Hier wird eine Standardvideodatei geladen.... [source0] ... uri=file:///opt/nvidia/deepstream/deepstream/samples/streams/sample_1080p_h264.mp4
Inferenz ausführen#
deepstream-app -c deepstream_app_config.txtBevor die Inferenz startet, dauert es lange, die TensorRT-Engine-Datei zu erstellen. Bitte hab etwas Geduld.
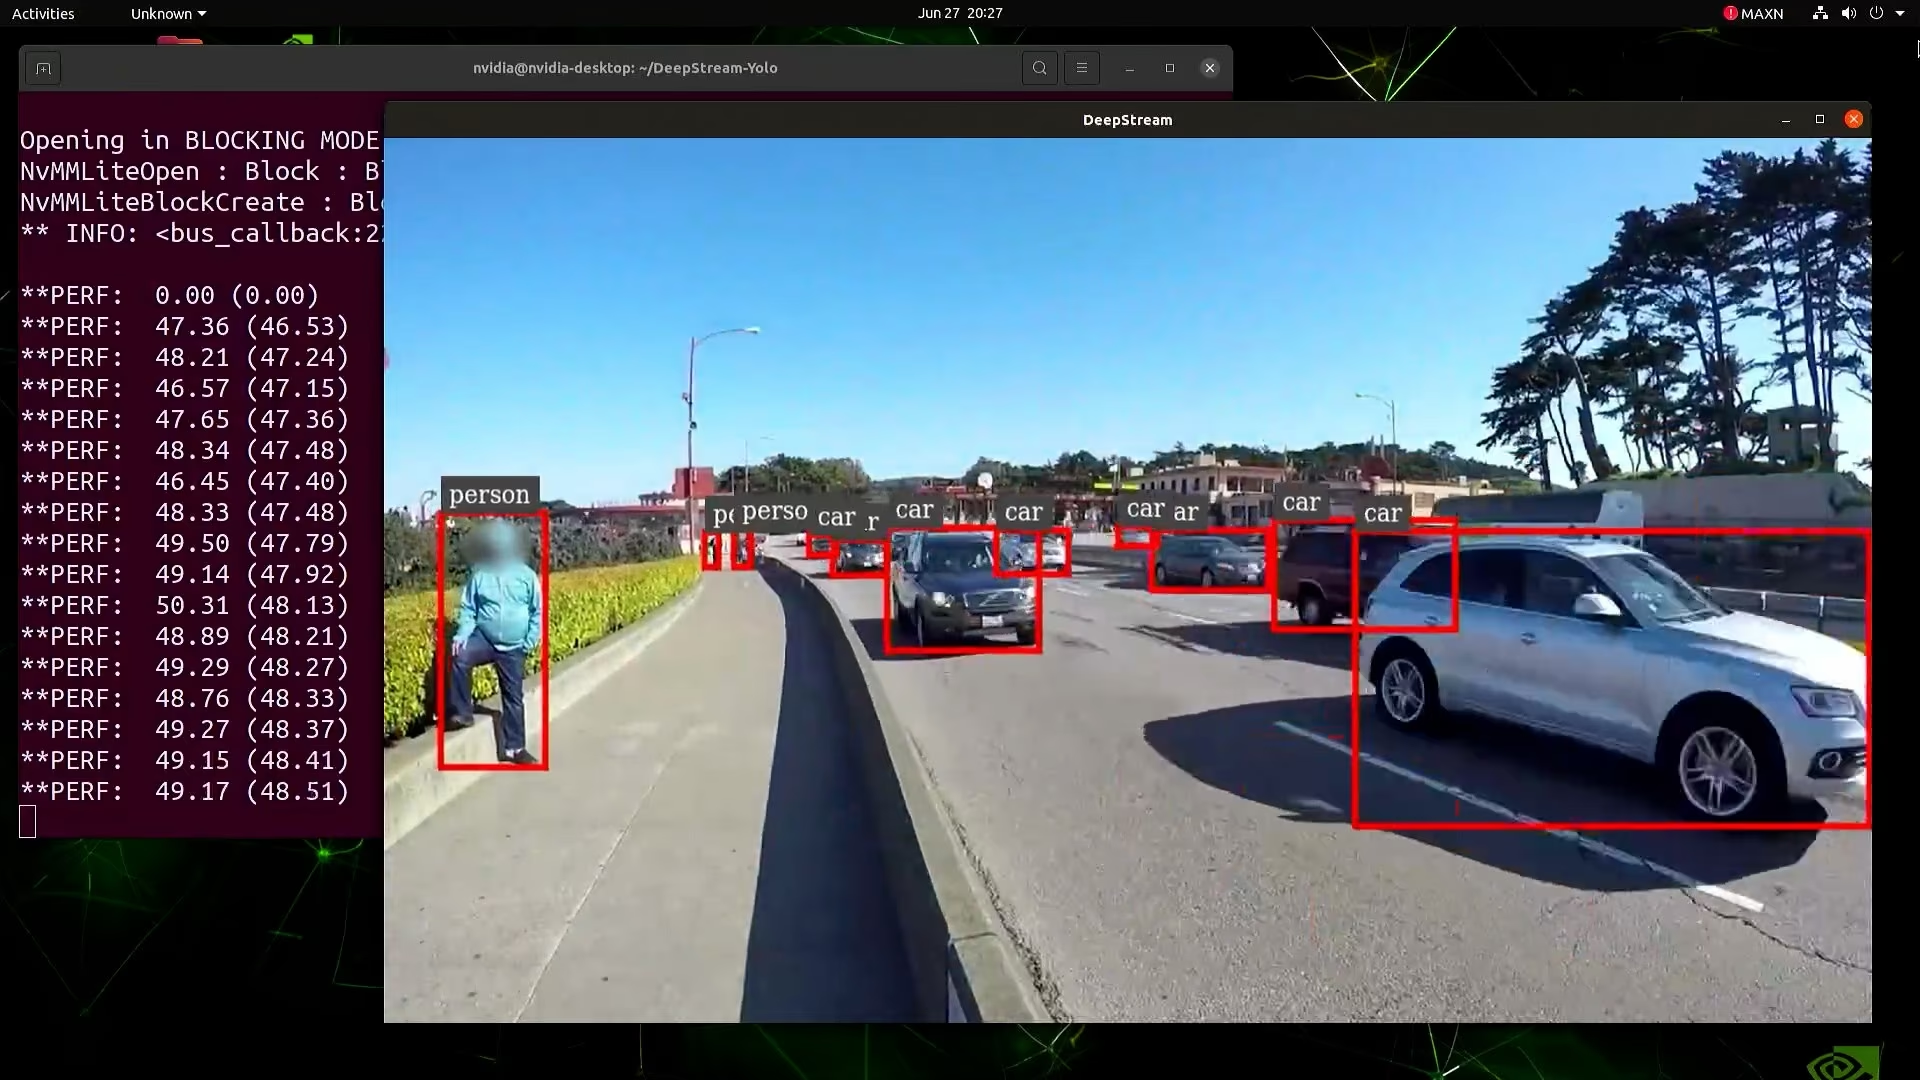
Wenn du das Modell mit FP16-Präzision konvertieren möchtest, setze einfach model-engine-file=model_b1_gpu0_fp16.engine und network-mode=2 in config_infer_primary_yolo26.txt.
INT8-Kalibrierung#
Wenn du für die Inferenz INT8-Präzision verwenden möchtest, musst du die folgenden Schritte ausführen:
INT8 funktioniert derzeit nicht mit TensorRT 10.x. Dieser Abschnitt der Anleitung wurde mit TensorRT 8.x getestet, womit es voraussichtlich funktioniert.
-
Lege die Umgebungsvariable
OPENCVfest.export OPENCV=1 -
Kompiliere die Bibliothek.
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Lade für den COCO-Datensatz val2017 herunter, entpacke die Datei und verschiebe sie in den Ordner
DeepStream-Yolo. -
Erstelle ein neues Verzeichnis für die Kalibrierungsbilder.
mkdir calibration -
Führe Folgendes aus, um 1000 zufällige Bilder aus dem COCO-Datensatz für die Kalibrierung auszuwählen.
for jpg in $(ls -1 val2017/*.jpg | sort -R | head -1000); do
  cp ${jpg} calibration/
done
NVIDIA empfiehlt mindestens 500 Bilder, um eine gute Genauigkeit zu erreichen. In diesem Beispiel werden 1000 Bilder ausgewählt, um eine höhere Genauigkeit zu erzielen (mehr Bilder = höhere Genauigkeit). Du kannst die Anzahl mit head -1000 festlegen. Für 2000 Bilder zum Beispiel head -2000. Dieser Vorgang kann lange dauern.
-
Erstelle die Datei
calibration.txtmit allen ausgewählten Bildern.realpath calibration/*jpg > calibration.txt -
Lege die Umgebungsvariablen fest.
export INT8_CALIB_IMG_PATH=calibration.txt
export INT8_CALIB_BATCH_SIZE=1
Höhere Werte für INT8_CALIB_BATCH_SIZE führen zu höherer Genauigkeit und schnellerer Kalibrierung. Lege den Wert entsprechend dem Speicher deiner GPU fest.
-
Aktualisiere die Datei
config_infer_primary_yolo26.txt.Von
...
model-engine-file=model_b1_gpu0_fp32.engine
#int8-calib-file=calib.table
...
network-mode=0
...
Zu
...
model-engine-file=model_b1_gpu0_int8.engine
int8-calib-file=calib.table
...
network-mode=1
...
INT8-Inferenz ausführen#
Führe denselben Befehl aus, um die INT8-Engine zu erstellen und die Inferenz zu starten:
deepstream-app -c deepstream_app_config.txtEinrichtung mehrerer Streams#
Ansehen: So führst du Inferenz mit mehreren Streams mithilfe von Ultralytics YOLO26 und NVIDIA DeepStream auf Jetson Orin aus 🚀
Um mehrere Streams in einer einzelnen DeepStream-Anwendung einzurichten, nimm die folgenden Änderungen an der Datei deepstream_app_config.txt vor:
-
Ändere die Zeilen und Spalten, um ein Raster entsprechend der gewünschten Anzahl von Streams zu erstellen. Für 4 Streams kannst du zum Beispiel 2 Zeilen und 2 Spalten hinzufügen.
[tiled-display] rows=2 columns=2 -
Füge für jeden Stream eine eigene Gruppe
[sourceN]hinzu, jeweils mit eigenenuriundnum-sources=1.[source0] enable=1 type=3 uri=file:///path/to/video1.mp4 num-sources=1 [source1] enable=1 type=3 uri=file:///path/to/video2.mp4 num-sources=1 [source2] enable=1 type=3 uri=file:///path/to/video3.mp4 num-sources=1 [source3] enable=1 type=3 uri=file:///path/to/video4.mp4 num-sources=1
Inferenz mit mehreren Streams ausführen#
Führe denselben Befehl aus, um alle Streams in der gekachelten Anzeige zu starten:
deepstream-app -c deepstream_app_config.txt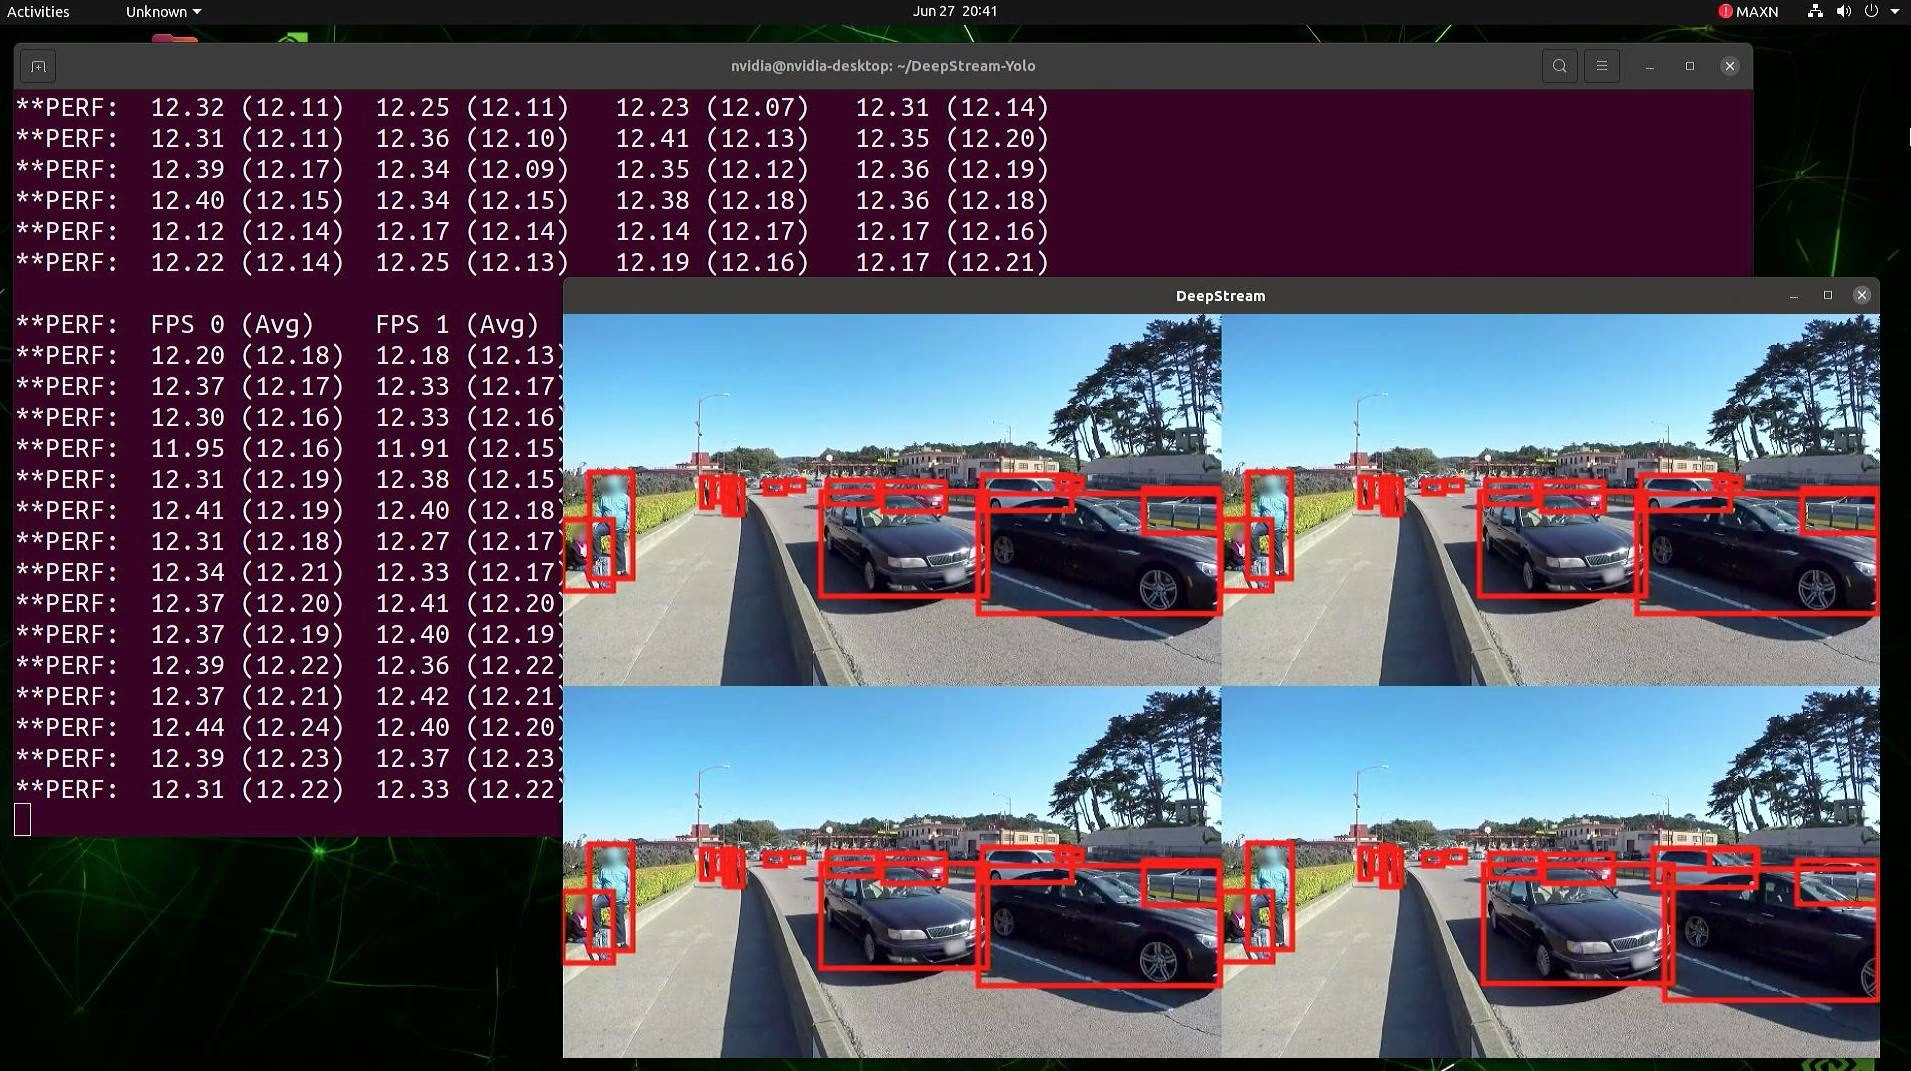
Benchmark-Ergebnisse#
Die folgenden Benchmarks zeigen die Leistung von YOLO11-Modellen mit verschiedenen TensorRT-Präzisionsstufen und einer Eingabegröße von 640x640 auf NVIDIA Jetson Orin NX 16GB. YOLO26 verwendet denselben oben beschriebenen DeepStream-Export- und Inferenzablauf.
Vergleichsdiagramm#
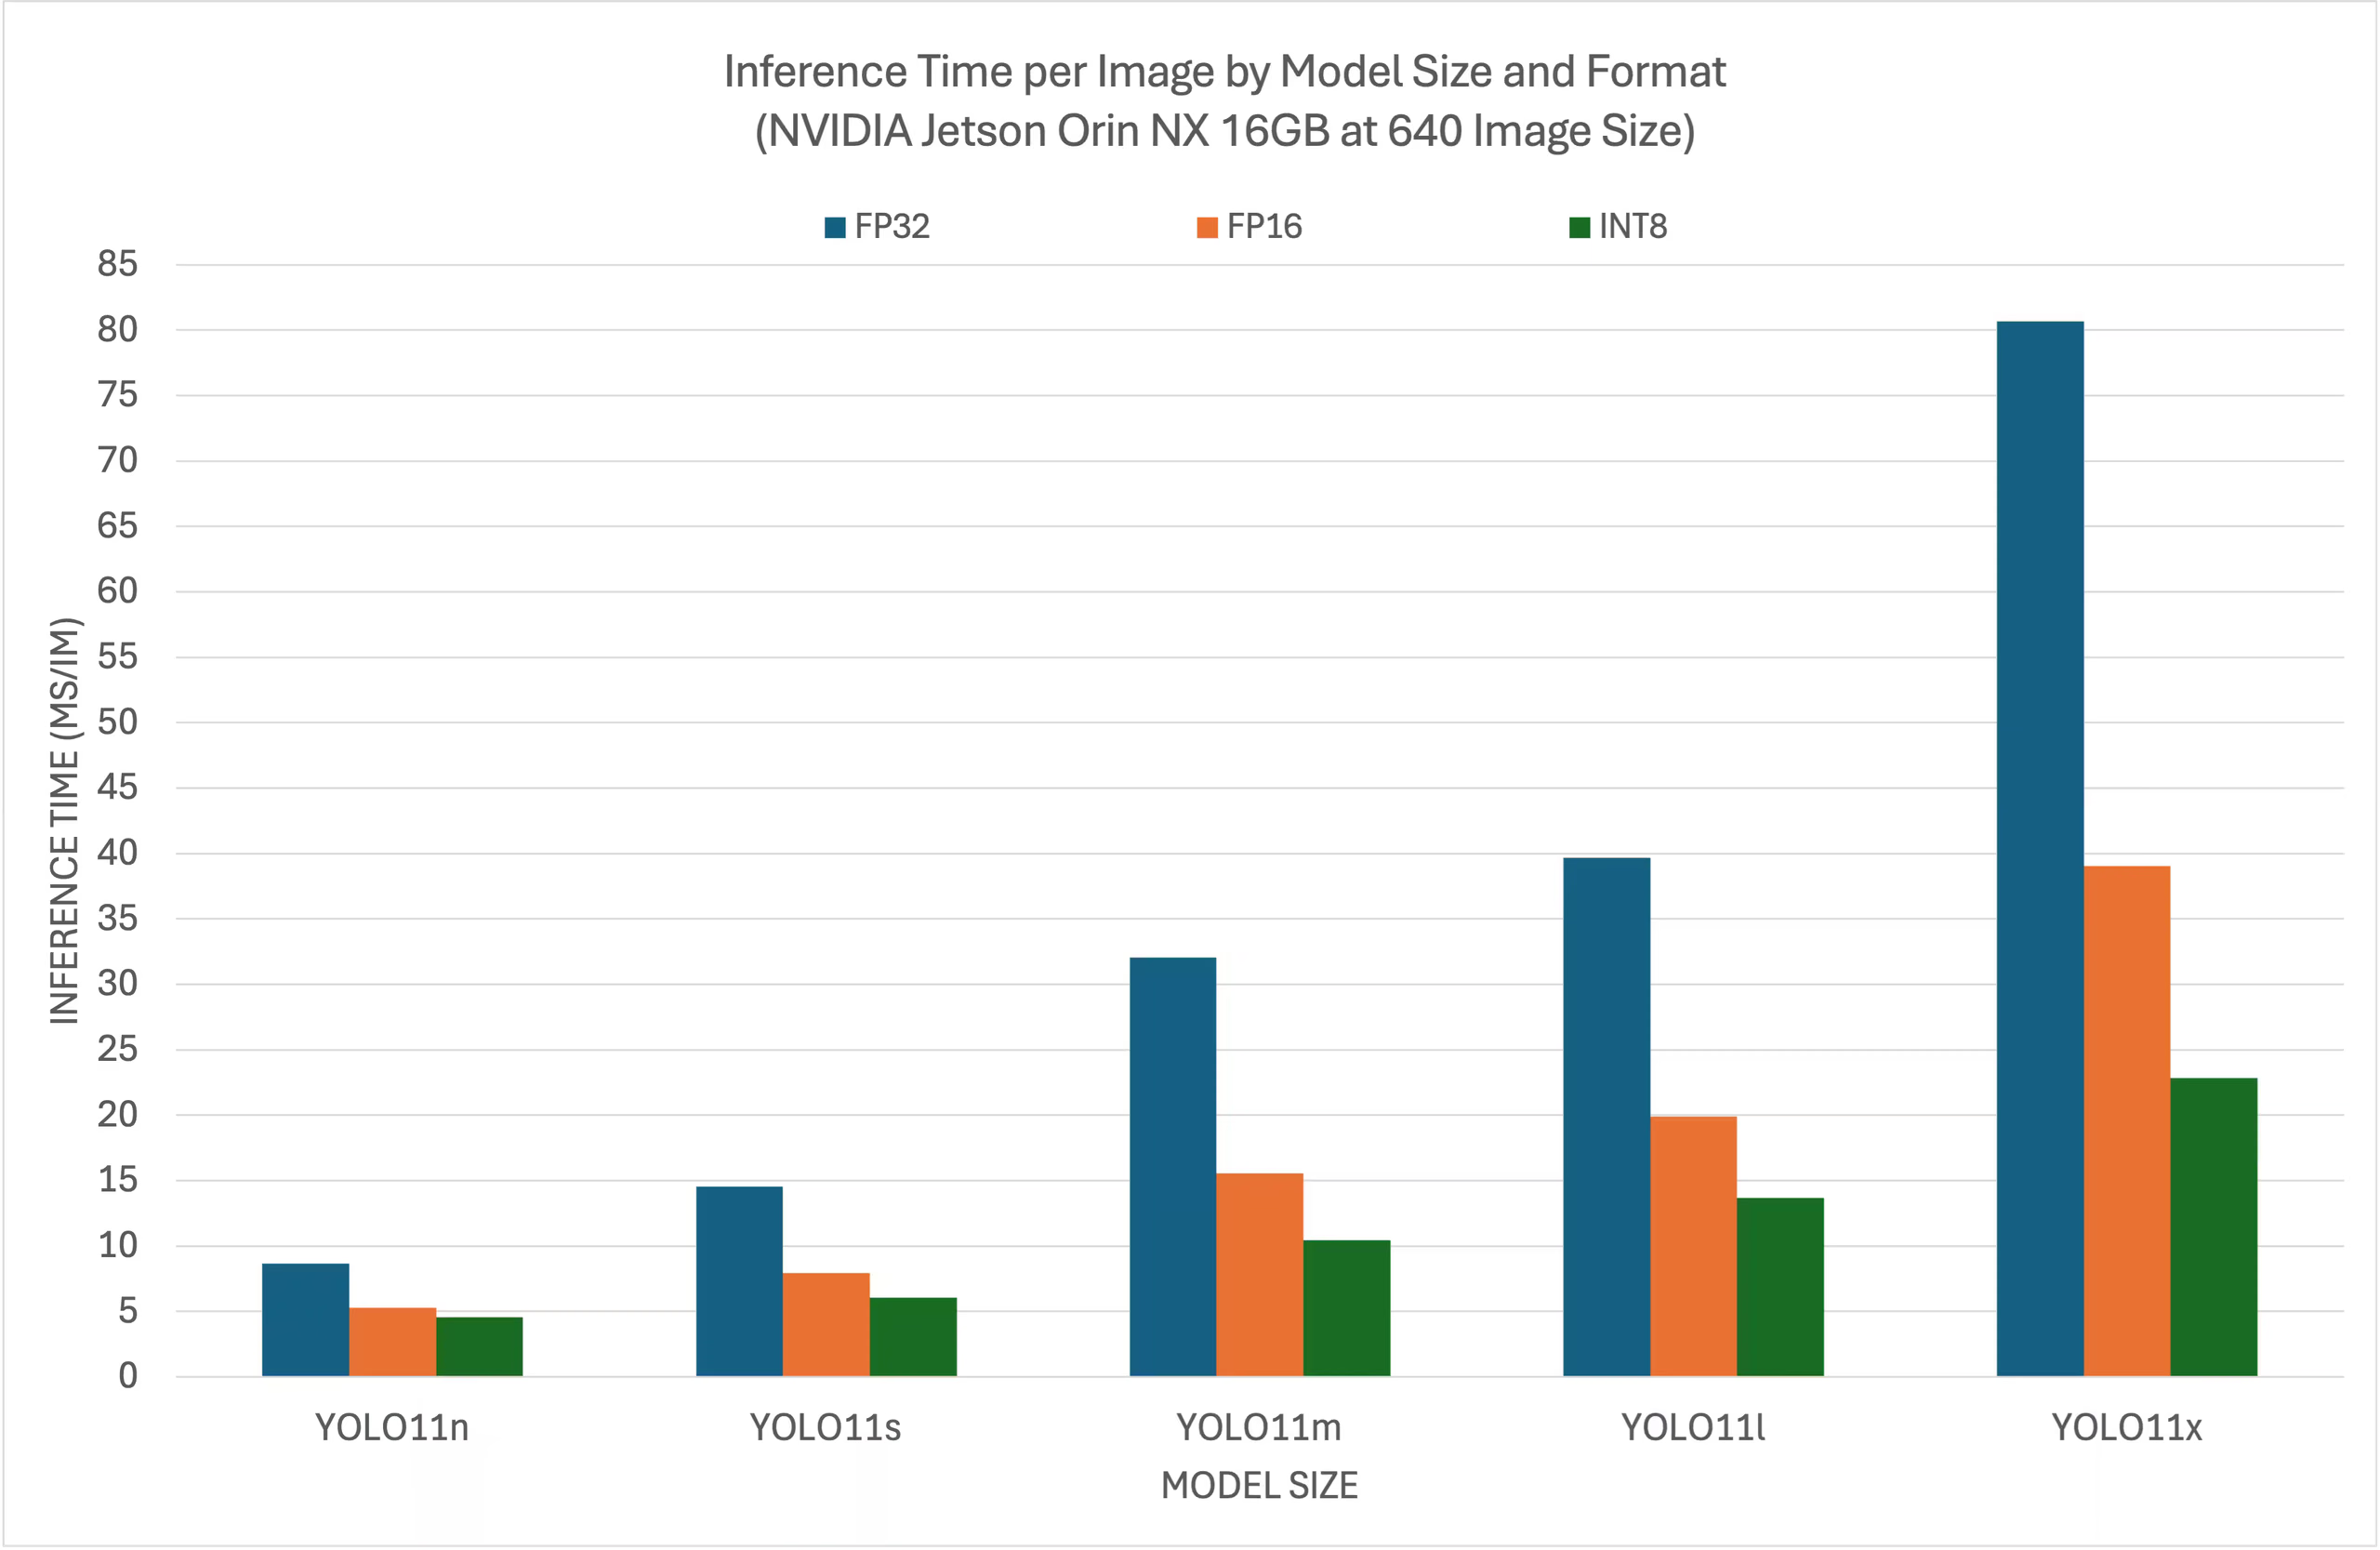
Detaillierte Vergleichstabelle#
| Format | Status | Inferenzzeit (ms/Bild) |
|---|---|---|
| TensorRT (FP32) | ✅ | 8.64 |
| TensorRT (FP16) | ✅ | 5.27 |
| TensorRT (INT8) | ✅ | 4.54 |
Danksagungen#
Diese Anleitung wurde ursprünglich von unseren Freunden Lakshantha und Elaine bei Seeed Studio erstellt.
Häufig gestellte Fragen#
Um Ultralytics YOLO26 auf einem NVIDIA Jetson-Gerät einzurichten, musst du zuerst das mit deiner JetPack-Version kompatible DeepStream SDK installieren. Folge der Schritt-für-Schritt-Anleitung in unserer Kurzanleitung, um dein NVIDIA Jetson für die Bereitstellung von YOLO26 zu konfigurieren.
Die Verwendung von TensorRT mit YOLO26 optimiert das Modell für die Inferenz, reduziert die Latenz erheblich und verbessert den Durchsatz auf NVIDIA-Jetson-Geräten. TensorRT ermöglicht eine leistungsstarke Inferenz mit geringer Latenz für Deep Learning durch Layer-Fusion, Präzisionskalibrierung und automatische Kernel-Abstimmung. Das sorgt für eine schnellere und effizientere Ausführung und ist besonders nützlich für Echtzeitanwendungen wie Videoanalyse und autonome Maschinen.
Ja, die Anleitung zur Bereitstellung von Ultralytics YOLO26 mit DeepStream SDK und TensorRT ist mit der gesamten NVIDIA-Jetson-Produktpalette kompatibel. Dazu gehören Geräte wie Jetson Orin NX 16GB mit JetPack 5.1.3 und Jetson Nano 4GB mit JetPack 4.6.4. Eine ausführliche Anleitung findest du im Abschnitt DeepStream-Konfiguration für YOLO26.
Exportiere das Modell mit dem NMS-freien Kopf mithilfe des Ultralytics-Exporters und schreibe die Datei
labels.txt, aus der DeepStream die Klassennamen liest:from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # erstellt 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))Füge
opset=12für TensorRT 8.2 oder älter (DeepStream 6.0.1 und früher) hinzu. Weitere Informationen zur Modellkonvertierung findest du in unserem Abschnitt Modellexport.Um INT8-Inferenz auszuführen, kalibriere das Modell mit einer repräsentativen Bildauswahl und stelle die DeepStream-Konfiguration auf den INT8-Modus um. Lade die COCO-val2017-Bilder herunter, wähle etwa 1000 Kalibrierungsbilder aus, lege die Umgebungsvariablen
INT8_CALIB_IMG_PATHundINT8_CALIB_BATCH_SIZEfest und aktualisiere anschließendconfig_infer_primary_yolo26.txtmitmodel-engine-file=model_b1_gpu0_int8.engine,int8-calib-file=calib.tableundnetwork-mode=1. Alle Schritte findest du im Abschnitt INT8-Kalibrierung. INT8 erfordert derzeit TensorRT 8.x.Um mehrere Streams in einer einzelnen DeepStream-Anwendung zu verarbeiten, bearbeite die Datei
deepstream_app_config.txt, um ein Raster für die gekachelte Anzeige hinzuzufügen und jede Quell-URI aufzulisten. Legerowsundcolumnsunter[tiled-display]fest, um das Raster zu erstellen, füge pro Stream eine eigene Gruppe[sourceN]mit eigenenuriundnum-sources=1hinzu und passe das Raster an die Anzahl der Streams an. Ein vollständiges Beispiel findest du im Abschnitt Einrichtung mehrerer Streams.Die Leistung von YOLO11-Modellen auf NVIDIA Jetson Orin NX 16GB variiert je nach TensorRT-Präzisionsstufe. YOLO11s-Modelle erreichen zum Beispiel:
- FP32-Präzision: 14.53 ms/im, 68.8 FPS
- FP16-Präzision: 7.91 ms/im, 126 FPS
- INT8-Präzision: 6.05 ms/im, 165 FPS
Diese Benchmarks unterstreichen die Effizienz und Leistungsfähigkeit von TensorRT-optimierten YOLO11-Modellen auf NVIDIA-Jetson-Hardware. Weitere Informationen findest du im Abschnitt Benchmark-Ergebnisse.