Caltech-101データセット#
Caltech-101データセットは、101種類の物体カテゴリと1つの背景クラスにまたがる9,144枚の画像を収録した、定番の画像分類ベンチマークです。各カテゴリには、動物、乗り物、家庭用品、人など、実世界の物体の画像が約40~800枚含まれており、コンパクトながら難易度の高い物体認識モデルのベンチマークとなっています。
Ultralytics Platform上のCaltech-101でサンプルをプレビューし、データセット統計を確認して、トレーニング用にクローンを作成できます。
Caltech-101には、事前定義されたトレーニング/検証分割がありません。以下のトレーニングコマンドでは、自動的にトレーニング用80% / 検証用20%に分割されるため、手動での準備は不要です。
主な機能#
- Caltech-101には、101種類の物体カテゴリと1つの
BACKGROUND_Googleクラス(クラスフォルダーは合計102個)にわたるカラー画像が9,144枚含まれています。 - カテゴリは、動物、乗り物、家庭用品、人など、実世界のさまざまな物体を網羅しています。
- 各カテゴリの画像数は約40~800枚であるため、クラス間でデータ数に偏りがあります。
- 画像サイズはさまざまで、多くはおよそ300x200ピクセル(中程度の解像度)です。
- Caltech-101は、画像分類や物体認識アルゴリズムのベンチマークに広く使用されています。
データセットの構成#
Caltech-101は102個のフォルダーで配布されます。101種類の物体カテゴリに加えてBACKGROUND_Googleクラスがあり、クラスごとに1つのフォルダーが用意されています。事前定義されたトレーニング/検証分割はありません。トレーニングを開始すると、Ultralyticsが画像を自動で分割するため、手動で設定しなくてもモデルを全102クラスでトレーニングできます。
- クラス数: 102(物体カテゴリ101 + 背景1)
- 画像の合計: 9,144枚
- トレーニング/検証の分割: 自動で80% / 20%(トレーニング約7,280枚、検証約1,864枚)
- クラスあたりの画像数: 約40~800枚(不均衡)
用途#
Caltech-101は、画像分類モデルや物体認識モデルのトレーニングと評価に広く使用されています。対象には、畳み込みニューラルネットワーク(CNNs)やサポートベクターマシン(SVMs)などがあります。幅広いカテゴリを網羅し、ラベル付き画像が整然としているため、機械学習やコンピュータービジョンの研究やプロトタイピングで人気のベンチマークとなっています。
使用方法#
Caltech-101でYOLOモデルをトレーニングするには、画像サイズを416に設定し、100エポック実行します。使用できる引数の全一覧については、トレーニングページと画像分類タスクガイドをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-cls.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="caltech101", epochs=100, imgsz=416)サンプル画像とアノテーション#
Caltech-101データセットには、さまざまな物体の高品質なカラー画像が含まれており、画像分類タスクに適した、よく整理されたデータセットです。データセット内の画像例を以下に示します。
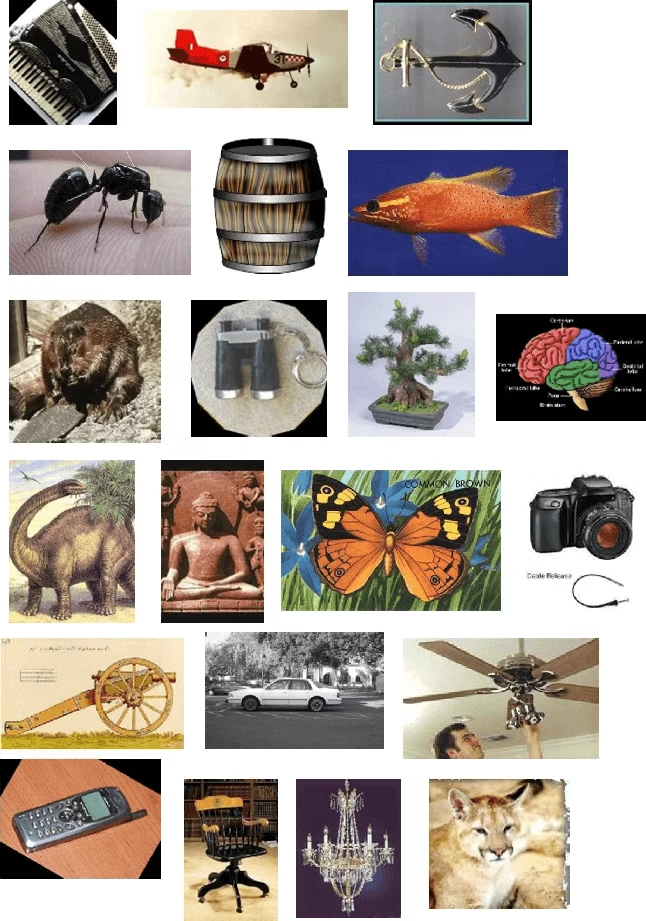
サンプルからは、Caltech-101のカテゴリの多様性と、画像が自然に中央配置される典型的な構図がわかります。そのため、堅牢な物体認識モデルのトレーニングを始めるのに適した、整然としたデータセットです。
引用と謝辞#
Caltech-101データセットを研究または開発に使用する場合は、以下の論文を引用してください。
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
貴重なリソースとしてCaltech-101データセットを作成・管理されたLi Fei-Fei氏、Rob Fergus氏、Pietro Perona氏に感謝いたします。Caltech-101データセットと作成者の詳細については、Caltech-101データセットのウェブサイトをご覧ください。
よくある質問#
Caltech-101データセットは、画像分類モデルや物体認識モデルのトレーニングとベンチマークに広く使用されています。101の物体カテゴリと背景クラスにわたる9,144枚の画像が含まれており、畳み込みニューラルネットワーク(CNNs)やサポートベクターマシン(SVMs)などのアルゴリズムを評価するための難易度の高いベンチマークとなっています。
Caltech-101でUltralytics YOLOモデルをトレーニングするには、以下のコードスニペットを使用します。データセットは初回使用時に自動でダウンロードされます。引数の全一覧については、モデルのトレーニングページをご覧ください。
トレーニング例from ultralytics import YOLO # モデルを読み込む model = YOLO("yolo26n-cls.pt") # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します) # モデルをトレーニングする results = model.train(data="caltech101", epochs=100, imgsz=416)Caltech-101には101の物体カテゴリと1つの
BACKGROUND_Googleクラスがあり、合計102個のクラスフォルダーと9,144枚の画像が含まれています。Ultralyticsでトレーニングすると、モデルは102クラスすべてを学習します。カテゴリごとの画像数は不均衡で、約40~800枚です。Caltech-101には、あらかじめ定義された分割はありません。初回のトレーニング時に、Ultralyticsがトレーニング用80%/検証用20%に自動分割します。画像数はトレーニング用が約7,280枚、検証用が約1,864枚なので、手動で分割を作成する必要はありません。分割を独自に管理するには、トレーニング前に画像を
train/フォルダーとval/フォルダーに整理してください。はい。Ultralytics Platformでは、データセットの管理、画像分類モデルのトレーニング、モデルのデプロイを、複雑なコーディングなしで行えます。Caltech-101の実験をクラウドで実行する便利な方法です。また、分類データセットの概要で、さらに多くの選択肢をご確認いただけます。