Caltech-256 데이터셋#
Caltech-256 데이터셋은 256개 객체 카테고리와 배경 클래스 하나에 걸친 30,607개 이미지로 구성된 고전적인 이미지 분류 벤치마크입니다. 각 카테고리에는 동물, 차량, 가정용품, 사람 등 실제 객체 이미지가 최소 80개씩 포함되어 있어 객체 인식 모델을 위한 더 크고 어려운 Caltech-101의 후속 데이터셋입니다.
Ultralytics Platform의 Caltech-256을 살펴보고 샘플 미리보기, 데이터셋 통계 확인, 학습용 복제를 수행하세요.
Caltech-256에는 미리 정의된 학습/검증 분할이 없습니다. 아래 학습 명령은 데이터를 학습용 80% / 검증용 20%로 자동 분할하므로 수동으로 준비할 필요가 없습니다.
주요 기능#
- Caltech-256에는 256개 객체 카테고리와
257.clutter배경 클래스 하나에 걸쳐 30,607개의 컬러 이미지가 있으며, 클래스 폴더는 총 257개입니다. - 범주에는 동물, 차량, 가정용품, 사람 등 매우 다양한 실제 객체가 포함됩니다.
- 각 카테고리에는 이미지가 최소 80개씩 있으며, 가장 많은 카테고리에는 약 800개까지 있어 클래스별 이미지 수가 불균형합니다.
- 이미지의 크기와 해상도는 다양합니다.
- Caltech-256은 이미지 분류 및 객체 인식 알고리즘의 벤치마킹에 널리 사용됩니다.
데이터셋 구조#
Caltech-256은 256개 객체 카테고리와 257.clutter 배경 클래스를 포함하는 257개 폴더로 배포되며, 미리 정의된 학습/검증 분할은 없습니다. 학습을 시작하면 Ultralytics가 이미지를 자동으로 분할하므로 수동 설정 없이 모델을 257개 클래스 전체에 대해 학습할 수 있습니다.
- 클래스: 257개(객체 카테고리 256개 + 배경 1개)
- 총 이미지 수: 30,607개
- 학습/검증 분할: 자동 80% / 20%(학습 약 24,385개, 검증 약 6,222개)
- 클래스당 이미지 수: 최소 80개(불균형, 최대 약 800개)
응용 분야#
Caltech-256 데이터셋은 이미지 분류 및 객체 인식 모델을 학습하고 평가하는 데 널리 사용되며, 합성곱 신경망 (CNNs)과 서포트 벡터 머신 (SVMs) 등이 포함됩니다. 다양한 카테고리와 고품질 이미지 덕분에 머신러닝 및 컴퓨터 비전 연구와 프로토타이핑에 널리 쓰이는 벤치마크입니다.
사용법#
이미지 크기 416으로 Caltech-256에서 YOLO 모델을 100 에포크 동안 학습합니다. 사용 가능한 전체 인수 목록은 학습 페이지와 이미지 분류 작업 가이드를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-cls.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델 학습
results = model.train(data="caltech256", epochs=100, imgsz=416)
샘플 이미지 및 어노테이션#
Caltech-256 데이터셋에는 다양한 객체의 고품질 컬러 이미지가 포함되어 있어 이미지 분류 작업에 적합한 체계적인 데이터셋을 제공합니다. 다음은 데이터셋 이미지의 예시입니다(출처).
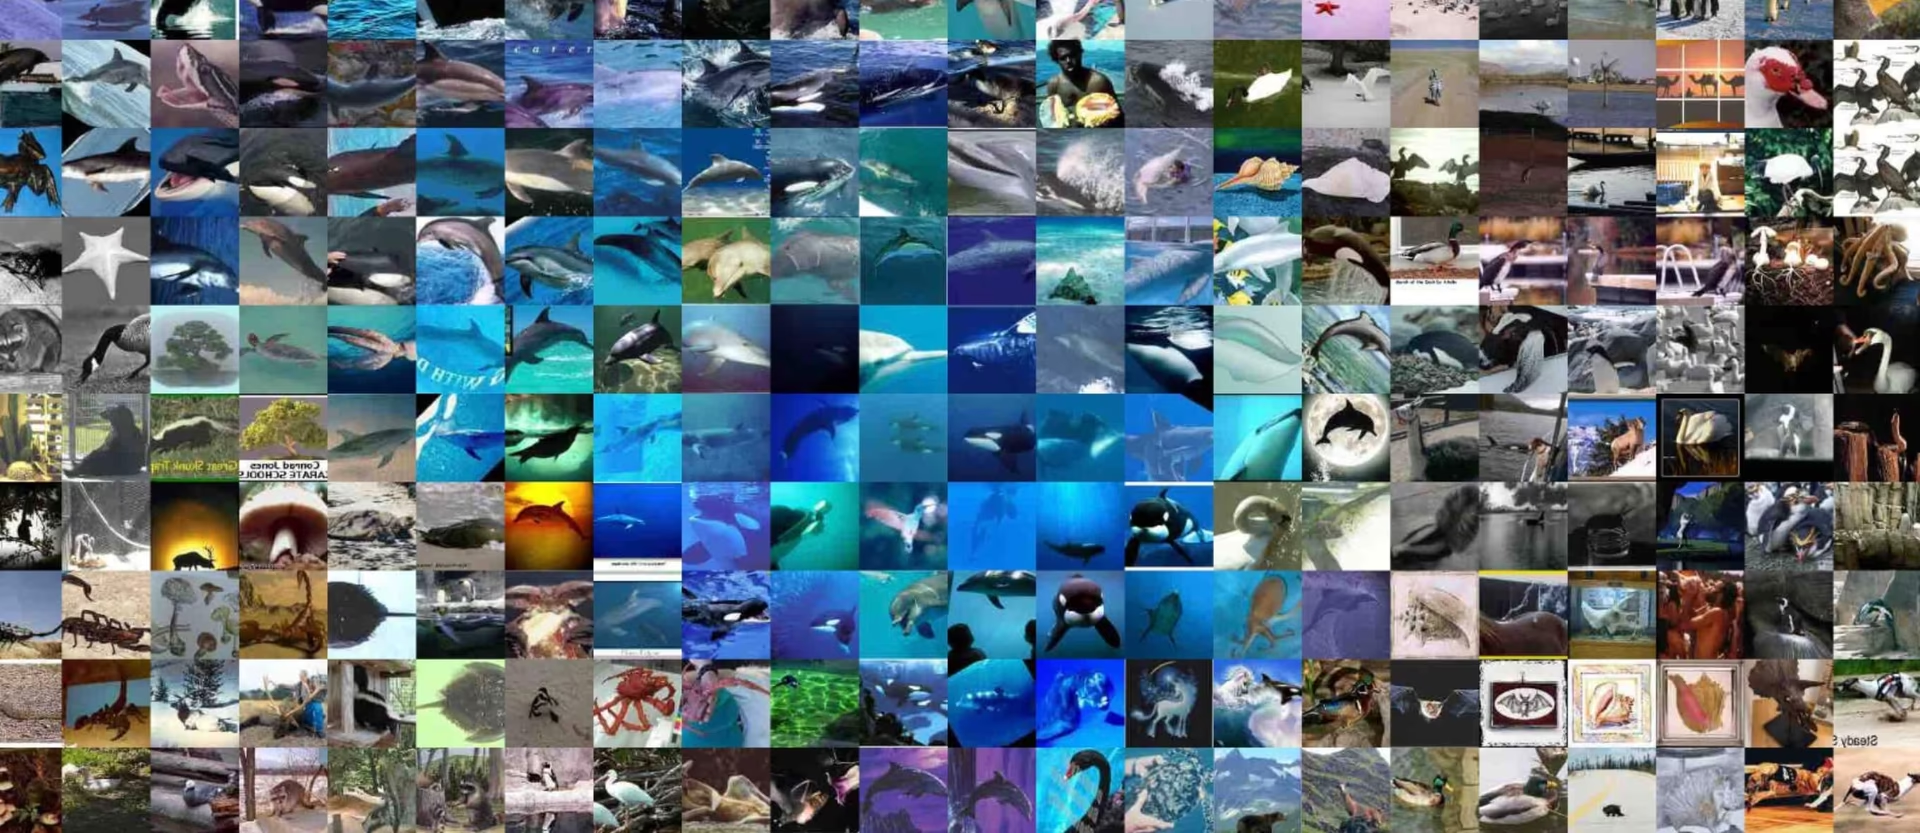
샘플은 Caltech-256 데이터셋 객체의 다양성과 복잡성을 보여주며, 견고한 객체 인식 모델을 학습할 때 다양한 데이터셋이 중요한 이유를 잘 드러냅니다.
인용 및 감사의 글#
연구 또는 개발 작업에 Caltech-256 데이터셋을 사용하는 경우 다음 논문을 인용해 주세요.
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Caltech-256 데이터셋을 머신러닝 및 컴퓨터 비전 연구 커뮤니티의 귀중한 리소스로 만들고 유지 관리해 주신 Gregory Griffin, Alex Holub, Pietro Perona에게 감사드립니다. Caltech-256 데이터셋과 제작자에 대한 자세한 내용은 Caltech-256 데이터셋 웹사이트를 방문하시기 바랍니다.
자주 묻는 질문#
Caltech-256 데이터셋은 이미지 분류 및 객체 인식 모델을 학습하고 벤치마킹하는 데 널리 사용됩니다. 256개 객체 카테고리와 배경 클래스 하나에 걸쳐 30,607개의 이미지가 있어, 합성곱 신경망 (CNNs)과 서포트 벡터 머신(SVMs) 같은 알고리즘에 대해 Caltech-101보다 규모가 크고 더 까다로운 벤치마크를 제공합니다.
Caltech-256에서 Ultralytics YOLO 모델을 학습하려면 아래 코드 스니펫을 사용하세요. 처음 사용할 때 데이터셋이 자동으로 다운로드됩니다. 전체 인수 목록은 모델 학습 페이지를 참조하세요.
학습 예제from ultralytics import YOLO # 모델 로드 model = YOLO("yolo26n-cls.pt") # 사전 학습된 모델을 불러옵니다(학습에 권장). # 모델 학습 results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256에는 256개의 객체 카테고리와
257.clutter배경 클래스 하나가 있어 총 257개의 클래스 폴더와 30,607개의 이미지가 있습니다. Ultralytics로 학습하면 모델은 257개 클래스를 모두 학습합니다. 각 카테고리에는 이미지가 최소 80개씩 있지만, 클래스별 이미지 수는 불균형하며 가장 많은 카테고리에는 약 800개까지 있습니다.Caltech-256에는 미리 정의된 분할이 없습니다. 처음 학습할 때 Ultralytics가 데이터를 학습용 80% / 검증용 20%로 자동 분할하므로, 학습 이미지 약 24,385개와 검증 이미지 6,222개가 생성되며 직접 분할을 만들 필요가 없습니다. 분할을 직접 제어하려면 학습 전에 이미지를
train/및val/폴더로 정리하세요.예. Ultralytics Platform을 사용하면 데이터셋을 관리하고, 이미지 분류 모델을 학습하며, 많은 코드를 작성하지 않고도 모델을 배포할 수 있습니다. 클라우드에서 Caltech-256 실험을 실행하기에 편리하며, 분류 데이터셋 개요에서 더 많은 옵션을 살펴볼 수 있습니다.