CIFAR-10 데이터셋#
CIFAR-10 (캐나다 고등연구원) 데이터셋은 10개 클래스(비행기, 자동차, 새, 고양이, 사슴, 개, 개구리, 말, 배, 트럭)로 균등하게 나뉜 32x32 컬러 이미지 60,000개로 구성된 대표적인 이미지 분류 벤치마크입니다. 클래스당 6,000개씩 총 50,000개의 학습 이미지와 10,000개의 테스트 이미지로 미리 정의된 분할이 제공되므로, 분류 모델을 학습하고 벤치마킹하기 위한 가볍고 균형 잡힌 시작점으로 적합합니다. 더 세분화된 과제를 원한다면 관련 CIFAR-100 데이터셋을 참조하십시오.
샘플을 미리 보고, 데이터셋 통계를 확인하고, 학습을 위해 복제하려면 Ultralytics Platform의 CIFAR-10을 살펴보십시오.
주요 기능#
- CIFAR-10에는 32x32 픽셀의 컬러 이미지 60,000개가 포함되어 있으며, 10개 클래스에 균등하게 나뉘어 있습니다.
- 각 클래스에는 정확히 6,000개의 이미지가 포함되어 있습니다. 학습용 5,000개와 테스트용 1,000개로 구성되므로 데이터셋은 완벽하게 균형을 이룹니다.
- 10개 클래스는 비행기, 자동차, 새, 고양이, 사슴, 개, 개구리, 말, 배, 트럭입니다.
- 데이터셋에는 사전 정의된 학습/테스트 분할이 포함되어 있으므로 수동 또는 자동 분할이 필요하지 않습니다.
- CIFAR-10은 이미지 분류 및 객체 인식 연구를 위한 표준 벤치마크입니다.
데이터셋 구조#
CIFAR-10에는 공식적으로 미리 정의된 분할이 포함되어 있으므로 자동 또는 수동 파티셔닝이 필요하지 않습니다:
- 클래스: 10개(비행기, 자동차, 새, 고양이, 사슴, 개, 개구리, 말, 배, 트럭)
- 전체 이미지: 60,000개 (32x32 컬러)
- 학습 세트: 이미지 50,000개(클래스당 5,000개)
- 테스트 세트: 이미지 10,000개(클래스당 1,000개)
CIFAR-10에는 별도의 검증 폴더가 없으므로 Ultralytics는 기본적으로 학습 중 10,000개 이미지로 구성된 테스트 세트를 검증 분할로 사용합니다.
응용 분야#
CIFAR-10은 고전적인 합성곱 신경망 (CNNs)과 서포트 벡터 머신 (SVMs)부터 최신 딥 아키텍처에 이르기까지 이미지 분류 모델을 학습하고 평가하는 데 널리 사용됩니다. 작은 이미지 크기와 균형 잡힌 클래스 구성 덕분에 신속한 실험, 새로운 알고리즘의 벤치마킹, 컴퓨터 비전 기초 교육에 적합합니다.
사용법#
이미지 크기 32에서 100 에포크 동안 CIFAR-10으로 YOLO 모델을 학습합니다. 사용 가능한 인자의 전체 목록은 학습 페이지와 이미지 분류 작업 가이드를 참조하십시오.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar10", epochs=100, imgsz=32)
샘플 이미지 및 주석#
CIFAR-10 데이터셋에는 다양한 객체의 컬러 이미지가 포함되어 있어 이미지 분류 작업을 위한 체계적인 데이터셋을 제공합니다. 다음은 데이터셋 이미지의 몇 가지 예시입니다:
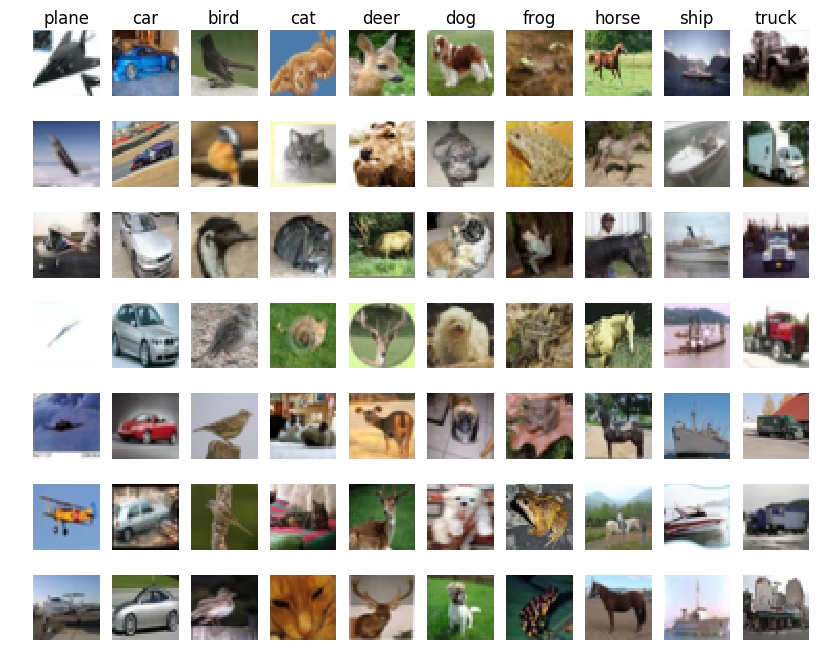
샘플은 CIFAR-10 데이터셋에 포함된 객체의 다양성을 보여 주며, 강건한 이미지 분류 모델을 학습하기 위해 다양한 데이터셋이 중요하다는 점을 강조합니다.
인용 및 감사의 글#
연구 또는 개발 작업에서 CIFAR-10 데이터셋을 사용하는 경우 다음 논문을 인용하십시오:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
머신러닝 및 컴퓨터 비전 연구 커뮤니티에 귀중한 리소스인 CIFAR-10 데이터셋을 만들고 유지 관리한 Alex Krizhevsky에게 감사의 뜻을 표합니다. CIFAR-10 데이터셋과 제작자에 대한 자세한 내용은 CIFAR-10 데이터셋 웹사이트를 방문하십시오.
FAQ#
CIFAR-10에서 Ultralytics YOLO 모델을 학습하려면 아래 코드 스니펫을 사용하십시오. 데이터셋은 처음 사용할 때 자동으로 다운로드됩니다. 인자의 전체 목록은 모델 학습 페이지를 참조하십시오.
학습 예제from ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar10", epochs=100, imgsz=32)CIFAR-10에는 비행기, 자동차, 새, 고양이, 사슴, 개, 개구리, 말, 배, 트럭의 10개 클래스가 있으며, 각 클래스에 정확히 6,000개의 이미지가 있어 전체 이미지 수는 60,000개입니다. 클래스는 서로 배타적이고 완벽하게 균형을 이루며, 범주 간 중복이 없습니다.
CIFAR-10에는 학습 이미지 50,000개와 테스트 이미지 10,000개로 미리 정의된 분할이 제공되며, 클래스당 학습 이미지 5,000개와 테스트 이미지 1,000개가 정확히 포함됩니다. Ultralytics가 자동으로 분할하는 폴더 기반 분류 데이터셋과 달리 CIFAR-10의 공식 파티션은 그대로 사용되며, 기본적으로 학습 중 테스트 세트가 검증 분할로 사용됩니다.
예. Ultralytics Platform을 사용하면 데이터셋을 관리하고, 이미지 분류 모델을 학습하며, 광범위한 코딩 없이 모델을 배포할 수 있습니다. 클라우드에서 CIFAR-10 실험을 실행할 수 있는 편리한 방법이며, 분류 데이터셋 개요에서 더 많은 옵션을 확인할 수 있습니다.