如何测试计算机视觉模型#
简介#
模型测试用于检查训练好的模型在此前未见过的真实数据上的表现,例如移动、光线昏暗或部分遮挡的物体,而不是经过筛选的基准数据。模型评估会衡量模型在带标签数据集上的指标,而测试则会在部署前验证模型学到的行为是否符合应用目标。本指南介绍如何准备测试数据、测试 Ultralytics YOLO26 模型,以及发现过拟合、欠拟合和数据泄漏问题。
观看: 如何测试机器学习模型 | 避免计算机视觉中的数据泄漏 🚀
模型测试与模型评估#
模型测试和模型评估是计算机视觉项目中的两个不同步骤。评估使用带标签的数据集和各项指标衡量模型性能;测试则检查模型学到的行为在接近部署环境的条件下是否依然可靠。
假设你训练了一个能够识别猫和狗的计算机视觉模型,并希望将其部署在宠物店监控动物。在模型评估阶段,你会使用带标签的数据集计算准确率、精确率和召回率等指标。例如,模型可能在给定数据集中区分猫和狗的准确率达到 98%。
评估完成后,你可以用来自宠物店的图像测试模型,看看它在更多样、更真实的条件下识别猫和狗的效果。你可以检查模型能否在猫狗移动、光线不同,或被玩具、家具等物体部分遮挡时正确标注它们。模型测试可以验证模型在受控评估环境之外是否仍能按预期运行。
准备模型测试#
计算机视觉数据集通常会划分为训练集和测试集,以模拟真实场景:训练数据用于教会模型,而测试数据则用于验证模型在从未见过的样本上的表现。Ultralytics Platform将数据集整理和标注集中在一处,便于你构建带标签的测试集。
- 真实场景代表性:此前未见过的测试数据应与模型部署时会处理的数据相似,这样才能真实反映模型的能力。
- 数据量充足:测试数据集需要足够大,才能可靠地了解模型的表现。
如何测试 YOLO26 模型#
测试训练好的 YOLO26 模型包含两种互补的工作流程:在带标签的测试集上运行验证以获取定量指标,以及在新图像上运行预测以定性检查模型行为。
在带标签的测试集上运行验证#
验证模式会将模型预测结果与真实标签进行比较,并报告检测模型的精确率、召回率、mAP50 和 mAP50-95。它还会保存混淆矩阵和精确率-召回率曲线等可视化辅助信息,帮助你发现模型表现不佳的具体方面。
from ultralytics import YOLO

# 加载预训练模型或你自己训练的检查点,例如 "path/to/best.pt"
model = YOLO("yolo26n.pt")

# 运行验证;如果数据集 YAML 定义了测试集划分,请添加 split="test"
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
默认情况下,验证会在数据集的 val 划分上运行。要衡量模型在留出的测试集上的表现,请在数据集 YAML 中定义 test: 划分,并传入 split="test"。
对新图像运行预测#
预测模式会在新的、未见过的数据上运行模型,无需提供标签。预测模式不会生成性能指标,但你可以保存带标注的输出,以便检查模型在真实图像上的表现,例如一次处理整个测试图像文件夹。
from ultralytics import YOLO

# 加载预训练模型或你自己训练的检查点,例如 "path/to/best.pt"
model = YOLO("yolo26n.pt")

# 对测试图像文件夹运行预测并保存带标注的结果
results = model.predict(source="path/to/test_images", save=True)如果你想在投入自定义训练之前确认 YOLO26 是否适用于你的应用,可以使用预训练检查点在自己的图像上运行预测模式。这些模型是在 COCO 等数据集上预训练的,因此预测结果能让你快速了解模型在特定场景下可能的表现。
验证模式与预测模式对比#
如何分析测试结果#
获得预测结果和指标后,深入分析模型在哪些方面出错以及出错原因:
- 错误分类的图像:找出并检查模型分类错误的图像,了解模型出错的原因。
- 错误分析:全面分析错误,了解错误类型(例如误报与漏报)及其潜在原因。
- 偏差与公平性:检查模型的预测是否存在偏差。确保模型在不同的数据子集上表现一致,尤其是数据包含种族、性别或年龄等敏感属性时。
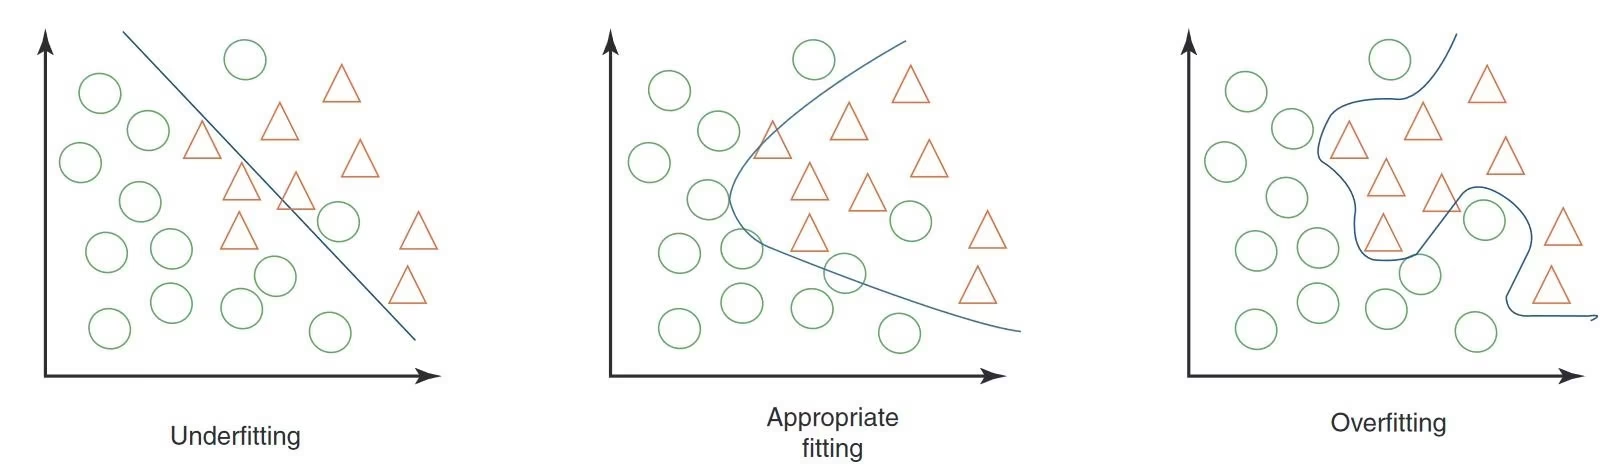
机器学习中的过拟合与欠拟合#
测试机器学习模型时,尤其是在计算机视觉领域,务必留意过拟合和欠拟合。这些问题会严重影响模型处理新数据的能力。
| 问题 | 常见迹象 | 解决方法 |
|---|---|---|
| 过拟合 | 训练准确率高但验证准确率低;对图像中的细微变化或无关细节过于敏感 | 应用 dropout 等正则化方法,扩大训练数据集,简化模型架构 |
| 欠拟合 | 即使在训练集上准确率也很低;始终无法识别明显的特征或物体 | 使用更复杂的模型,提供更多相关特征,增加训练轮次 |
关键在于找到平衡,让模型在训练集和验证集上都表现良好。定期监控指标并在测试期间直观检查预测结果,有助于你及时发现模型是否趋向任一极端。
计算机视觉中的数据泄漏及其规避方法#
数据泄漏是指训练数据集之外的信息意外地被用于训练模型。发生数据泄漏时,模型在训练期间可能看起来非常准确,但在新的、未见过的数据上表现不佳。
数据泄漏不易察觉,往往源于训练数据中的隐藏偏差:
| 偏差类型 | 表现形式 |
|---|---|
| 相机偏差 | 不同的角度、光线、阴影和相机运动会引入不需要的模式 |
| 叠加层偏差 | 图像中的徽标、时间戳或其他叠加内容会误导模型 |
| 字体和物体偏差 | 某些类别中频繁出现的特定字体或物体会使模型学习产生偏差 |
| 空间偏差 | 前景与背景、边界框分布和物体位置的不平衡会影响训练 |
| 标签和领域偏差 | 标签错误或数据类型偏移会导致数据泄漏 |
如何检测和避免数据泄漏#
要发现数据泄漏,请检查模型的结果是否好得出奇,看看某个特征是否比其他特征重要得多,再确认模型的决策是否符合直觉,并验证数据是否在任何处理开始前正确划分。
要避免数据泄漏,请使用包含来自不同摄像头和环境的图像或视频的多样化数据集,并仔细检查数据中是否存在隐藏偏差,例如所有正样本是否都采集于一天中的特定时段。避免数据泄漏能让你的计算机视觉模型在真实场景中更加可靠。
模型测试之后该做什么#
测试模型后,接下来的步骤取决于测试结果。如果模型表现良好,你可以将其部署到真实环境中。如果结果不尽如人意,你就需要进行改进。这可能包括分析错误、收集更多数据、提高数据质量、调整超参数以及重新训练模型。
结论#
严格的模型测试——在留出的测试集上验证、对真实图像进行预测,以及检查过拟合和数据泄漏——能将经过充分评估的模型变成可靠的模型。在部署前解决测试中发现的问题,模型就更有可能在生产环境中按预期运行。如果过程中有任何疑问,可以在 Ultralytics GitHub 仓库或 Ultralytics Discord 服务器向社区提问。
常见问题#
模型评估使用带标签的数据集和指标来衡量性能,而模型测试则检查模型在类似部署条件的全新、未见数据上的表现。评估会基于受控数据集得出精确率和 mAP 等数值;测试则能揭示模型学到的行为在光照变化、运动或遮挡情况下是否依然可靠。请参阅模型测试与模型评估,了解一个完整示例。
使用预测模式,并将文件夹路径作为
source传入——YOLO26 会处理文件夹中的每张图像,并可保存带标注的结果供你查看。预测模式不会计算指标;要量化模型在带标签数据集上的性能,请改用验证模式。如何测试 YOLO26 模型介绍了这两种工作流程。对于检测模型,验证会报告精确率、召回率、mAP50 和 mAP50-95,并保存混淆矩阵和精确率-召回率曲线等图表。要在专用测试集划分上进行验证,而不是使用默认的
val划分,请在数据集 YAML 中定义test:,并传入split="test"。请参阅性能指标指南,了解如何解读各项指标。对于过拟合,可以应用 dropout 等正则化技术、扩大训练数据集,或简化模型架构。对于欠拟合,可以使用更复杂的模型、提供更多相关特征,或增加训练轮数。机器学习中的过拟合与欠拟合总结了这两种问题的迹象和相应的解决方法。
如果测试性能好得出奇、单个特征主导预测,或模型的决策不符合直觉,就要警惕数据泄漏。使用来自不同摄像头和环境的多样化数据集、检查数据中是否存在隐藏偏差,并确认训练集/测试集在任何处理开始前就已划分,可以避免数据泄漏。请参阅计算机视觉中的数据泄漏,了解常见的偏差类型。