Labelbox-Integration#
Ultralytics Platform liest NDJSON-Exporte aus Labelbox direkt ein. Du musst keinen Schlüssel einfügen, keine Verbindung aufrechterhalten und kein Konvertierungsskript pflegen – exportiere die Daten aus Labelbox, lade die Datei hoch und deine Labels werden als normaler Platform-Datensatz übernommen.
Aus Labelbox importieren#
- Aus Labelbox exportieren. Öffne bei einem Labeling-Projekt den Tab Data Rows, wähle All aus, klicke auf Export data, wähle die einzuschließenden Felder aus und bestätige. Wähle in Catalog die Datenzeilen aus und dann Manage selection > Export data. Aktiviere anschließend Export labels from project und wähle das Projekt aus. Andernfalls enthält die Datei keinerlei Annotationen.
- Datei herunterladen. Labelbox führt den Export als Hintergrundauftrag aus. Behalte ihn in den Benachrichtigungen im Blick und klicke nach Abschluss auf Download, um die Datei
.ndjsonzu speichern. - Auf Platform hochladen. Erstelle einen neuen Datensatz und lade die Datei
.ndjsonhoch oder füge einen direkten Link dazu ein. Du kannst den Vorgang auch unter Einstellungen > Integrationen > Labelbox starten. - Trainieren. Sobald die Verarbeitung abgeschlossen ist, kannst du die Annotationen bearbeiten und trainieren – genau wie bei jedem anderen Platform-Datensatz.
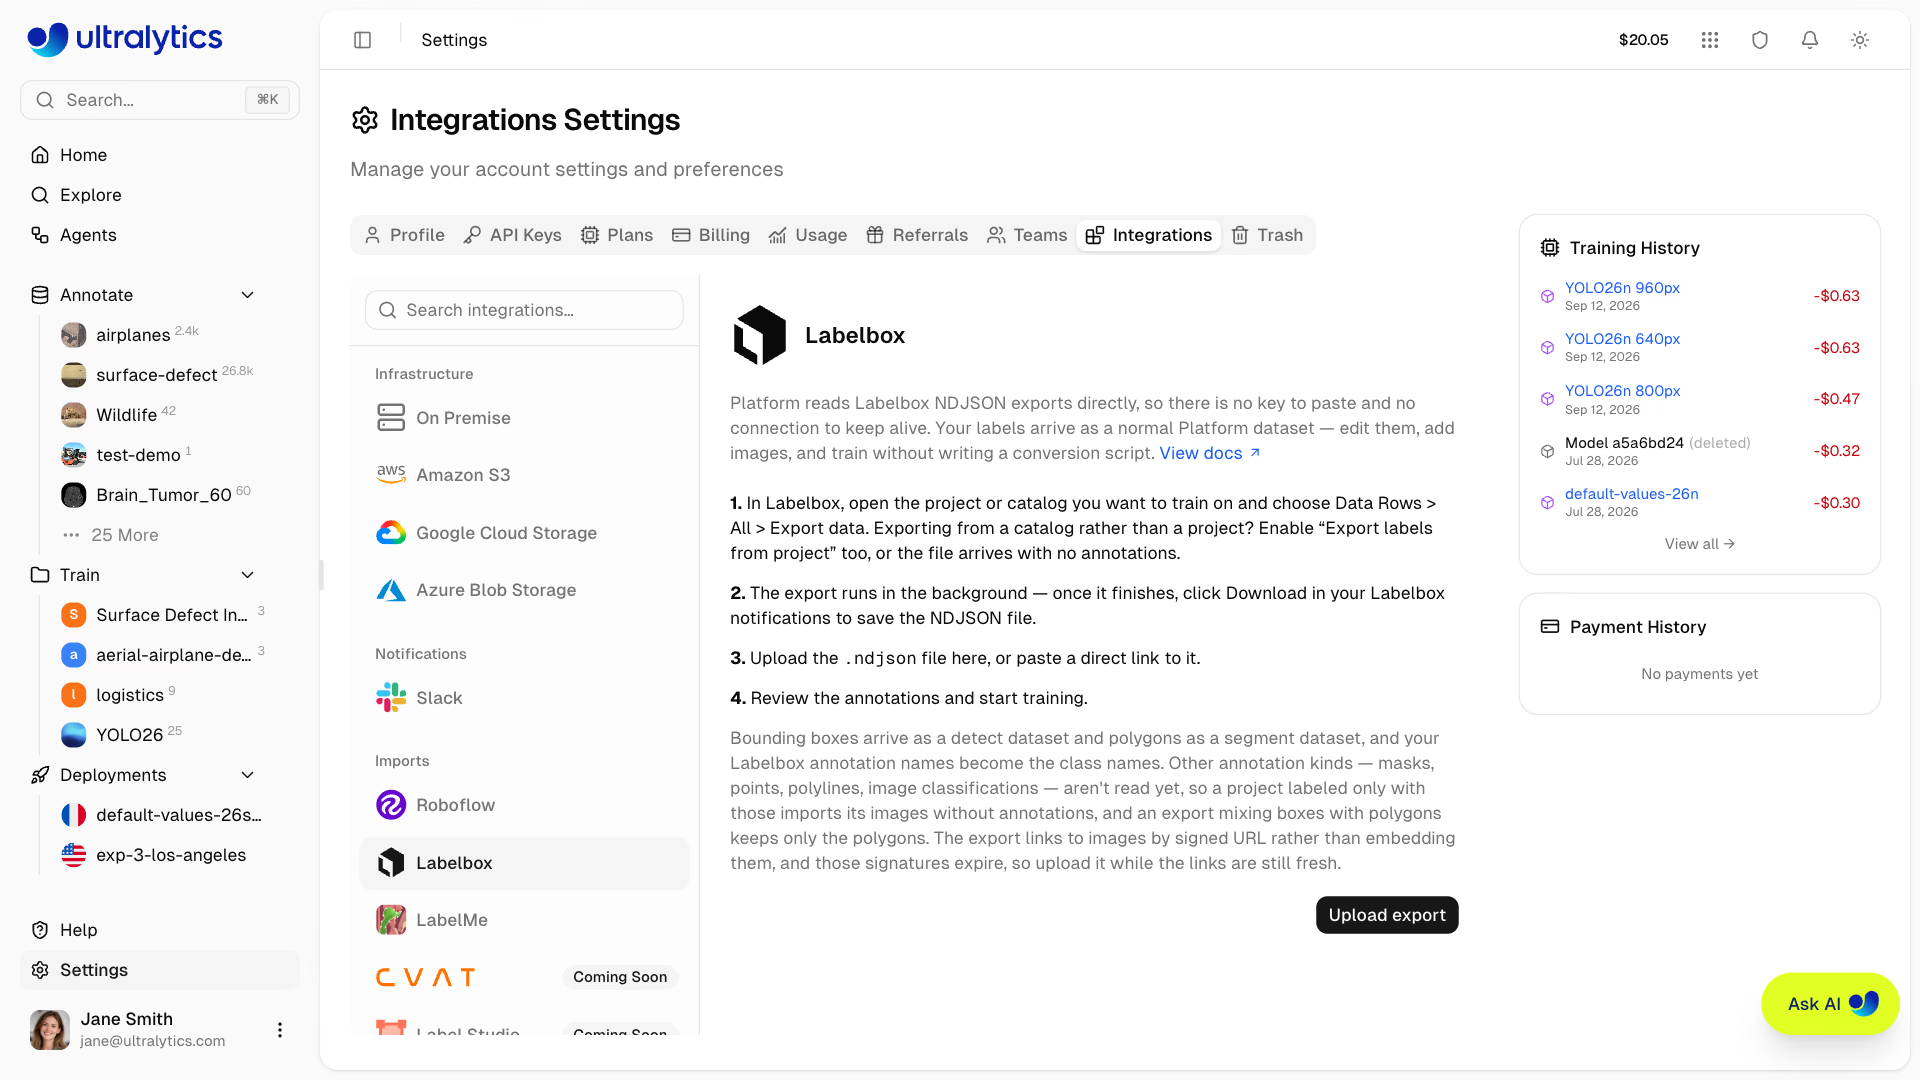
Anders als bei CVAT und Label Studio gibt es kein Format zur Auswahl – unterstützt wird der native Export von Labelbox.
Mit dem SDK exportieren#
Labelbox bietet die Exportaufgabe auch in seinem Python SDK an. Das ist der einfachere Weg für eine wiederholbare Pipeline. Verarbeite die Aufgabe als Stream und schreibe ein JSON-Objekt pro Zeile:
import json

import labelbox

client = labelbox.Client(api_key="YOUR_LABELBOX_API_KEY")
export_task = labelbox.ExportTask.get_task(client, "YOUR_EXPORT_TASK_ID")
export_task.wait_till_done()  # # Das Streamen einer Aufgabe, die nicht COMPLETE ist, löst einen Fehler aus

with open("dataset.ndjson", "w") as f:
    f.writelines(json.dumps(data_row.json) + "\n" for data_row in export_task.get_buffered_stream())
NDJSON besteht aus einem JSON-Objekt pro Zeile. json.dump(list_of_rows, f) schreibt stattdessen ein einzelnes Array, und Platform überspringt jede Zeile, die kein JSON-Objekt ist – der Import findet dann überhaupt keine Datenzeilen. Verwende die obige Schleife oder "\n".join(json.dumps(r) for r in rows).
Was importiert wird#
Platform erkennt das Labelbox-Format automatisch und ordnet Begrenzungsrahmen und Polygone dem passenden YOLO-Aufgabentyp zu:
| Labelbox-Annotation | Importiert |
|---|---|
| Begrenzungsrahmen | Erkennung |
| Polygon | Segmentierung |
| Segmentierungsmaske, Punkt, Polylinie, Beziehung, Klassifizierung | Noch nicht |
Der Wert name jedes Objekts wird zum Klassennamen. Eine Annotation vom Typ "name": "Dog" wird also als Klasse Dog und nicht mit ihrem kleingeschriebenen Namen value importiert. Pixelkoordinaten werden anhand der Abmessungen media_attributes im Export normalisiert. Behalte daher die Medienattribute im Export bei: Bei Zeilen ohne Breite und Höhe wird das Bild ohne Annotationen importiert. Nur Objekte, die Platform importieren kann, werden als Klassen registriert. Werkzeuge für Masken, Punkte und Polylinien fügen dem Datensatz also keine leeren Klassen hinzu. Jedes Bild erhält den Namen seines data_row.external_id, danach den Namen seines global_key. Fehlen beide Angaben im Export, wird der Dateiname aus der signierten URL verwendet. Datenzeilen mit Bildern werden importiert; Video-, Text- und sonstige Datenzeilen ohne Bilder werden übersprungen. Ein Katalogexport ohne Annotationen wird als unbeschrifteter Bilddatensatz importiert, der im Annotationseditor von Platform beschriftet werden kann.
Eine einzelne Datenzeile sieht gekürzt auf die von Platform gelesenen Felder so aus:
{
    "data_row": {
        "external_id": "000000000307.jpg",
        "global_key": "000000000307.jpg",
        "row_data": "https://storage.labelbox.com/...?Expires=...&Signature=..."
    },
    "media_attributes": { "height": 480, "width": 640, "mime_type": "image/jpeg" },
    "projects": {
        "<project-id>": {
            "labels": [
                {
                    "annotations": {
                        "objects": [
                            {
                                "name": "Dog",
                                "annotation_kind": "ImageBoundingBox",
                                "bounding_box": { "top": 200.0, "left": 407.0, "height": 172.0, "width": 176.0 }
                            }
                        ]
                    }
                }
            ]
        }
    }
}
Alles andere im Export – embeddings, metadata_fields, attachments, project_details – wird ignoriert. Es lohnt sich, die Einbettungen beim Export abzuwählen: In einem Beispiel machten sie etwa vier Fünftel der Datei aus, während auf die Felder, die Platform tatsächlich einliest, nur ein Fünftel entfiel.
Derzeit werden nur Begrenzungsrahmen und Polygone eingelesen, und zwar ausschließlich aus Objektannotationen. Bildbezogene Klassifizierungen befinden sich an anderer Stelle im Export und werden übersprungen. Bei einem Projekt, das ausschließlich mit dem Segmentierungswerkzeug (Pinsel), mit Punkten, Polylinien oder Klassifizierungen beschriftet wurde, werden zwar die Bilder, aber keine Annotationen importiert, ohne dass ein Fehler gemeldet wird. Du erkennst das auf der Datensatzseite: Bei einem importierten Datensatz, dessen Labels erhalten geblieben sind, werden neben der Bildanzahl auch die Anzahl der Labels und Annotationen angezeigt. Sind die Labels verloren gegangen, werden beide Angaben nicht angezeigt.
Ein Labelbox-Export verweist über signierte URLs auf die einzelnen Bilder, statt die Bilddaten einzubetten. Diese Signaturen laufen ab. Platform lädt die Bilder über diese URLs herunter und prüft zuvor eine Stichprobe. Sind alle Links eines Exports abgelaufen, schlägt der Import sofort fehl und erklärt den Grund – exportiere die Daten erneut aus Labelbox und lade die neue Datei hoch. Bei einem teilweise abgelaufenen Export werden die noch erreichbaren Bilder importiert und die übrigen übersprungen. Lade die Datei daher bald nach dem Export hoch.
Ein Export mit Begrenzungsrahmen und Polygonen wird als Segmentierungsdatensatz importiert. Ein Segmentierungsdatensatz enthält ausschließlich Polygongeometrien – Begrenzungsrahmenannotation werden weder für das Training verwendet noch in Versions-Exporte aufgenommen. Exportiere Begrenzungsrahmen und Polygone als separate Labelbox-Projekte, wenn du beides benötigst. Polygone müssen außerdem mindestens drei Punkte enthalten, damit sie eingelesen werden.
Häufig gestellte Fragen#
Begrenzungsrahmen werden als Erkennungsdatensatz und Polygone als Segmentierungsdatensatz importiert. Segmentierungsmasken, Punkte, Polylinien, Beziehungen und Klassifizierungen werden derzeit nicht eingelesen. Daher werden bei einem Projekt, das ausschließlich mit diesen Werkzeugen beschriftet wurde, die Bilder ohne Annotationen importiert.
Platform liest NDJSON mit einem JSON-Objekt pro Zeile ein. Ein Export, der als einzelnes JSON-Array gespeichert wurde, wird vollständig übersprungen. Verwende die obige SDK-Schleife oder den Download Export data von Labelbox, der bereits im NDJSON-Format vorliegt.
Labelbox-Exporte verweisen über signierte URLs auf Bilder. Diese Signaturen laufen ab. Exportiere die Daten erneut aus Labelbox und lade die neue Datei bald nach Abschluss hoch.
Nein. Ein gemischter Export wird als Segmentierungsdatensatz importiert, und dabei werden nur die Polygone verwendet. Exportiere Begrenzungsrahmen und Polygone als separate Labelbox-Projekte, wenn du beides benötigst.