CIFAR-100 데이터셋#
CIFAR-100 (고등연구계획국) 데이터셋은 100개의 세분화된 클래스에 각각 600개씩, 총 60,000개의 32x32 컬러 이미지가 균등하게 분포된 이미지 분류 벤치마크이며, 이 클래스들은 다시 20개의 상위 클래스로 그룹화됩니다. Alex Krizhevsky가 제작했으며, 50,000개의 학습 이미지와 10,000개의 테스트 이미지로 구성된 사전 정의된 분할을 제공하므로 CIFAR-10 데이터셋보다 더 어렵고 세분화된 자매 데이터셋입니다.
Ultralytics Platform의 CIFAR-100을 살펴보고 샘플을 미리 확인하고, 데이터셋 통계를 검사하며, 학습을 위해 복제할 수 있습니다.
주요 기능#
- CIFAR-100에는 32x32 픽셀의 컬러 이미지 60,000개가 포함되어 있으며, 100개 클래스에 균등하게 나뉩니다.
- 각 클래스에는 정확히 600개의 이미지가 포함되어 있으며, 학습용 500개와 테스트용 100개로 구성되므로 데이터셋이 완벽하게 균형을 이룹니다.
- 100개의 세분화된 클래스는 더 높은 수준의 분류를 위해 20개의 상위 클래스로 그룹화됩니다.
- 데이터셋에는 사전 정의된 학습/테스트 분할이 포함되어 있으므로 수동 또는 자동 분할이 필요하지 않습니다.
- CIFAR-100은 세분화된 이미지 분류 및 객체 인식 연구를 위한 표준 벤치마크입니다.
데이터셋 구조#
CIFAR-100에는 공식적인 사전 정의 분할이 포함되어 있으므로 자동 또는 수동 분할이 필요하지 않습니다:
- 클래스: 100개의 세분화된 클래스, 20개의 상위 클래스로 그룹화
- 전체 이미지: 60,000개 (32x32 컬러)
- 학습 세트: 50,000개 이미지 (클래스당 500개)
- 테스트 세트: 10,000개 이미지 (클래스당 100개)
CIFAR-100에는 별도의 검증 폴더가 없으므로 Ultralytics는 기본적으로 학습 중 10,000개 이미지로 구성된 테스트 세트를 검증 분할로 사용합니다. data="cifar100"으로 학습하면 100개의 세분화된 클래스를 학습합니다.
응용 분야#
CIFAR-100은 고전적인 합성곱 신경망 (CNNs) 및 서포트 벡터 머신 (SVMs)부터 최신 딥 아키텍처에 이르기까지 이미지 분류 모델을 학습하고 평가하는 데 널리 사용됩니다. 100개의 세분화된 클래스와 작은 이미지 크기로 인해 머신 러닝 연구, 알고리즘 비교 및 컴퓨터 비전 실험을 위한 까다로운 벤치마크입니다.
사용법#
이미지 크기 32로 100개의 에포크 동안 CIFAR-100에서 YOLO 모델을 학습합니다. 사용 가능한 전체 인수 목록은 학습 페이지와 이미지 분류 작업 가이드를 참조하십시오.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar100", epochs=100, imgsz=32)
샘플 이미지 및 주석#
CIFAR-100 데이터셋의 샘플 이미지:
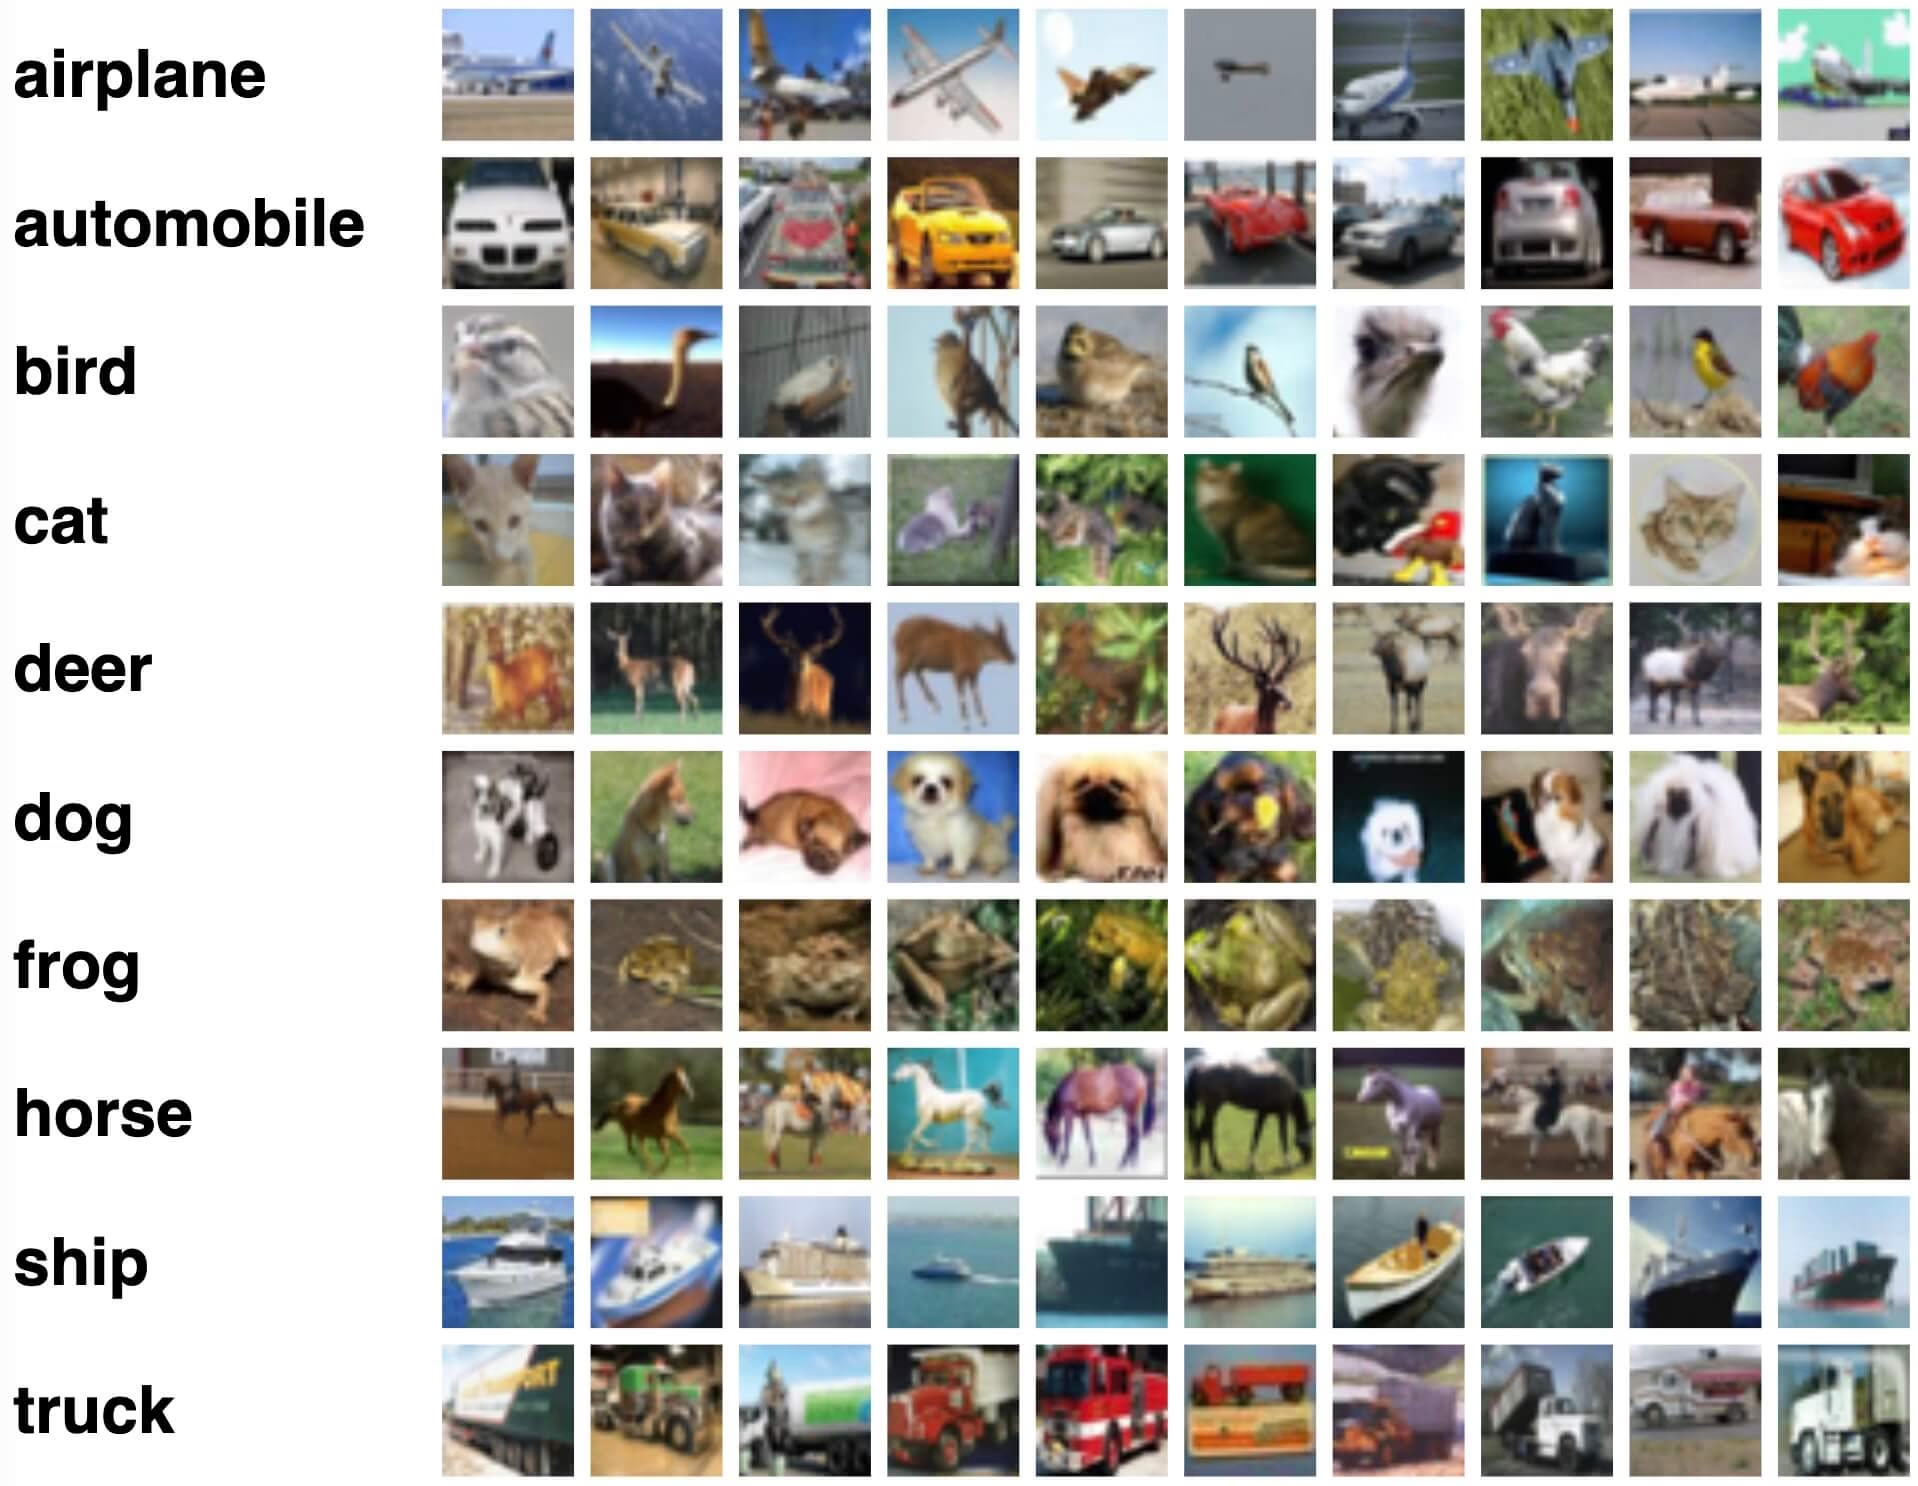
샘플은 CIFAR-100 데이터셋에 포함된 객체의 다양성을 보여 주며, 견고한 이미지 분류 모델을 학습하기 위해 다양한 데이터셋이 중요하다는 점을 강조합니다.
인용 및 감사의 글#
연구 또는 개발 작업에서 CIFAR-100 데이터셋을 사용하는 경우 다음 논문을 인용하십시오:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
머신 러닝 및 컴퓨터 비전 연구 커뮤니티에 귀중한 리소스인 CIFAR-100 데이터셋을 제작하고 유지 관리한 Alex Krizhevsky에게 감사의 뜻을 전합니다. CIFAR-100 데이터셋과 제작자에 대한 자세한 내용은 CIFAR-100 데이터셋 웹사이트를 방문하십시오.
FAQ#
CIFAR-100 데이터셋은 세분화된 이미지 분류 및 객체 인식 모델을 학습하고 벤치마킹하는 데 널리 사용됩니다. 20개의 상위 클래스로 그룹화된 100개 클래스에 걸쳐 32x32 컬러 이미지 60,000개가 포함되어 있어, CIFAR-10보다 더 어려운 벤치마크입니다. 또한 합성곱 신경망 (CNNs) 및 서포트 벡터 머신 (SVMs)과 같은 알고리즘과 Ultralytics YOLO로 구축된 딥 러닝 모델을 평가하는 데 사용됩니다.
CIFAR-100에서 Ultralytics YOLO 모델을 학습하려면 아래 코드 조각을 사용하십시오. 데이터셋은 처음 사용할 때 자동으로 다운로드됩니다. 전체 인수 목록은 모델 학습 페이지를 참조하십시오.
학습 예제from ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar100", epochs=100, imgsz=32)CIFAR-100에는 사과, 돌고래, 단풍나무, 오토바이, 로켓과 같은 100개의 세분화된 클래스가 있으며, 각 클래스에 정확히 600개의 이미지가 포함되어 총 60,000개의 이미지로 구성됩니다. 이 100개 클래스는 다시 20개의 상위 클래스(예: 나무 상위 클래스에는 단풍나무, 참나무, 야자나무, 소나무, 버드나무가 포함됨)로 그룹화됩니다.
data="cifar100"으로 학습하면 100개의 세분화된 클래스를 사용합니다.CIFAR-100에는 학습 이미지 50,000개와 테스트 이미지 10,000개로 구성된 사전 정의 분할이 포함되어 있으며, 클래스당 학습 이미지 500개와 테스트 이미지 100개가 정확히 할당됩니다. Ultralytics가 자동으로 분할하는 폴더 기반 분류 데이터셋과 달리 CIFAR-100의 공식 분할은 그대로 사용되며, 기본적으로 학습 중 테스트 세트가 검증 분할로 사용됩니다.
예. Ultralytics Platform을 사용하면 데이터셋을 관리하고, 이미지 분류 모델을 학습하며, 광범위한 코딩 없이 모델을 배포할 수 있습니다. 클라우드에서 CIFAR-100 실험을 실행하는 편리한 방법이며, 자세한 옵션은 분류 데이터셋 개요에서 확인할 수 있습니다.