ImageNet 데이터셋#
Ultralytics ImageNet 데이터셋(data="imagenet")은 이미지 분류 모델을 학습하고 벤치마킹하는 데 사용되는 ImageNet-1k / ILSVRC-2012 하위 집합입니다. 객체 클래스 1,000개, 학습 이미지 1,281,167개, 검증 이미지 50,000개로 구성되고, 일반적으로 이미지 크기 224x224로 학습하며, 다운로드 데이터의 크기는 약 144 GB입니다. 더 광범위한 ImageNet 데이터베이스에는 20,000개가 넘는 카테고리에 걸쳐 WordNet 시셋으로 주석이 달린 고해상도 이미지가 1,400만 개 이상 포함되어 있습니다. 그러나 Ultralytics는 컴퓨터 비전 분야의 딥러닝에서 사실상의 벤치마크가 된 표준화된 ILSVRC 하위 집합(1,000개 클래스)을 사용해 학습합니다.
ImageNet 사전 학습 모델#
| 모델 | 크기 (픽셀) | acc top1 | acc top5 | 속도 CPU ONNX (ms) | 속도 T4 TensorRT10 (ms) | 파라미터 (M) | FLOPs (B), 224 기준 |
|---|---|---|---|---|---|---|---|
| YOLO26n-cls | 224 | 71.4 | 90.1 | 5.0 ± 0.3 | 1.1 ± 0.0 | 2.8 | 0.4 |
| YOLO26s-cls | 224 | 76.0 | 92.9 | 7.9 ± 0.2 | 1.3 ± 0.0 | 6.7 | 1.5 |
| YOLO26m-cls | 224 | 78.1 | 94.2 | 17.2 ± 0.4 | 2.0 ± 0.0 | 11.6 | 4.8 |
| YOLO26l-cls | 224 | 79.0 | 94.6 | 23.2 ± 0.3 | 2.8 ± 0.0 | 14.1 | 6.0 |
| YOLO26x-cls | 224 | 79.9 | 95.0 | 41.4 ± 0.9 | 3.8 ± 0.0 | 29.6 | 13.5 |
주요 기능#
- Ultralytics
imagenet데이터셋은 이미지 분류의 표준 사전 학습 벤치마크인 1,000개 클래스의 이미지 1,281,167개(학습)와 50,000개(검증)(ILSVRC-2012)를 제공합니다. - 클래스는 WordNet 계층 구조에 따라 구성되며, 각 클래스는 시셋(synset, 동의어 집합)에 해당합니다.
- 이미지는 224x224 크기로 학습되며, 전체 데이터셋의 다운로드 용량은 약 ~144 GB입니다.
- 매년 개최되는 ImageNet 대규모 시각 인식 챌린지(ILSVRC)는 컴퓨터 비전 연구의 발전에 중요한 역할을 해 왔습니다.
데이터셋 구조#
Ultralytics ImageNet 데이터셋은 ILSVRC-2012 분할을 사용합니다:
| 분할 | 이미지 | 클래스 |
|---|---|---|
| 학습 | 1,281,167 | 1,000 |
| 검증 | 50,000 | 1,000 |
이미지는 WordNet 시셋 ID를 이름으로 사용하는 클래스별 폴더(예: n01440764)에 저장되며, 이는 Ultralytics 분류 학습에서 요구하는 디렉터리 구조입니다. 1,000개 클래스는 각각 WordNet 시셋에 대응하며 별도의 테스트 분할은 없으므로, 검증 이미지 50,000개를 사용해 정확도를 측정합니다.
ImageNet-1k의 다운로드 용량은 약 ~144 GB이므로 학습 전에 디스크 공간이 충분한지 확인하세요. 빠른 실험에는 동일한 폴더 형식을 사용하고 훨씬 짧은 시간에 학습할 수 있는 소규모 ImageNette 및 ImageNet10 하위 집합을 사용하세요.
ImageNet 대규모 시각 인식 챌린지(ILSVRC)#
매년 개최되는 ImageNet 대규모 시각 인식 챌린지(ILSVRC)는 연구자들이 일관된 평가 지표를 갖춘 대규모 표준 데이터셋에서 알고리즘을 벤치마킹할 수 있게 했습니다. 이 대회는 이미지 분류, 객체 탐지 및 기타 비전 작업을 위한 딥러닝의 주요 발전을 이끌었습니다. 특히 AlexNet이 2012년 우승하면서 현대 딥러닝 시대의 시작에 기여했습니다.
응용 분야#
ImageNet 데이터셋은 이미지 분류, 객체 탐지, 객체 위치 파악을 위한 딥러닝 모델을 학습하고 평가하는 데 널리 사용됩니다. AlexNet, VGG, ResNet과 같은 주요 아키텍처는 모두 ImageNet을 사용해 개발되고 벤치마킹되었으며, ImageNet 사전 학습 가중치는 여러 비전 작업의 전이 학습에서 여전히 흔히 사용되는 시작점입니다.
사용법#
이미지 크기를 224x224로 설정하고 ImageNet에서 YOLO 분류 모델을 100개의 에포크 동안 학습하려면 아래 코드 조각을 사용하세요. 사용 가능한 인수 전체 목록은 모델 학습 페이지를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-cls.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델 학습
results = model.train(data="imagenet", epochs=100, imgsz=224)
Ultralytics Platform을 사용해 분류 데이터셋을 관리하고 클라우드에서 학습을 실행할 수도 있습니다.
샘플 이미지 및 어노테이션#
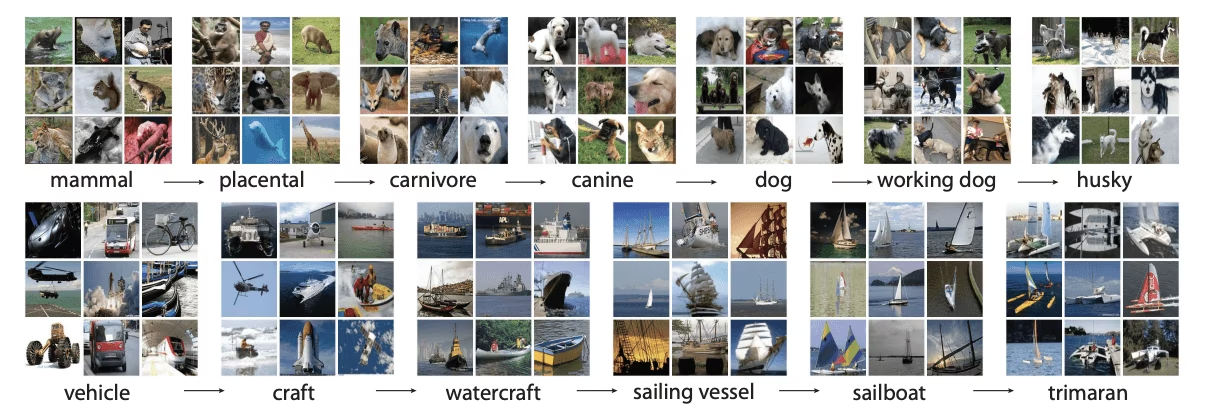
ImageNet 데이터셋은 ILSVRC-2012 클래스 1,000개를 포함하며, 컴퓨터 비전 모델을 학습하고 평가하는 데 다양하고 광범위한 자료를 제공합니다. 다음은 데이터셋의 이미지 예시입니다:
인용 및 감사의 글#
연구 또는 개발 작업에서 ImageNet 데이터셋을 사용하는 경우 다음 논문을 인용해 주세요:
@article{ILSVRC15,
         author = {Olga Russakovsky and Jia Deng and Hao Su and Jonathan Krause and Sanjeev Satheesh and Sean Ma and Zhiheng Huang and Andrej Karpathy and Aditya Khosla and Michael Bernstein and Alexander C. Berg and Li Fei-Fei},
         title={ImageNet Large Scale Visual Recognition Challenge},
         year={2015},
         journal={International Journal of Computer Vision (IJCV)},
         volume={115},
         number={3},
         pages={211-252}
}
머신 러닝 및 컴퓨터 비전 연구 커뮤니티에 귀중한 자료인 ImageNet 데이터셋을 만들고 관리해 온 Olga Russakovsky, Jia Deng, Li Fei-Fei가 이끈 ImageNet 팀에 감사드립니다. ImageNet 데이터셋과 제작자에 관한 자세한 내용은 ImageNet 웹사이트를 방문하세요.
자주 묻는 질문#
ImageNet 데이터셋은 WordNet 시셋으로 주석이 달린 고해상도 이미지 1,400만 개 이상을 포함하는 대규모 이미지 데이터베이스입니다. Ultralytics의
data="imagenet"은 이미지 분류 사전 학습의 사실상 벤치마크인 표준화된 ILSVRC-2012 하위 집합(1,000개 클래스)을 사용해 학습합니다. AlexNet, VGG, ResNet과 같은 주요 모델이 ImageNet으로 학습되고 벤치마킹되었으며, 이는 컴퓨터 비전 발전에서 ImageNet이 수행한 역할을 보여 줍니다.Ultralytics
imagenet데이터셋은 ILSVRC-2012 하위 집합을 사용하며, 여기에는 클래스 1,000개, 학습 이미지 1,281,167개, 검증 이미지 50,000개가 포함됩니다. 일반적으로 이미지 크기 224x224로 학습하며 다운로드 용량은 약 144 GB입니다. 전체 ImageNet 데이터베이스는 20,000개가 넘는 WordNet 시셋의 이미지 1,400만 개 이상으로 훨씬 규모가 크지만, 분류 학습과 벤치마킹에는 1,000개 클래스의 하위 집합이 사용됩니다.ImageNet에서 Ultralytics YOLO 모델을 학습하려면 사전 학습된 분류 모델을 불러오고
data을imagenet로 지정하세요:학습 예제from ultralytics import YOLO # 모델 로드 model = YOLO("yolo26n-cls.pt") # 사전 학습된 모델을 불러옵니다(학습에 권장). # 모델 학습 results = model.train(data="imagenet", epochs=100, imgsz=224)자세한 학습 지침은 학습 페이지를 참조하세요.
Ultralytics YOLO26 사전 학습 모델은 다양한 컴퓨터 비전 작업에서 속도와 정확도 측면의 최첨단 성능을 제공합니다. 예를 들어 top-1 정확도 71.4%, top-5 정확도 90.1%를 달성하는 YOLO26n-cls 모델은 실시간 애플리케이션에 최적화되어 있습니다. 사전 학습 모델을 사용하면 처음부터 학습할 때 필요한 컴퓨팅 리소스를 줄이고 개발 주기를 단축할 수 있습니다. ImageNet 사전 학습 모델 섹션에서 YOLO26 모델의 성능 지표를 자세히 알아보세요.
매년 개최되는 ImageNet 대규모 시각 인식 챌린지(ILSVRC)는 대규모 표준 데이터셋에서 알고리즘을 평가하는 경쟁의 장을 제공해 컴퓨터 비전의 발전을 이끌었습니다. 일관된 평가 지표는 이미지 분류, 객체 탐지, 이미지 분할의 혁신을 촉진하며 딥러닝과 컴퓨터 비전의 한계를 지속적으로 확장했습니다.