Qualcomm-QNN-Export für Ultralytics-YOLO-Modelle#
Für die Bereitstellung von Computer-Vision-Modellen auf Qualcomm-Snapdragon-Geräten ist ein Modellformat erforderlich, das für die Laufzeitumgebung Qualcomm AI Engine Direct (QNN) optimiert ist. Wenn du Ultralytics YOLO-Modelle ins QNN-Format exportierst, kannst du beschleunigte Inferenz direkt auf dem Gerät auf Snapdragon-CPU-, Adreno-GPU- und Hexagon-NPU-Hardware ausführen, wie sie in Milliarden von Mobiltelefonen, Laptops, Fahrzeugsystemen und IoT-Geräten zu finden ist. Diese Anleitung zeigt, wie du YOLO nach Qualcomm QNN exportierst und für schnelle, stromsparende Inferenz auf Snapdragon-Hardware bereitstellst.
Das offizielle Ultralytics-Flutter-Plugin bietet optionale QNN-Unterstützung für Echtzeit-Inferenz mit der Kamera und Vorhersagen für einzelne Bilder bei allen sieben YOLO26-Aufgaben. Aktiviere die QNN-Laufzeitumgebung und füge deren ONNX-Runtime-Abhängigkeit wie in der README des Plugins beschrieben hinzu. Informationen zur Bereitstellung auf iOS findest du im Ultralytics YOLO iOS SDK und in der CoreML-Integration.
Exportiere Klassifizierungsmodelle unter imgsz=224. Exportiere Erkennungs-, Segmentierungs-, semantische, Tiefen-, Pose- und OBB-Modelle unter imgsz=640. Dieser 224/640-Standard wird von den offiziellen mobilen QNN-, LiteRT- und CoreML-Assets gemeinsam verwendet. Sofort einsatzbereite v73- und v81-Assets für alle sieben Nano-Aufgaben sind im Release yolo-flutter-app v0.6.6 verfügbar.
Was ist Qualcomm QNN?#
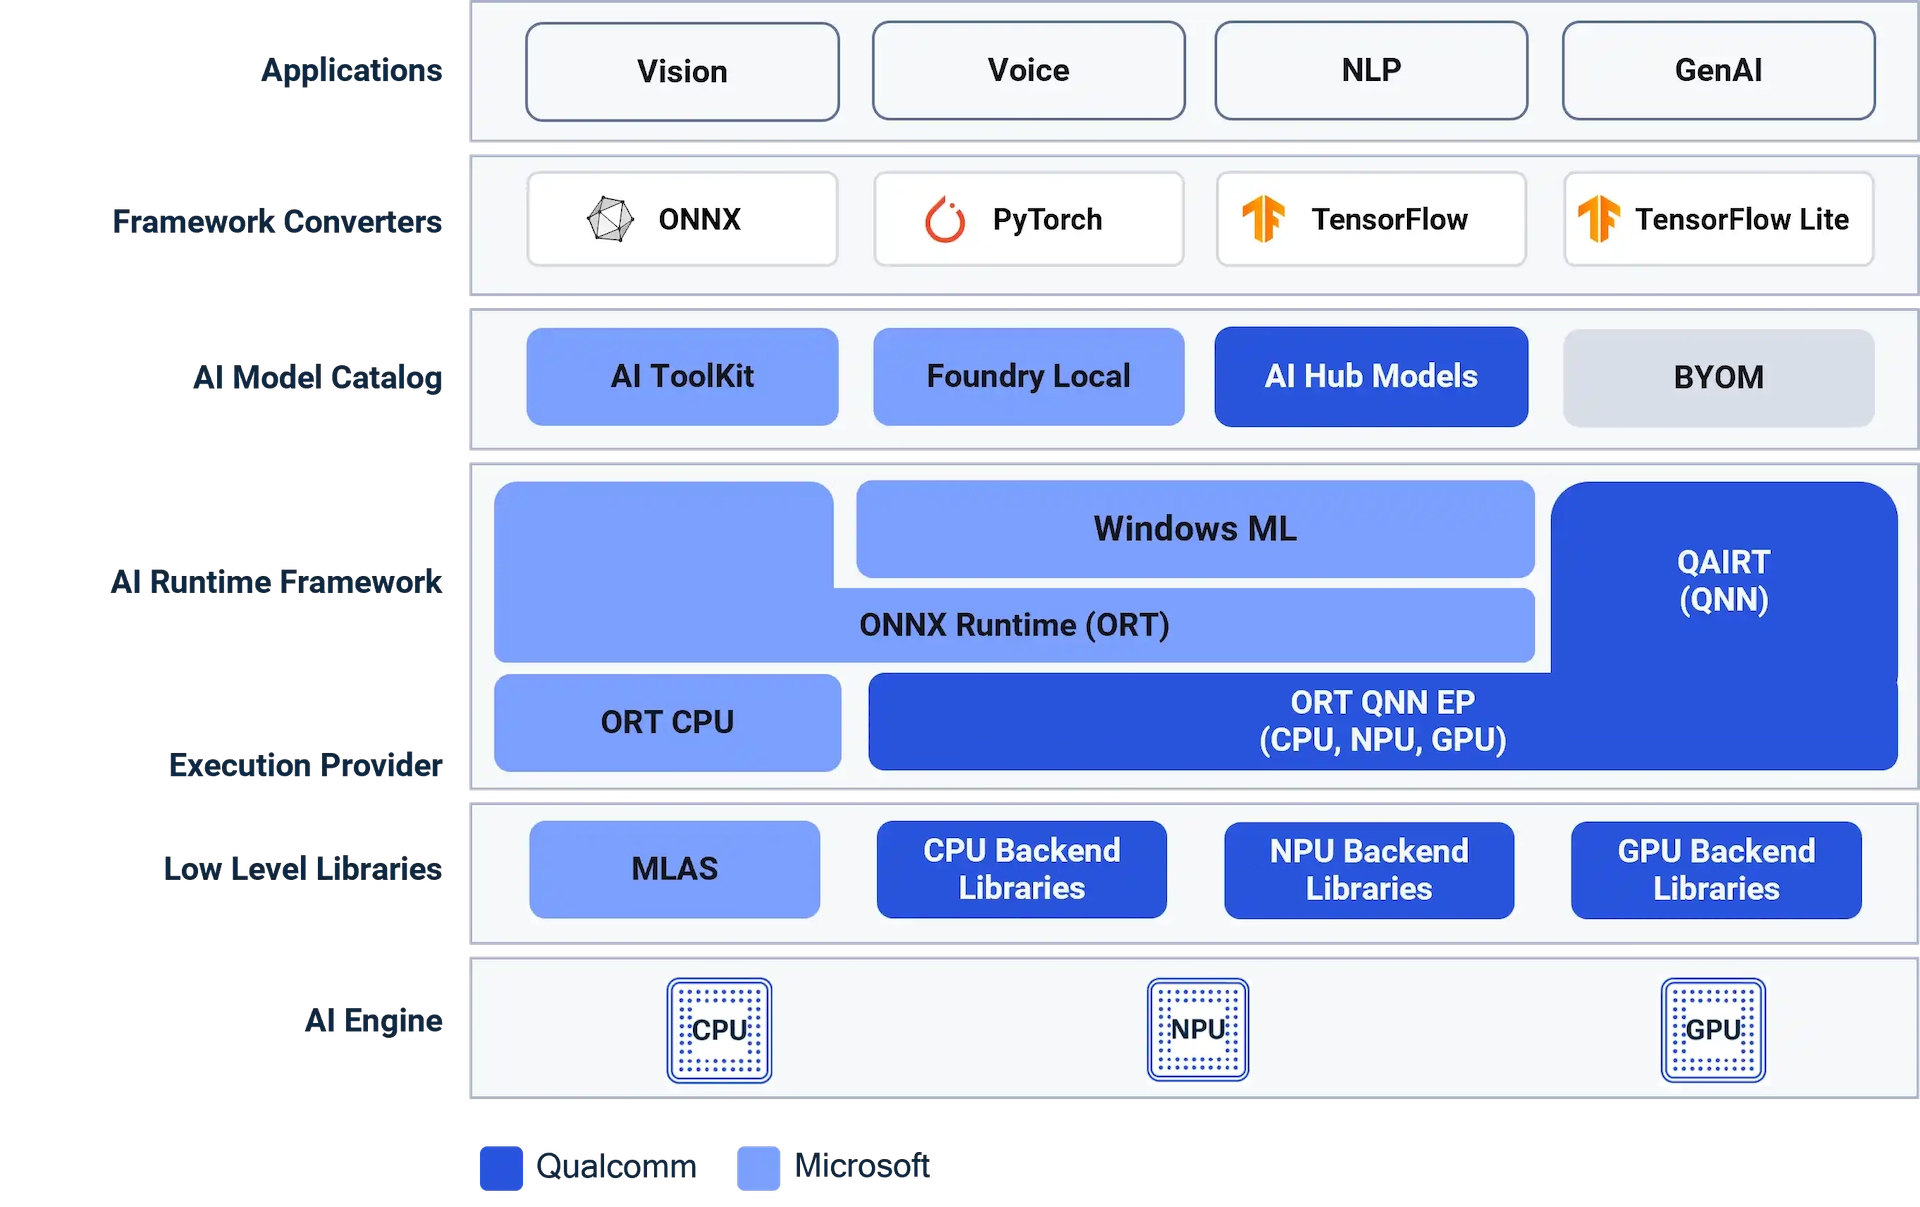
Qualcomm AI Engine Direct – allgemein als QNN bezeichnet und als Teil des SDK für die Qualcomm-KI-Laufzeitumgebung (QAIRT) vertrieben – ist Qualcomms hardwarenahe Inferenzplattform für Snapdragon-Prozessoren. Sie bietet eine einheitliche API mit Bibliotheken für die jeweiligen Ausführungsumgebungen, die auf die Snapdragon-CPU, die Adreno-GPU und den Hexagon-Tensorprozessor (HTP) abzielen – die dedizierte Einheit zur Verarbeitung neuronaler Netze (NPU) in modernen Snapdragon-SoCs. QNN bietet Entwicklern umfassenden Zugriff auf diese Snapdragon-KI-Beschleuniger und ist der moderne Nachfolger des älteren SDK für die Snapdragon-Engine zur neuronalen Verarbeitung (SNPE). QNN ermöglicht KI direkt auf Geräten auf den Mobilplattformen Snapdragon 8 Gen 2, 8 Gen 3 und 8 Elite, auf Snapdragon-X-Laptops sowie in Produkten für die Automobilbranche und XR.
Warum nach Qualcomm QNN exportieren?#
Snapdragon ist die weltweit am weitesten verbreitete mobile Computerplattform. Durch den Export von Ultralytics YOLO ins Qualcomm-QNN-Format kannst du die dedizierte KI-Hardware dieser Geräte nutzen:
- Beschleunigung durch Hexagon-NPU: YOLO auf dem Hexagon Tensor Processor auszuführen, ermöglicht einen deutlich höheren Durchsatz und einen geringeren Energieverbrauch als die Inferenz auf der CPU – ideal für Echtzeit-Inferenz und dauerhaft aktive Computer Vision auf Snapdragon.
- Direkt auf dem Gerät und offline: Die QNN-Inferenz läuft vollständig auf dem Snapdragon-Gerät. Es sind also keine Cloud-Verbindungen nötig, die Latenz bleibt niedrig und die Daten verlassen das Gerät nicht.
- Effizienz durch Quantisierung: Beim QNN-Export werden die YOLO-Gewichte auf INT8 und die Aktivierungen auf 16 Bit quantisiert. Das entspricht dem bevorzugten Verhältnis von Genauigkeit und Leistung der Hexagon-NPU, verkleinert das Modell und maximiert die Bilder pro Sekunde auf akkubetriebener Hardware.
- Ein Format für viele Geräte: Ein einzelner Qualcomm-QNN-Export unterstützt Snapdragon-CPU, Adreno-GPU und Hexagon-NPU in den Snapdragon-8-Gen-2-, 8-Gen-3- und 8-Elite-Familien sowie darüber hinaus.
- Qualcomm-KI-Stack für den Produktionseinsatz: QNN (Qualcomm AI Engine Direct / QAIRT) ist Qualcomms aktuelle, aktiv gepflegte Laufzeitumgebung für KI direkt auf dem Gerät und der empfohlene Ersatz für SNPE.
QNN-Exportformat#
Ultralytics kompiliert YOLO-Modelle lokal nach QNN und verwendet dafür den QNN Execution Provider von ONNX Runtime (das über pip installierbare Paket onnxruntime-qnn, das die QAIRT-Bibliotheken enthält). Der Exporter konvertiert dein Modell nach ONNX, quantisiert es mit Kalibrierungsdaten auf 16-Bit-Aktivierungen und INT8-Gewichte (das empfohlene Verhältnis für die Hexagon-NPU) und initialisiert dann eine ONNX-Runtime-Sitzung mit aktiviertem Kontext-Binär-Cache. Dadurch wird der quantisierte Graph in eine QNN-Kontextdatei kompiliert, die in <model>_qnn.onnx eingebettet ist. Ein Qualcomm-Konto, ein Cloud-Upload oder ein separater SDK-Download sind nicht erforderlich.
Anders als der cloudbasierte Qualcomm AI Hub, der Modelle auf von Qualcomm gehosteten Snapdragon-Geräten kompiliert und profiliert und ein Qualcomm-Konto erfordert, läuft der QNN-Export von Ultralytics vollständig auf deinem eigenen Rechner. Dafür genügt ein Aufruf von export(format="qnn", imgsz=640) (imgsz=224 für die Klassifizierung). Du erhältst dasselbe QNN-/QAIRT-Laufzeitziel – Snapdragon-CPU, Adreno-GPU und Hexagon-NPU – ohne Registrierung, Upload-Beschränkungen oder Wartezeiten und kannst es direkt in den standardmäßigen YOLO-Exportworkflow integrieren.
Die exportierte Datei *_qnn.onnx ist in sich abgeschlossen: Sie enthält die QNN-Kontextdatei und ONNX-Metadaten wie Klassennamen, Bildgröße und Aufgabe.
Wichtige Funktionen von QNN-Modellen#
- Quantisierung: Das Modell wird mit dem ONNX-Runtime-QNN-QDQ-Verfahren und einem Kalibrierungsdatensatz auf 16-Bit-Aktivierungen und INT8-Gewichte quantisiert. Dies entspricht dem von der Hexagon-NPU empfohlenen Verhältnis von Genauigkeit und Leistung. Erfahre mehr über die Modellquantisierung.
- Vollständig lokale Kompilierung: Die Kontextdatei wird vollständig auf deinem Host-Rechner erstellt – ohne Qualcomm-Konto, API-Token oder Cloud-Upload.
- Volle Snapdragon-Beschleunigung: Führe die Inferenz über eine einheitliche Laufzeitumgebung auf der Hexagon-NPU (HTP), der Adreno-GPU oder der CPU aus.
- Breite Geräteunterstützung: Unterstützt die vielfältigen Snapdragon-Plattformen in Mobiltelefonen, PCs (Windows auf Snapdragon), Fahrzeugen, XR- und Embedded-Produkten.
- Vorkompilierte Kontextdatei: Eine bereitgestellte Kontextdatei minimiert die Kompilierung des Graphen auf dem Gerät und verkürzt so die Ladezeit des Modells auf dem Zielgerät.
- Eigenständige Ausgabe: Die exportierte ONNX-Datei enthält die vorkompilierte QNN-Kontextdatei und Metadaten, sodass sie sich einfach bereitstellen lässt.
Gemessene Leistung#
Android-Telefon#
Hardware: Xiaomi 17 mit 12 GB LPDDR5X-Speicher und Android 16 / API 36. Der 3-nm-Snapdragon 8 Elite Gen 5 (SM8850) verfügt über eine Qualcomm-Oryon-CPU mit 8 Kernen (2 Prime-Kerne mit bis zu 4,6 GHz und 6 Performance-Kerne mit bis zu 3,62 GHz), eine Adreno-GPU und eine Hexagon-NPU (HTP v81).
| Modell | Aufgabe | Größe (Pixel) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Detect | 640 | 52.2 1.8 / 48.1 / 2.4 | 15.8 2.3 / 8.9 / 4.6 | 10.7 1.8 / 6.7 / 2.2 |
| YOLO26n-seg | Segment | 640 | 73.4 1.8 / 65.6 / 6.0 | 33.2 1.8 / 23.8 / 7.6 | 17.4 1.8 / 9.9 / 5.7 |
| YOLO26n-sem | Semantisch | 640 | 61.2 1.8 / 51.1 / 8.3 | 34.2 1.8 / 24.0 / 8.3 | 11.5 1.8 / 7.1 / 2.6 |
| YOLO26n-depth | Tiefe | 640 | 124.4 1.9 / 115.1 / 7.4 | 23.0 1.8 / 13.5 / 7.7 | 35.2 1.8 / 26.1 / 7.3 |
| YOLO26n-cls | Klassifizieren | 224 | 4.4 0.4 / 4.0 / 0.0 | 3.1 0.8 / 2.1 / 0.2 | 1.2 0.6 / 0.6 / 0.0 |
| YOLO26n-pose | Pose | 640 | 57.4 1.8 / 53.8 / 1.8 | 16.6 2.7 / 10.1 / 3.9 | 10.9 1.8 / 7.0 / 2.0 |
| YOLO26n-obb | OBB | 640 | 50.3 1.8 / 47.2 / 1.4 | 11.7 1.8 / 7.8 / 2.0 | 8.6 1.8 / 5.7 / 1.1 |
- Die Geschwindigkeitswerte sind Latenzen für einzelne Bilder im Burst-Modus – der Mittelwert aus 15 Durchläufen nach 3 Aufwärmdurchläufen auf
bus.jpg, gemessen mit dem geräteseitigen Benchmark-Testprogramm0.6.10des Flutter-Plugins und den standardisierten Assetsv0.6.6. Die Reihenfolge der Backends wechselte zwischen den Aufgaben in einem sequenziellen Durchlauf. Native Protokolle bestätigten, dass jede CPU-Zeile LiteRT CPU/XNNPACK, jede GPU-Zeile den vollständigen Graphen an LiteRT OpenCL (LITERT_CL) und jede NPU-Zeile das QNN-Hexagon-HTP-Backend verwendete. - Der ausführliche Benchmarkbericht ist in der Flutter-Leistungsdokumentation zu finden.
- Vergleiche weitere Android-Geräte in der LiteRT-Integration und Apple-Geräte in der CoreML-Integration.
Windows auf einem Snapdragon-Laptop#
Dieser ältere Testlauf verwendete QNN-Binärdateien v73 vor der Standardisierung; für semantische Segmentierung und OBB wurden Eingaben mit 1024 px verwendet. Der Test lief auf einem Lenovo Laptop mit 32 GB Speicher und Windows 11. Der Snapdragon X Elite (X1E78100) verfügt über eine Qualcomm-Oryon-CPU mit 12 Kernen, eine Adreno-GPU und eine Hexagon-NPU (HTP v73); das genaue Lenovo-Modell wurde nicht aufgezeichnet. Dieser Vergleich unter Windows auf Snapdragon stellt die native PyTorch-FP32-CPU-Baseline, mit der die meisten Desktopentwickler beginnen, dem ONNX-Runtime-QNN-Hexagon-HTP-Pfad gegenüber. Jede Zelle zeigt die gesamte Laufzeit von model.predict(); darunter stehen die gemeldeten Zeiten für Vorverarbeitung, Inferenz und Nachverarbeitung. Die Gesamtzeit kann Framework-Overhead außerhalb dieser drei Phasen enthalten. Die CPU-Werte stammen von PyTorch FP32 (torch==2.10.0+cpu), die NPU-Werte von ONNX Runtime QNN (onnxruntime-qnn==2.2.0, INT8-Gewichte / 16-Bit-Aktivierungen).
| Modell | Aufgabe | Größe (Pixel) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Detect | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segment | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Semantisch | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Klassifizieren | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Pose | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Die Geschwindigkeitswerte sind Latenzen bei Einzelbild-Bursts – der Mittelwert aus 100 Durchläufen nach 10 Aufwärmdurchläufen auf
bus.jpg, gemessen mittime.perf_counter()um den vollständigen Aufruf vonmodel.predict()auf einem thermisch abgekühlten Gerät (ultralytics==8.4.67, Python 3.12.10). - Die Hexagon NPU ist bei Aufgaben mit 640–1024 px ungefähr 2- bis 4-mal schneller als die PyTorch-CPU-Baseline (bei der Objekterkennung etwa ~3.4-mal), beim 224-px-Klassifikator, bei dem der feste Vorverarbeitungsaufwand die geringe Arbeitslast dominiert, sinkt der Vorsprung auf ~1.3-mal.
Unterstützte Aufgaben#
Der Qualcomm QNN-Export unterstützt alle sieben Ultralytics-Aufgaben. Semantische Segmentierung und Tiefenschätzung sind nur mit YOLO26 verfügbar, der einzigen Modellfamilie, die diese Ausgabeköpfe enthält.
| Aufgabe | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Erkennung | ✅ | ✅ | ✅ |
| Segmentierung | ✅ | ✅ | ✅ |
| Semantik | ❌ | ❌ | ✅ |
| Tiefe | ❌ | ❌ | ✅ |
| Klassifizierung | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Export nach QNN: YOLO-Modell konvertieren#
Exportiere ein Ultralytics-YOLO-Modell in das QNN-Format, um es auf Qualcomm-Hardware bereitzustellen. Die Kontextbinärdatei wird für eine Zielarchitektur des Hexagon Tensor Processor (HTP) oder einen unterstützten SoC fertiggestellt. Das Ziel wählst du mit dem Argument name aus – dasselbe Argument wird verwendet, um einen Chip beim RKNN-Export auszuwählen.
Unterstützte HTP-Ziele#
Übergib die Zielarchitektur oder den SoC über name (z. B. name="73" oder name="iq-8275"). Die Unterstützung richtet sich nach dem HTP-Ziel. Daher sind die folgenden Snapdragon-Einträge repräsentative Plattformen und keine vollständige Liste aller SoCs. Dragonwing-Geräte sind einzeln aufgeführt.
| Status | name | Hexagon HTP | Beispielgerät oder -plattform |
|---|---|---|---|
| ✅ Unterstützt | 68 | v68 | Snapdragon 888 |
| ✅ Unterstützt | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ Unterstützt | 73 | v73 | Snapdragon 8 Gen 2, X Elite (Standard) |
| ✅ Unterstützt | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ Unterstützt | 79 | v79 | Snapdragon 8 Elite |
| ✅ Unterstützt | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ Unterstützt | iq-8275 oder qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275 (QNN-SoC-Modell 82) |
| ❌ Nicht unterstützt | — | v66 | Dragonwing IQ-615 / QCS615 |
Dragonwing IQ-615 kann den Ultralytics-QNN-Kontextbinärdatei-Export nicht verwenden, da ONNX Runtime seinen v66-DSP nicht als Offline-HTP-Ziel bereitstellt. Ein standardmäßiger ONNX-Export kann weiterhin separat mit einem vom Board-BSP unterstützten CPU- oder GPU-Ausführungsanbieter integriert werden.
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)Der QNN-Export verwendet das Paket onnxruntime-qnn. Ab Version 2.4.0 werden vorgefertigte Wheels für Windows (x64 und ARM64) und Linux (x86-64 und ARM64) mit Python 3.11 oder höher bereitgestellt; macOS wird nicht als QNN-Host unterstützt. Die QNN-Kontextbinärdatei wird auf einem x64-Host erstellt. Für den Exportschritt ist kein Snapdragon-Gerät erforderlich.
Installation#
Führe zum Installieren der erforderlichen Pakete Folgendes aus:
# Install the required package for YOLO
pip install ultralytics
Das Paket onnxruntime-qnn (das den QNN Execution Provider für ONNX Runtime bereitstellt und die QAIRT-Bibliotheken enthält) wird beim ersten Export automatisch installiert. Eine ausführliche Anleitung und bewährte Vorgehensweisen zur Installation findest du in unserem Ultralytics-Installationsleitfaden. Wenn bei der Installation der für YOLO erforderlichen Pakete Probleme auftreten, findest du Lösungen und Tipps in unserem Leitfaden zu häufigen Problemen.
Verwendung#
Das QNN-Format unterstützt die Modi Export, Vorhersage und Validierung. Die Inferenz und Validierung erfolgen auf Qualcomm-Snapdragon-Hardware über den QNN Execution Provider von ONNX Runtime (dasselbe Paket onnxruntime-qnn, das auch für den Export verwendet wird). Exportiere dein Modell und lade es anschließend auf ein Snapdragon-Gerät, um Inferenz auszuführen oder die Genauigkeit zu validieren.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Export ins Qualcomm-QNN-Format (INT8, wird automatisch erzwungen) für das standardmäßige v73-HTP-Ziel
model.export(format="qnn", name="73", imgsz=640) # für die Klassifizierung imgsz=224 verwendenfrom ultralytics import YOLO
# Das exportierte QNN-Modell laden (auf einem Snapdragon-Gerät mit onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Inferenz ausführen
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Das exportierte QNN-Modell laden (auf einem Snapdragon-Gerät mit onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Die Genauigkeit anhand des COCO8-Datensatzes validieren
metrics = model.val(data="coco8.yaml")Exportargumente#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'qnn' | Zielformat des exportierten Modells, das die Kompatibilität mit der Qualcomm-QNN-Laufzeitumgebung festlegt. |
imgsz | int oder tuple | 640 | Gewünschte Bildgröße für die Modelleingabe. Möglich ist eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width). |
batch | int | 1 | Legt die Stapelgröße des Exportmodells fest, die in die erzeugte QNN-Kontextbinärdatei eingebettet wird. |
name | str | '73' | Zielarchitektur des Hexagon HTP (68, 69, 73, 75, 79 oder 81) oder unterstützter SoC (iq-8275 oder qcs8275). Die Kontextbinärdatei wird für dieses Ziel fertiggestellt. |
quantize | int oder str | 'w8a16'/automatisch | Quantisierungsgenauigkeit. Der QNN-HTP-Export quantisiert die Gewichte auf INT8 und die Aktivierungen auf 16 Bit ('w8a16'); diese Option wird automatisch aktiviert, wenn sie nicht angegeben ist. Ersetzt die veralteten Flags half/int8. |
simplify | bool | True | Vereinfacht den zwischengeschalteten ONNX-Graphen mit onnxslim. |
opset | int | None | Legt die ONNX-Operatorensatz-Version für den zwischengeschalteten ONNX-Graphen fest. Wenn nichts angegeben ist, wird die neueste unterstützte Version verwendet. |
data | str | None | Für die INT8-Kalibrierung verwendete Dataset-YAML-Datei; bei der Klassifizierung wird stattdessen ein Dataset-Verzeichnis oder ein integrierter Dataset-Name angegeben. Wird keine Angabe gemacht, wählt Ultralytics das standardmäßige Kalibrierungs-Dataset für die jeweilige Modellaufgabe aus. |
fraction | float, int oder list | 1.0 | Kalibrierungsteilstichprobe als Verhältnis, Bildanzahl oder [train, val, test]-Verhältnisse/-Anzahlen. Bei Listen mit zwei Elementen bleibt test vollständig erhalten, während 0 es überspringt. |
device | str | None | Legt das Gerät für den ONNX-Exportschritt fest: GPU (device=0) oder CPU (device=cpu). |
Beim QNN-Export wird das Modell auf Aktivierungen mit 16 Bit und INT8-Gewichte quantisiert – die empfohlene Balance zwischen Genauigkeit und Leistung für die Hexagon NPU. Dafür kommt der Ablauf zur QDQ-Quantisierung in ONNX Runtime mit Kalibrierungsbildern aus data zum Einsatz. quantize='w8a16' wird automatisch erzwungen.
Weitere Informationen zum Exportvorgang findest du auf der Ultralytics-Dokumentationsseite zum Export.
Ausgabestruktur#
Nach einem erfolgreichen Export wird eine eigenständige ONNX-Datei erstellt:
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
Die Datei yolo26n_qnn.onnx enthält die QNN-Kontextbinärdatei und wird auf dem Snapdragon-Gerät von ONNX Runtime mit dem QNN Execution Provider geladen. Außerdem enthält sie Modellmetadaten wie Klassennamen, Bildgröße und Aufgabe in ONNX metadata_props.
Exportierte YOLO-QNN-Modelle bereitstellen#
QNN-Modelle werden auf unterstützter Qualcomm-Hardware ausgeführt und ermöglichen so eine einfache Bereitstellung von Modellen auf dem Gerät. Auf einem kompatiblen Gerät, auf dem onnxruntime-qnn installiert ist, kannst du das exportierte Modell direkt mit der Ultralytics-API (yolo predict/yolo val; siehe oben unter Verwendung) ausführen. Ultralytics lädt die HTP-Kontextbinärdatei über den QNN Execution Provider für ONNX Runtime.
Für benutzerdefinierte Pipelines kannst du die Kontextbinärdatei auch direkt als ONNX mit ONNX Runtime laden. onnxruntime-qnn ist ein Plugin-Ausführungsanbieter. Registriere ihn daher zur Laufzeit:
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# Auf dem Snapdragon-Gerät das QNN-Plugin-EP registrieren und seine Geräte auswählen
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
Da die QNN-Kontextbinärdatei vorkompiliert ist, wird die Sitzung schnell geladen, ohne den Graphen auf dem Gerät neu zu kompilieren.
Anforderungen an Linux- und Yocto-BSPs#
Das Zielboard muss eine zueinander kompatible Qualcomm-Laufzeitumgebung und ein kompatibles BSP bereitstellen. Für die HTP-Inferenz umfasst dies den QNN Execution Provider für ONNX Runtime, libQnnSystem.so, libQnnHtp.so, die v75-HTP-Stub- und Skeleton-Bibliotheken für IQ-8275, FastRPC-Unterstützung im Userspace wie libcdsprpc.so, die DSP-Firmware sowie die entsprechenden FastRPC-/Kernel-Treiber. Die Skeleton-Bibliothek muss über den DSP-Bibliothekspfad des BSP gefunden werden können.
Diese Komponenten auf dem Zielgerät stammen aus dem QAIRT-/QNN-fähigen BSP des Board-Herstellers; sie sind nicht im exportierten Modell enthalten. Für die GPU-Ausführung sind stattdessen libQnnGpu.so und der passende Adreno-Userspace-Treiberstapel erforderlich. Die Ultralytics-Ausgabe format=qnn ist eine HTP-spezifische Kontextbinärdatei. Für die Bereitstellung auf GPU oder CPU solltest du daher mit einem standardmäßigen ONNX-Export statt mit der vorkompilierten Datei *_qnn.onnx beginnen.
Empfohlener Arbeitsablauf#
- Trainiere dein Modell mit dem Ultralytics-Trainingsmodus
- Exportiere das Modell mit
model.export(format="qnn", name="iq-8275", imgsz=640)auf einer unterstützten Plattform ins QNN-Format (verwendeimgsz=224für die Klassifizierung). - Stelle die exportierte Datei
*_qnn.onnxauf deinem Qualcomm-Gerät bereit. - Führe die Inferenz mit ONNX Runtime und dem QNN Execution Provider über das HTP-Backend aus.
Anwendungen in der Praxis#
YOLO-Modelle auf Qualcomm-Snapdragon-Hardware eignen sich für eine Vielzahl von Edge-KI-Anwendungen:
- Smartphones: Echtzeit-Objekterkennung und Szenenverständnis in Kamera- und Foto-Apps mit NPU-Beschleunigung.
- Windows auf Snapdragon: Computer Vision direkt auf dem Gerät in Copilot+-PCs, ohne Daten in die Cloud zu übertragen.
- Automobil: Fahrerüberwachung, Insassenerkennung und ADAS-Funktionen auf Snapdragon-Digital-Chassis-Plattformen.
- XR und Wearables: Wahrnehmung mit geringem Stromverbrauch und niedriger Latenz für AR-/VR-Headsets und Smart Glasses.
- IoT und Robotik: Effiziente Bildverarbeitung auf Snapdragon-betriebenen Kameras, Drohnen und eingebetteten Systemen.
Zusammenfassung#
In dieser Anleitung hast du erfahren, wie du Ultralytics-YOLO-Modelle lokal mit dem QNN Execution Provider von ONNX Runtime ins Qualcomm-QNN-Format exportierst. Die Exportpipeline konvertiert dein Modell in ONNX und kompiliert es anschließend auf deinem Hostcomputer in eine QNN-Kontextbinärdatei – ohne Qualcomm-Konto und ohne Cloud. Das Ergebnis ist eine Datei *_qnn.onnx, die über die QNN-/QAIRT-Laufzeitumgebung für Snapdragon-CPU-, Adreno-GPU- und Hexagon-NPU-Hardware optimiert ist.
Die Kombination aus Ultralytics YOLO und Qualcomms KI-Stapel für Geräte bietet eine effektive Lösung für anspruchsvolle Computer-Vision-Aufgaben im gesamten Snapdragon-Ökosystem.
Weitere Bereitstellungsoptionen für Geräte und Mobilgeräte findest du in den zugehörigen Exportanleitungen für ONNX, CoreML, NCNN, LiteRT, ExecuTorch, RKNN, Sony IMX500 und TensorRT. Um Formate vor der Auslieferung zu vergleichen, verwende den Benchmark-Modus. Eine vollständige Liste der Formate und Optionen findest du in der Dokumentation zum Exportmodus und auf der Seite mit dem Leitfaden zu Integrationen.
Häufig gestellte Fragen#
Du kannst dein Modell mit
export(format="qnn", imgsz=640)(imgsz=224für die Klassifizierung) oder den entsprechenden CLI-Argumenten exportieren. Beim Export wird zunächst ein ONNX-Modell erstellt und anschließend lokal mit dem QNN Execution Provider von ONNX Runtime in eine QNN-Kontextbinärdatei kompiliert. Das Paketonnxruntime-qnnwird beim ersten Export automatisch installiert.Beispielfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # für die Klassifizierung imgsz=224 verwendenNein. Der QNN-Export wird vollständig auf deinem lokalen Rechner mit dem Paket
onnxruntime-qnnausgeführt, das die QAIRT-Bibliotheken enthält. Ein Qualcomm-Konto, ein API-Token oder Netzwerkzugriff ist nicht erforderlich.Qualcomm AI Hub ist Qualcomms Cloud-Dienst zum Kompilieren, Profilieren und Benchmarken von Modellen auf gehosteten Snapdragon-Geräten und erfordert ein Qualcomm-Konto. Der Ultralytics-QNN-Export zielt auf dieselbe QNN-/QAIRT-Laufzeitumgebung (Snapdragon-CPU, Adreno-GPU und Hexagon NPU), kompiliert die Kontextbinärdatei jedoch lokal mit dem QNN Execution Provider von ONNX Runtime – ohne Konto, Upload oder Warteschlange. So gelangst du am schnellsten von einem
.pt-Modell zu einem Snapdragon-fertigen Build direkt im standardmäßigen YOLO-Exportablauf.onnxruntime-qnnab Version 2.4.0 stellt vorgefertigte Wheels für Windows (x64 und ARM64) und Linux (x86-64 und ARM64) mit Python 3.11 oder höher bereit; macOS wird nicht als QNN-Host unterstützt. Die Kontextbinärdatei wird auf einem x64-Host erstellt. Ein physisches Snapdragon-Gerät ist dafür nicht erforderlich.Exportiere das Modell mit
model.export(format="qnn", imgsz=640)(imgsz=224für die Klassifizierung), kopiere die resultierende Dateiyolo26n_qnn.onnxauf dein Snapdragon-Gerät und führeyolo predict model=yolo26n_qnn.onnx source=image.jpg(oderyolo val) aus. Ultralytics lädt die Kontextbinärdatei über den QNN Execution Provider von ONNX Runtime und führt sie auf der Hexagon NPU aus – siehe Exportierte YOLO-QNN-Modelle bereitstellen.QNN (Qualcomm AI Engine Direct, Teil des QAIRT SDK) ist Qualcomms aktuelle Inferenzplattform und der empfohlene Ersatz für das ältere Snapdragon Neural Processing Engine (SNPE) SDK. Neue Bereitstellungen sollten auf QNN setzen.
Ja, auf einem Qualcomm-Snapdragon-Gerät, auf dem
onnxruntime-qnninstalliert ist –YOLO("yolo26n_qnn.onnx")lädt die Kontextbinärdatei über den QNN Execution Provider und führtpredict/valwie jedes andere Format aus. Auf einem x86-Host ohne QNN-Hardware kann das Modell nicht ausgeführt werden, da die Kontextbinärdatei auf die Snapdragon-NPU ausgelegt ist.Der Export erstellt eine eigenständige ONNX-Datei mit Kontextbinärdatei (z. B.
yolo26n_qnn.onnx), in deren ONNXmetadata_propsKlassennamen, Bildgröße, Aufgabe und weitere Modellmetadaten eingebettet sind.