Monokulare Tiefenschätzung mit Ultralytics YOLO#
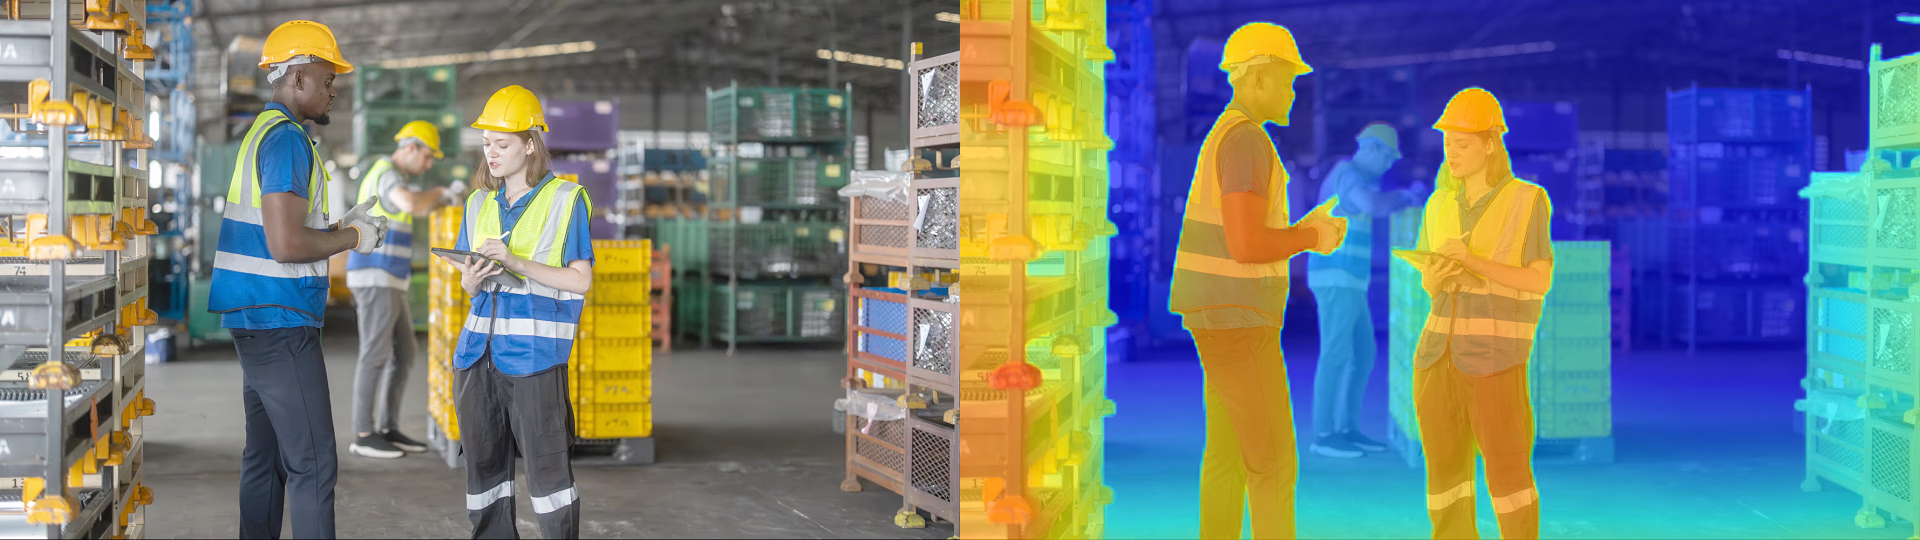
Bei der monokularen Tiefenschätzung wird aus einem einzelnen RGB-Bild eine Tiefenkarte für jedes Pixel vorhergesagt. Jeder Ausgabepixel enthält einen Tiefenwert in Metern, der die geschätzte Entfernung von der Kamera zu diesem Oberflächenpunkt angibt.
Die Ausgabe eines Tiefenmodells ist eine dichte Gleitkommakarte mit der Form (H, W), die am Eingabebild ausgerichtet ist. Dank dieser Darstellung für jedes Pixel eignet sich die monokulare Tiefenschätzung besonders für die 3D-Szenenrekonstruktion, die Navigation von Robotern, die Erstellung von AR/VR-Inhalten und alle Anwendungen, die aus einer einzelnen Kamera räumliche Anordnungen ableiten müssen.
Ansehen: Monokulare Tiefenschätzung mit Ultralytics YOLO26 | Python-Tutorial | Vision AI 🚀
Verwende task=depth oder die CLI-Aufgabe yolo depth für die monokulare Tiefenschätzung. YOLO26-Tiefenmodelle haben die Dateiendung -depth, zum Beispiel yolo26n-depth.pt.
Modelle#
YOLO26-Tiefenmodelle, die mit einer breiten Mischung verschiedener Datensätze vortrainiert wurden (Innen- und Außenbereiche, ~2.19M Bilder), sind unten aufgeführt. Die Metrikspalten beziehen sich auf den NYU Depth V2-Eigen-Testsplit.
Modelle werden bei der ersten Verwendung automatisch aus der neuesten Ultralytics-Version heruntergeladen.
| Modell | Größe (Pixel) | delta1NYU | abs_relNYU | rmseNYU | Geschwindigkeit CPU ONNX (ms) | Geschwindigkeit T4 TensorRT10 (ms) | Parameter (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU ist der Anteil der Pixel, bei denen die vorhergesagte Tiefe auf dem NYU Depth V2-Eigen-Testsplit (654 Bilder) um höchstens den Faktor 1.25 von der Referenztiefe abweicht, mit TTA bei mehreren Maßstäben und horizontaler Spiegelung sowie einer Anpassung nach der Methode der kleinsten Quadrate im Logarithmusraum.
- Die Genauigkeit bei einem einzelnen Maßstab ohne TTA lässt sich mit
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0reproduzieren (ersetze für jede Größemodel=). Dabei wird eine Anpassung anhand des Medians (nur Skalierung) verwendet und es werden niedrigere Werte erzielt: delta1 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel ist der mittlere absolute relative Fehler zwischen den vorhergesagten Tiefenwerten und den Referenzwerten.
- rmse ist der mittlere quadratische Fehler in Metern, ausgedrückt als Quadratwurzel.
- Geschwindigkeit ist die reine Inferenzlatenz (ohne Vor- und Nachverarbeitung) bei
imgsz=768,batch=1, angegeben als Mittelwert ± Standardabweichung der Messläufe nach dem Aufwärmen. CPU ONNX bezeichnet ONNX Runtime fp32 auf einem Intel Xeon mit 32 Kernen (Skylake); T4 TensorRT10 bezeichnet TensorRT fp16 auf einer Tesla T4. - params und FLOPs werden bei 768×768 gemessen, der Trainingsauflösung der veröffentlichten Gewichte.
Sieh dir die unveröffentlichte YOLO27-Vorschau mit vorläufigen Ergebnissen auf NYU Depth V2 an.
Geschwindigkeit im Vergleich zu Depth Anything V2#
Depth Anything V2 ist eine weit verbreitete offene Baseline für die monokulare Tiefenschätzung. Der DINOv2-Vision Transformer-Backbone und der DPT-Decoder benötigen viele Rechenressourcen. Deshalb ist das kleinste veröffentlichte Depth Anything V2-Modell auf derselben Tesla T4 mit TensorRT fp16 langsamer als jedes YOLO26-Tiefenmodell – einschließlich YOLO26x-depth, das mehr als doppelt so viele Parameter hat.
Bei ~768 px – imgsz=768 für YOLO26, der Auflösung, mit der die veröffentlichten Gewichte trainiert wurden, und 770 px für Depth Anything V2, dessen DINOv2-Backbone ein Vielfaches seiner Patchgröße von 14 erfordert:
| Modell | Parameter (M) | FLOPs (B) | T4 TensorRT10 (ms) | FPS | Geschwindigkeitssteigerung gegenüber V2 Small | Geschwindigkeitssteigerung gegenüber V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
Bei ~640 px – imgsz=640 beziehungsweise 644 px – bleibt die Reihenfolge unverändert, und YOLO26n-depth ist 5.9× schneller als Depth Anything V2 Small:
| Modell | T4 TensorRT10 (ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- Die Latenz umfasst nur die Inferenz,
batch=1, TensorRT fp16 auf einer Tesla T4 – mit demselben Testaufbau wie in der obigen Modelltabelle, hier auf zwei Dezimalstellen gerundet. FPS ist der Kehrwert der ungerundeten Latenz. Für die Spalten Geschwindigkeitssteigerung wird die Latenz von Depth Anything V2 Small (20.99 ms) und Base (55.40 ms) durch die YOLO26-Latenz geteilt. - Depth Anything V2 Small und Base sind die veröffentlichten ViT-S- und ViT-B-Checkpoints.
- Der Vergleich umfasst ausschließlich die Latenz – die Genauigkeit der beiden Modellfamilien wird hier nicht anhand eines gemeinsamen Bewertungsprotokolls verglichen.
Tiefenbereich und der Tiefenkopf mit Logarithmusdarstellung#
Der Tiefenkopf sagt exp(logit) vorher – ohne Obergrenze (~0.02–150 m) – und entkoppelt die Szenenform von der absoluten Skalierung: Das Netzwerk sagt ein relatives Tiefenfeld im Logarithmusraum vorher; die absoluten Meterwerte werden durch eine separate Transformation mit zwei Parametern (exp(a·log d + b)) festgelegt, die bei der Auswertung, durch eine einfache Kalibrierung oder durch Fine-Tuning ermittelt wird. Die gängige Alternative, ein begrenzter sigmoid × max_depth-Kopf, verankert stattdessen eine feste Obergrenze in der Architektur, sodass jede Tiefe über max_depth abgeschnitten wird – dadurch ist das Training mit Szenen größerer Reichweite ebenso unmöglich wie deren Vorhersage.
Kontrollierter A/B-Vergleich – dieselben Daten, derselbe Zeitplan, nur der Kopf unterscheidet sich. Beide Köpfe werden von Grund auf mit derselben Mischung aus Innenbereichsdaten (≤10 m) und Außenbereichsdaten (≤80 m) trainiert:
| Kopf | Ausgabebereich | δ1 auf gemischtem Validierungsdatensatz | Trainingsverhalten |
|---|---|---|---|
sigmoid × max_depth (10 m) | begrenzt auf 0–10 m | 0.221 | stagniert ab Epoche 1 |
log (ohne Obergrenze) | 0–~150 m | 0.367 (+66%) | verbessert sich während des gesamten Trainings |
Der begrenzte Kopf kann den Großteil der Außenbereichspixel in einer Entfernung von mehr als 10 m nicht darstellen und macht deshalb fast sofort keine Fortschritte mehr; der log-Kopf lernt über den gesamten Tiefenbereich hinweg.
Das behobene Fehlverhalten – Fine-Tuning mit einem einzelnen Datensatz, aufgeschlüsselt nach Reichweite. Das Fine-Tuning eines begrenzten (10 m) Kopfs mit einzelnen Datensätzen funktioniert, wenn die Daten innerhalb der Obergrenze liegen, und bricht ein, wenn die Obergrenze überschritten wird:
| Datensatz | Tiefenbereich | δ1 des begrenzten Kopfs |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | größtenteils ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 – die Abweichung im Maßstab beträgt 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
Der Einbruch tritt genau an der Grenze der Obergrenze auf. Der log-Kopf hat keine solche Grenze.
Veröffentlichte Modelle – Leistung über verschiedene Tiefenbereiche hinweg. Die veröffentlichte Modellfamilie mit log-Kopf wurde anhand von Benchmarks mit einer Reichweite von 10 m (NYU, iBims-1) bis 80 m (KITTI) ausgewertet. Angegeben ist δ1 mit angepasster Skalierung:
| Benchmark | Bereich | YOLO26x-depth (log) | frühere Veröffentlichung mit begrenztem Bereich |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Mittelwert | — | 0.819 | 0.799 |
Beide Spalten entsprechen den veröffentlichten Werten. Die übrigen Zeilen wurden mit dem auf den jeweiligen Datensatzseiten beschriebenen TTA-Protokoll und der Methode der kleinsten Quadrate im Logarithmusraum ausgewertet. Der Validator in diesem Repository unterstützt dieses Protokoll nicht, daher lässt sich die KITTI-Zeile nicht unter denselben Bedingungen erneut messen. Auf der KITTI-Seite stehen stattdessen Werte, die anhand des kanonischen Eigen-Splits mit 652 Bildern gemessen wurden.
Die größten Verbesserungen zeigen sich bei den Outdoor-Benchmarks mit größerer Reichweite (KITTI, ETH3D) – genau dort, wo eine feste Obergrenze von 10 m am stärksten einschränkt – und die Leistung im Innenbereich bleibt erhalten.
Trainieren#
Trainiere YOLO26n-depth 100 Epochen lang mit einer Bildgröße von 640 auf dem Datensatz Depth8. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite Konfiguration.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-depth.yaml")  # ein neues Modell aus YAML erstellen
model = YOLO("yolo26n-depth.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # aus YAML erstellen und Gewichte übertragen

# Das Modell trainieren
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Ausführliche Informationen zum Modus train findest du auf der Seite Trainieren. Tiefenmodelle lassen sich auch mit dem Cloud-Training der Ultralytics Platform trainieren.
Datensatzformat#
Datensätze zur Tiefenschätzung enthalten zu jedem RGB-Bild eine skalierte Tiefenkarte als uint16-PNG oder Gleitkomma-NPY in Metern. PNG-Werte werden standardmäßig in Millimetern angegeben; bei Datensätzen mit einer anderen Konvention muss in der YAML-Datei depth_scale gesetzt werden. Der Loader leitet den Pfad zur Tiefenkarte ab, indem er die Komponente images durch depth ersetzt. Dabei wird .png bevorzugt und andernfalls auf .npy zurückgegriffen.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Ein Bild unter images/train/scene_001.jpg wird beispielsweise mit einer Tiefenkarte unter depth/train/scene_001.png verknüpft. Die vollständige Formatspezifikation findest du im Leitfaden zu Datensätzen für die Tiefenschätzung.
Fine-Tuning mit eigenen Daten#
Wenn du ein vortrainiertes Tiefenmodell an einen benutzerdefinierten Datensatz anpasst, verringere die Lernrate und verwende den AdamW-Optimierer. Die Standardeinstellungen des Optimierers sind auf das Training von Grund auf abgestimmt. Bei einem bereits konvergierten Tiefenmodell können sie das vortrainierte Wissen überschreiben und die Ergebnisse verschlechtern – insbesondere beim Fine-Tuning mit nur einem Datendomäne.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # Mit vortrainierten Gewichten beginnen

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100-mal niedriger als der Standardwert für Training von Grund auf
    warmup_bias_lr=1e-4,  # Auch das Aufwärmen behutsam gestalten
)
Zusätzliche Tipps:
- Die Augmentierung wird über die Standardargumente gesteuert (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v); die geometrische Verzerrung und die Spiegelungen werden identisch auf die zugehörige Tiefenkarte angewendet. Um das genaue Rezept für die veröffentlichten YOLO26-Depth-Gewichte zu sehen, prüfe die im Checkpoint gespeichertentrain_args– siehe Trainingsargumente eines YOLO26-Checkpoints untersuchen. mosaic,mixup,cutmixundcopy_pastesind für Tiefendaten nicht implementiert. Der Tiefendatenlader setzt diese Wahrscheinlichkeiten automatisch auf 0, daher haben diese Argumente keine Wirkung. Diese Augmentierungen werden nicht unterstützt, weil sie mehrere Bilder kombinieren und dadurch ungültige zugehörige Tiefenkarten entstehen würden.- Jeder Tiefenbereich funktioniert sofort. Die
log-Kopfmodelle sagen unbegrenzte Tiefenwerte voraus und passen sich daher ohne Änderungen an Daten mit kurzer Reichweite (Makro) oder großer Reichweite (Außenbereich/Fahren) an. Wenn dumax_depth:in deiner Dataset-YAML-Datei (in Metern) festlegst, werden die GT-Pixel begrenzt, die in die Validierungsmetriken einfließen. - Allgemeine Leistungsfähigkeit erhalten. Wenn das Modell auch in Szenen außerhalb deiner Trainingsdaten genau bleiben soll, mische einen kleinen Anteil (~5–10 %) vielfältiger, universell einsetzbarer Bilder in deine Trainingsdaten. Das verringert den beim Fine-Tuning auftretenden Verlust zuvor gelernter Fähigkeiten erheblich.
- Nur dann von Grund auf trainieren (
model=yolo26s-depth.yaml), wenn sich deine Domäne stark unterscheidet und du über einen großen Datensatz verfügst – in diesem Fall ist der Standardwertoptimizer=autoangemessen, da keine vortrainierten Gewichte erhalten werden müssen.
Tiefenskala kalibrieren#
Der Tiefenkopf trennt Form (relative Szenenstruktur) von Skala (absolute Meterwerte). Wenn ein Modell für deine Szenen bereits gute relative Tiefenwerte liefert, aber die absoluten Werte für deine Kamera nicht stimmen, kannst du die Skala in Sekunden mit model.calibrate() korrigieren – dabei wird die logarithmisch-affine Transformation des Kopfes geschlossen und ausschließlich hinsichtlich der Skala an einer kleinen beschrifteten Stichprobe angepasst. Das Ergebnis wird nur übernommen, wenn es das kreuzvalidierte δ1 auf zurückgehaltenen Daten verbessert. Es gibt weder Gradienten-Training noch Änderungen an den Netzwerkgewichten, sodass die relative Struktur nicht beeinträchtigt werden kann.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Skala anhand einer beschrifteten Teilmenge anpassen (~100 oder mehr Bilder genügen) und das Ergebnis anschließend speichern
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
Für die Kalibrierung werden Tiefenwerte als Referenz benötigt. Daher läuft sie auf einer beschrifteten Teilmenge und kann nicht bei einer Inferenz ohne Referenzdaten durchgeführt werden. Angepasst und bewertet werden dieselben Pixel, die auch in die Validierungsmetriken eingehen: GT-Werte, die den Wert max_depth aus der Dataset-YAML-Datei (standardmäßig 100 m) erreichen oder überschreiten, werden ausgeschlossen. Nutze die Kalibrierung, wenn die relative Tiefe bereits gut ist und nur die Skala oder Reichweite nicht stimmt. Wenn sich die relative Struktur für deine Domäne ändern muss, solltest du stattdessen ein Fine-Tuning durchführen.
Das Training erledigt das automatisch für dich: Nach Abschluss von model.train(...) werden die besten und die letzten Checkpoints anhand des Validierungssatzes kalibriert, sodass sie sofort Tiefenwerte in metrischer Skala ausgeben.
Die veröffentlichten yolo26*-depth.pt-Checkpoints enthalten diese Kalibrierung bereits. Sie wurde anhand der Validierungsdatenmischung des Vortrainings angepasst. Da es sich um eine einzige globale Skala für alle Domänen handelt, solltest du für die genauesten absoluten Tiefenwerte mit einer bestimmten Kamera oder in einem bestimmten Szenentyp model.calibrate() anhand einer kleinen beschrifteten Teilmenge deiner eigenen Daten ausführen. Damit wird die bereits enthaltene Anpassung ersetzt.
Ground-Truth-Tiefe ohne Tiefenkamera ermitteln#
Wenn deine Kamera keinen Tiefensensor hat, kannst du sie trotzdem dafür kalibrieren. Bei der Kalibrierung wird ein globaler Skalierungsfaktor angepasst und Pixel mit dem Tiefenwert 0 werden ignoriert. Daher genügen einige wenige Messpunkte pro Bild.
-
Bilder aufnehmen. Nimm 50 bis 150 Bilder mit der Auflösung und den Objektiveinstellungen auf, die du später verwenden möchtest, und lege sie in
dataset/images/val/ab. Die Kalibrierung liest den Splitvalein. -
Tiefe annotieren. Verwende eine der beiden folgenden Methoden. Beide schreiben für jedes Bild eine Tiefenkarte nach
dataset/depth/val/, und zwar im Datensatzformat.
Miss mit einem Laser-Entfernungsmesser oder Maßband die Entfernung zu einigen Punkten in jedem Bild. Wähle dafür ebene Flächen abseits von Objektkanten und notiere die Pixelposition jedes Punktes in points.csv:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
Schreibe anschließend die Tiefenkarten und belasse alle nicht gemessenen Pixel auf 0. Jeder Punkt wird als kleiner Punkt eingezeichnet, damit er die Größenänderung auf imgsz übersteht:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Ein Entfernungsmesser misst die direkte Entfernung zu einem Punkt, während Tiefenkarten die Entfernung entlang der Blickrichtung der Kamera speichern. In der Bildmitte stimmen beide Werte überein; bei einem Winkel von 15° zur Mitte weichen sie um etwa 3,5 % voneinander ab. Miss daher Punkte nahe der Bildmitte oder rechne jeden Messwert mit meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) und den Kameraintrinsiken um.
-
Schreibe die YAML-Datei des Datensatzes als
calib.yaml.depth_scale: 100liest die Zentimeter-PNGs aus den gemessenen Punkten ein und wird bei NPY-Karten ignoriert:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Kalibriere und speichere und lade anschließend
yolo26s-depth-calibrated.ptfür die Vorhersage oder den Export:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
In Tests mit yolo26s-depth.pt und 150 Bildern pro Kamera wich die veröffentlichte Kalibrierung bei NYU, KITTI und einer Kamera mit engem Bildwinkel um 4 % bis 46 % von der Skalierungsanpassung anhand vollständiger Ground-Truth-Daten ab. Eine Kalibrierung mit 5 gemessenen Punkten pro Bild lag höchstens 1 % von dieser Anpassung entfernt, mit DA3METRIC-LARGE-Annotationen höchstens 7 %. Mehr Bilder bringen mehr als mehr Punkte pro Bild: 150 Bilder mit jeweils 1 Punkt lagen etwa 3 % daneben, während 20 Bilder mit jeweils 5 Punkten um bis zu 9 % abwichen.
Validieren#
Überprüfe die Genauigkeit eines trainierten YOLO26n-depth-Modells auf einem Datensatz zur Tiefenschätzung. Übergib data ausdrücklich, damit die Validierung die vorgesehene YAML-Datei des Datensatzes verwendet. Die veröffentlichten Gewichte wurden mit imgsz=768 auf Bilder trainiert, die auf ein Quadrat gestreckt wurden, statt durch Padding in ein Letterbox-Format eingepasst zu werden. Validiere und führe Vorhersagen daher mit dieser Größe aus, um die beste Genauigkeit zu erzielen. Vorhersage, Validierung und model.calibrate() strecken die Eingabe auf dieselbe Weise.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-depth.pt")  # Ein offizielles Modell laden
model = YOLO("path/to/best.pt")  # Ein benutzerdefiniertes Modell laden

# Das Modell validieren
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # Anteil der Pixel innerhalb des Grenzwerts δ=1.25
metrics.abs_rel  # Mittlerer absoluter relativer Fehler
metrics.rmse  # Wurzel des mittleren quadratischen Fehlers (Meter)
metrics.silog # Skaleninvarianter logarithmischer FehlerVorhersagen#
Nutze ein trainiertes YOLO26n-depth-Modell, um Vorhersagen für Bilder auszuführen.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-depth.pt")  # Ein offizielles Modell laden
model = YOLO("path/to/best.pt")  # Ein benutzerdefiniertes Modell laden

# Mit dem Modell Vorhersagen erstellen
results = model("https://ultralytics.com/images/bus.jpg")  # Eine Vorhersage für ein Bild erstellen

# Auf die Ergebnisse zugreifen
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, Form (H, W), Meter
Ausführliche Informationen zum Modus predict findest du auf der Seite Vorhersagen.
Ausgabe der Ergebnisse#
Die YOLO-Tiefenschätzung gibt für jedes Bild ein Results-Objekt zurück. Jedes Ergebnis enthält eine dichte Tiefenkarte mit Gleitkommawerten für das gesamte Bild.
| Attribut | Typ | Form | Beschreibung |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Dichte Tiefenkarte mit Werten pro Pixel. |
result.depth.data | torch.Tensor | (H,W) | Tiefenwerte in Metern; rufe .cpu().numpy() für NumPy auf. |
result.boxes | - | - | Keine Instanzboxen. |
result.masks | - | - | Keine Instanzmasken. |
Task-spezifische Results-Felder für alle Aufgaben findest du im Abschnitt Vorhersageergebnisse nach Aufgabe.
Tiefe pro Objekt bei Instanzsegmentierung#
Kombiniere Instanzsegmentierung mit Tiefeninformationen, um abzuschätzen, wie weit jedes erkannte Objekt entfernt ist. Führe beide Modelle mit retina_masks=True auf demselben Bild aus, damit die Masken dieselbe Auflösung wie die Tiefenkarte des Originalbilds haben. Nimm dann den Median der gültigen Tiefenpixel innerhalb jeder Maske.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
Der Median ist robust gegenüber Hintergrundpixeln an den Maskenrändern, beschreibt jedoch die sichtbare Oberfläche des Objekts und nicht dessen Mittelpunkt. Seine Genauigkeit hängt von der Tiefenskala des Modells ab (siehe Tiefenskala kalibrieren).
Tiefenkarte einfärben#
Die unverarbeitete Tiefenkarte ist ein einkanaliges Array mit Gleitkommawerten in Metern – nützlich für Berechnungen, aber direkt schwer lesbar. Verwende zum Erstellen eines Farbbilds den Helfer colorize_depth aus ultralytics.utils.plotting. Er bildet das Tiefenarray (H, W) auf ein (H, W, 3)-BGR-uint8-Bild ab (ungültige Pixel <= 0 werden schwarz dargestellt).
result.plot() legt diese Einfärbung bereits mit den Standardwerten (cmap="jet", mode="disparity") über das Eingabebild. Rufe colorize_depth direkt auf, wenn du ein eigenständiges eingefärbtes Tiefenbild oder eine andere Farbkarte beziehungsweise Normalisierung benötigst.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Mit nahen Bereichen in warmen Farben einfärben und speichern
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Den Bereich auf 0–20 m festlegen, damit dieselbe Farbe in allen Einzelbildern dieselbe Entfernung bezeichnet
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Überlagerung direkt aus dem Results-Objekt erstellen (verwendet cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Alle Farbkarten verlaufen von kühl/dunkel zu warm/hell. Mit mode legst du fest, welches Ende für nahe Bereiche steht, und vmin/vmax fixieren den Bereich über alle Einzelbilder hinweg, damit dieselbe Farbe immer dieselbe Entfernung bezeichnet.
| Argument | Wert | Beschreibung |
|---|---|---|
cmap | jet (Standard) | Hoher Kontrast mit Blau → Grün → Rot; diese Farbpalette verwendet result.plot(). |
cmap | inferno | Schwarz → Violett → Orange → Gelb. Wahrnehmungspsychologisch gleichmäßig, farbenblindfreundlich und in Graustufen gut lesbar. |
cmap | spectral | Rot → Gelb → Grün → Blau (Spectral_r in Matplotlib). |
mode | disparity (Standard) | Normalisiert die inverse Tiefe (1/d) zwischen dem 2. und 98. Perzentil. Warme Farben kennzeichnen nahe Bereiche; Ausreißer in großer Entfernung werden abgeschnitten. |
mode | metric | Normalisiert die Tiefe in Metern linear zwischen vmin und vmax. Warme Farben kennzeichnen große Entfernungen, sodass die Farben die tatsächliche Entfernung wiedergeben. |
Exportieren#
Ein YOLO26n-depth-Modell in ein anderes Format wie ONNX oder CoreML exportieren
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-depth.pt")  # Ein offizielles Modell laden
model = YOLO("path/to/best.pt")  # Ein benutzerdefiniertes Modell laden

# Modell exportieren
model.export(format="onnx")
Die verfügbaren Exportformate für die YOLO26-Tiefenschätzung sind in der Tabelle unten aufgeführt. Du kannst mit dem Argument format in jedes Format exportieren, also zum Beispiel mit format='onnx' oder format='engine'. Vorhersagen und Validierungen kannst du direkt mit exportierten Modellen ausführen, zum Beispiel mit yolo predict model=yolo26n-depth.onnx. Nach Abschluss des Exports werden Nutzungsbeispiele für dein Modell angezeigt.
| Format | Argument format | Modell | Metadaten | Argumente |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None gibt standardmäßig Rohdaten für die externe NMS aus. Lege nms=False fest, um einen verfügbaren Kopf ohne NMS auszuwählen; nicht unterstützte Formate greifen auf ihren nativen Ausgabepfad zurück. Die obigen Einträge nms kennzeichnen Formate, die NMS mit nms=True integrieren können.
Ausführliche Informationen zu export findest du auf der Seite Export.
Häufig gestellte Fragen#
Bereite zusammengehörige RGB-Bilder und entweder 16-Bit-Tiefenbilder im PNG-Format oder Tiefenkarten mit Gleitkommawerten im NPY-Format in Metern vor. Erstelle dann eine Dataset-YAML-Datei, die auf dein Verzeichnis
images/verweist. Der Lader findet die Tiefendateien automatisch, indem er im Pfadimagesdurchdepthersetzt. Dabei wird.pngbevorzugt und andernfalls auf.npyzurückgegriffen.Beginne mit vortrainierten Gewichten und verwende eine niedrige Lernrate mit AdamW, damit das Fine-Tuning das bereits vorhandene Wissen des Modells bewahrt (siehe Fine-Tuning mit eigenen Daten).
Beispielfrom ultralytics import YOLO # Ein vortrainiertes YOLO26-Tiefenmodell laden model = YOLO("yolo26s-depth.pt") # Ein eigenes Tiefendatenset für das Fine-Tuning verwenden results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Auf der Seite Konfiguration findest du weitere verfügbare Argumente.
Bei der Validierung der Tiefenschätzung wird der Metriksatz ausgegeben, der auch bei Depth Anything und verwandten Arbeiten zur monokularen Tiefenschätzung verwendet wird:
- delta1 / delta2 / delta3 — Anteil der Pixel, bei denen das Verhältnis zwischen vorhergesagter und tatsächlicher Tiefe (oder dessen Kehrwert) unter 1.25, 1.25² beziehungsweise 1.25³ liegt. Höher ist besser.
- abs_rel — mittlerer absoluter relativer Fehler. Niedriger ist besser.
- rmse — Wurzel des mittleren quadratischen Fehlers in Metern. Niedriger ist besser.
- silog — skaleninvarianter logarithmischer Fehler. Niedriger ist besser.
Jede Vorhersage wird für jedes Bild anhand der tatsächlichen Tiefe medianangepasst. Jede Metrik wird für dieses Bild abschließend berechnet, und anschließend wird der Mittelwert dieser Ergebnisse pro Bild über den Validierungssatz gebildet. Dadurch zählt jedes Bild gleich viel, unabhängig davon, wie viele gültige Tiefenpixel es enthält. Bilder mit weniger als 10 gültigen Pixeln mit tatsächlichen Tiefenwerten werden übersprungen und nicht in diesen Mittelwert einbezogen, da der Median einer Handvoll Pixel keine sinnvolle Ausrichtung ermöglicht. Nicht endliche Vorhersagen werden stattdessen anhand der Tiefengrenzen bewertet. Dies entspricht der Mittelwertbildung pro Stichprobe und der Mindestzahl von 10 Pixeln, die auch bei Depth Anything V2 verwendet werden.
Die Tiefenkarte wird als
torch.Tensormit der Form(H, W)gespeichert. Jeder Wert entspricht der vorhergesagten Tiefe in Metern (verwenderesult.depth.data.cpu().numpy()für ein NumPy-Array vom Typfloat32). Greife nach der Vorhersage überresult.depth.datadarauf zu. Die Karte entspricht der Auflösung des Eingabebilds.Ultralytics YOLO26 bietet integrierte Dataset-YAML-Konfigurationen für mehrere Datensätze zur Tiefenschätzung, darunter NYU Depth V2, KITTI, Hypersim, SUN RGB-D und ARKitScenes. Eine vollständige Liste und Einzelheiten zu den Formaten findest du im Leitfaden zu Datensätzen für die Tiefenschätzung.
Validiere ein vortrainiertes YOLO26-Tiefenmodell, indem du die Dataset-YAML-Datei für die Auswertung angibst:
Beispielfrom ultralytics import YOLO # Vortrainiertes Modell laden model = YOLO("yolo26n-depth.pt") # Das Modell validieren metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Exportiere ein YOLO26-Tiefenmodell mit Python oder CLI nach ONNX:
Beispielfrom ultralytics import YOLO # Vortrainiertes Modell laden model = YOLO("yolo26n-depth.pt") # Exportiere das Modell in das ONNX-Format model.export(format="onnx")Weitere Informationen zum Export in verschiedene Formate findest du auf der Seite Export.