Semantische Segmentierung mit Ultralytics YOLO#
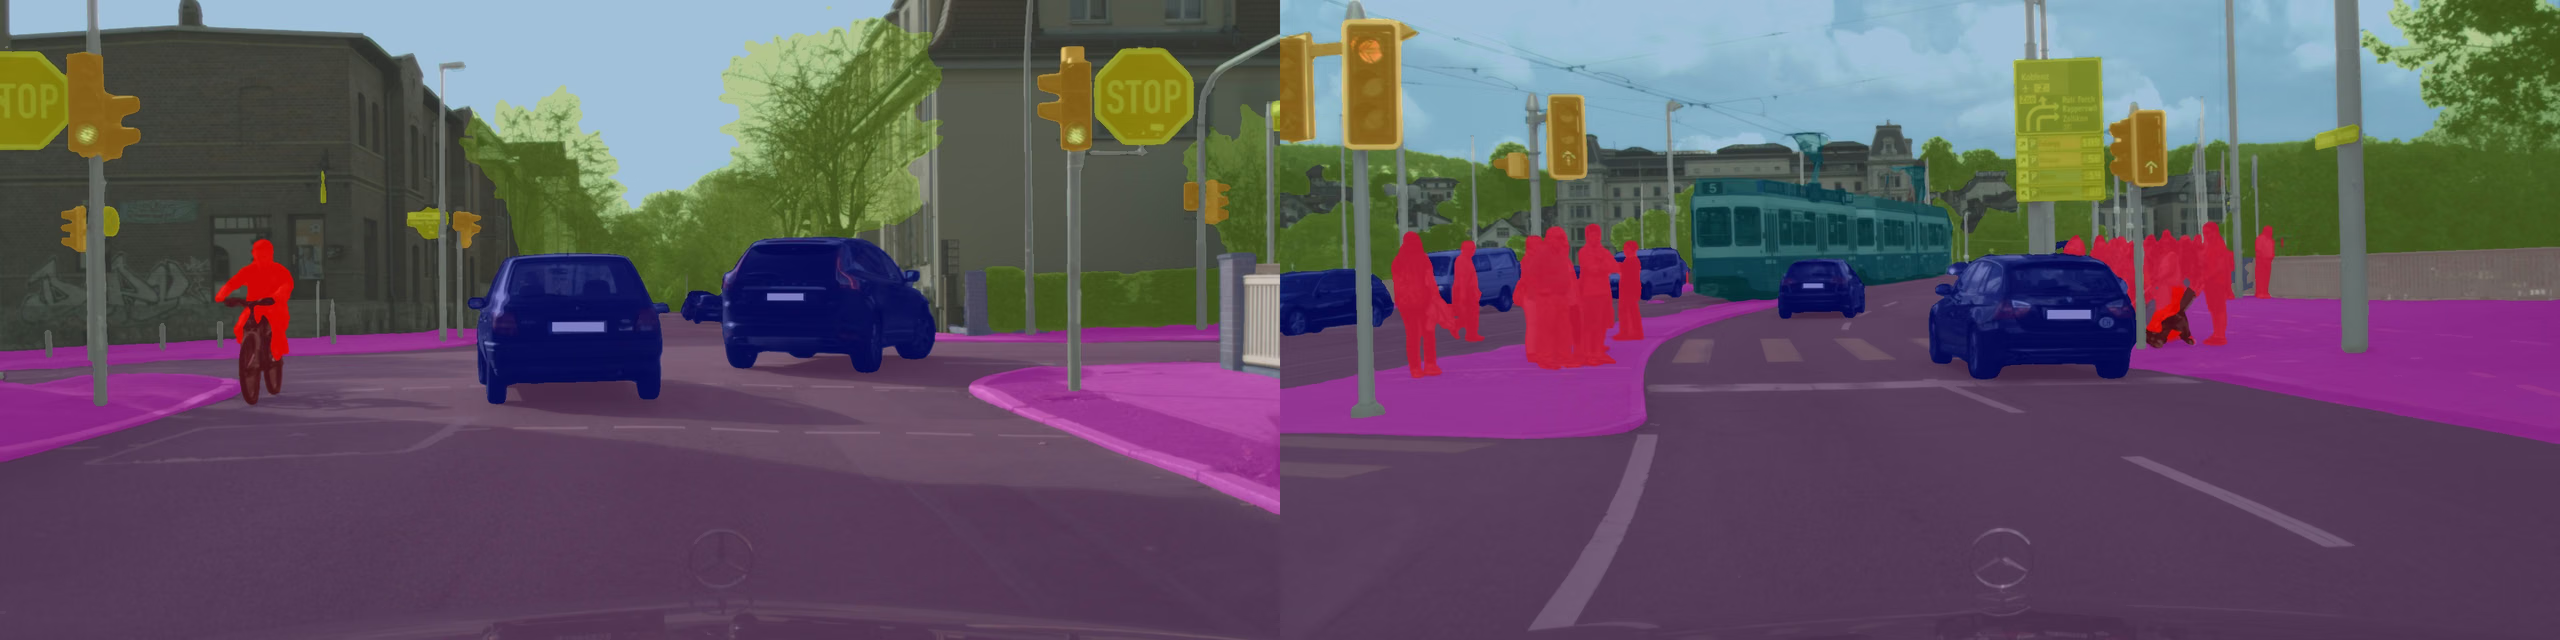
Die semantische Segmentierung weist jedem Pixel in einem Bild eine Klassenbezeichnung zu und erzeugt so eine dichte Klassenkarte, die die gesamte Szene abdeckt. Anders als bei der Instanzsegmentierung, bei der einzelne Objekte voneinander getrennt werden, fasst die semantische Segmentierung alle Pixel derselben Klasse zusammen, unabhängig davon, wie viele einzelne Objekte vorhanden sind.
Ansehen: Semantische Segmentierung mit Ultralytics YOLO26 | Schnellstart-Tutorial
Die Ausgabe eines Modells für semantische Segmentierung ist eine einzelne Klassenkarte mit Höhe und Breite des Bildes, bei der jeder Pixelwert einer vorhergesagten Klassen-ID entspricht. Dadurch eignet sich die semantische Segmentierung ideal für die Szenenanalyse, etwa beim autonomen Fahren, in der medizinischen Bildgebung und bei der Kartierung der Landbedeckung.
Verwende task=semantic oder die CLI-Aufgabe yolo semantic für die semantische Segmentierung. Die Dateien von YOLO26-Modellen für semantische Segmentierung verwenden das Suffix -sem, zum Beispiel yolo26n-sem.pt.
Modelle#
Unten sind semantische YOLO26-Modelle aufgeführt, die auf dem Cityscapes-Datensatz vortrainiert wurden.
Modelle werden bei der ersten Verwendung automatisch aus der neuesten Ultralytics-Version heruntergeladen.
| Modell | Größe (Pixel) | mIoUval | Geschwindigkeit RTX3090 PyTorch (ms) | Parameter (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- Die mIoUval-Werte gelten für ein einzelnes Modell mit einer einzelnen Skalierung auf dem Validierungssatz von Cityscapes.
Reproduziere die Ergebnisse mityolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - Die Geschwindigkeitsmetriken sind Mittelwerte über die Validierungsbilder von Cityscapes und wurden mit einer RTX3090-Instanz ermittelt.
Reproduziere die Ergebnisse mityolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - Die Werte für Parameter und FLOPs gelten für das fusionierte Modell nach
model.fuse(), wodurch Conv- und BatchNorm-Schichten zusammengeführt werden. Vortrainierte Checkpoints behalten die vollständige Trainingsarchitektur bei und können daher höhere Werte aufweisen.
Unten sind semantische YOLO26-Modelle aufgeführt, die auf dem ADE20K-Datensatz vortrainiert wurden.
| Modell | Größe (Pixel) | mIoUval | Geschwindigkeit RTX3090 PyTorch (ms) | Parameter (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- Die mIoUval-Werte gelten für ein einzelnes Modell mit einer einzelnen Skalierung auf dem Validierungssatz von ADE20K.
Reproduziere die Ergebnisse mityolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640und ersetze dabeiyolo26n-sem-ade20k.ptdurch den gewünschtenyolo26*-sem-ade20k.pt-Checkpoint. - Die Geschwindigkeitsmetriken sind Mittelwerte über die Validierungsbilder von ADE20K und wurden mit einer RTX3090-Instanz ermittelt.
Reproduziere die Ergebnisse mityolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640und ersetze dabeiyolo26n-sem-ade20k.ptdurch den gewünschtenyolo26*-sem-ade20k.pt-Checkpoint. - Die Werte für Parameter und FLOPs gelten für das fusionierte Modell nach
model.fuse(), wodurch Conv- und BatchNorm-Schichten zusammengeführt werden. Vortrainierte Checkpoints behalten die vollständige Trainingsarchitektur bei und können daher höhere Werte aufweisen.
Vorläufige mIoU-Ergebnisse für Cityscapes findest du in der unveröffentlichten YOLO27-Vorschau.
Trainieren#
Trainiere YOLO26n-sem 100 Epochen lang mit einer Bildgröße von 1024 auf dem Datensatz Cityscapes8. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite Konfiguration.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-sem.yaml")  # ein neues Modell aus YAML erstellen
model = YOLO("yolo26n-sem.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # aus YAML erstellen und Gewichte übertragen

# Das Modell trainieren
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Die vollständigen Details zum Modus train findest du auf der Seite Trainieren. Modelle für semantische Segmentierung lassen sich auch mit dem Cloud-Training der Ultralytics Platform trainieren.
Datensatzformat#
Datensätze für semantische Segmentierung verwenden Einkanal-Maskenbilder, typischerweise im PNG-Format, in denen jeder Pixelwert eine Klassen-ID darstellt. Pixel mit dem Wert 255 werden als „ignorieren“ behandelt und bei der Berechnung des Verlusts ausgeschlossen. In der YAML-Datei des Datensatzes sollten die Pfade zu den Bildern und den zugehörigen Maskenverzeichnissen angegeben sein. Datensätze mit YOLO-Polygonbeschriftungen können direkt zum Training verwendet werden; die Umwandlung in Masken erfolgt während der Ausführung (siehe unten Kann ich Daten zur Instanzsegmentierung verwenden). Details zum Format findest du im Leitfaden zu Datensätzen für semantische Segmentierung. Zu den unterstützten Datensätzen gehören Cityscapes und ADE20K. Mit der Annotation in der Ultralytics Platform kannst du semantische Datensätze verwalten und beschriften.
Validieren#
Validiere die Genauigkeit des trainierten Modells YOLO26n-sem auf einem Datensatz zur semantischen Segmentierung. Gib data ausdrücklich an, damit bei der Validierung die vorgesehene YAML-Datei des Datensatzes verwendet wird.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-sem.pt")  # Ein offizielles Modell laden
model = YOLO("path/to/best.pt")  # Ein benutzerdefiniertes Modell laden

# Das Modell validieren
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # mittlere Schnittmenge über Vereinigungsmenge
metrics.pixel_accuracy # Gesamtgenauigkeit auf PixelebeneVorhersagen#
Verwende ein trainiertes YOLO26n-sem-Modell, um Vorhersagen für Bilder zu erstellen.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-sem.pt")  # Ein offizielles Modell laden
model = YOLO("path/to/best.pt")  # Ein benutzerdefiniertes Modell laden

# Mit dem Modell Vorhersagen erstellen
results = model("https://ultralytics.com/images/bus.jpg")  # Eine Vorhersage für ein Bild erstellen

# Auf die Ergebnisse zugreifen
for result in results:
    semantic_mask = result.semantic_mask.data  # Klassenkarte, Form (H,W), ganzzahliger Datentyp entsprechend der Anzahl der Klassen
Ausführliche Informationen zum Modus predict findest du auf der Seite Vorhersagen.
Ausgabe der Ergebnisse#
Die semantische YOLO-Segmentierung gibt für jedes Bild ein Results-Objekt zurück. Jedes Ergebnis enthält eine einzelne dichte Klassenkarte für das gesamte Bild statt einer Liste von Objektmasken. Pixel mit derselben vorhergesagten Klasse haben dieselbe Klassen-ID, selbst wenn sie zu unterschiedlichen Objekten gehören.
| Attribut | Typ | Form | Beschreibung |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Dichte Klassenkarte. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | Klassen-IDs; der Datentyp wird anhand der Anzahl der Klassen ausgewählt. |
result.masks | - | - | Keine Instanzmasken. |
result.boxes | - | - | Keine Instanzboxen/Konfidenzwerte. |
Task-spezifische Results-Felder für alle Aufgaben findest du im Abschnitt Vorhersageergebnisse nach Aufgabe.
Bei der semantischen Segmentierung wird eine dichte Klassenkarte vorhergesagt und anschließend für die Darstellung und Weiterverarbeitung wieder auf die Bildgröße gebracht. Sehr dünne Strukturen wie Fahrbahnmarkierungen, Spielfeldlinien, Masten oder Drähte können dadurch stufig wirken, wenn die Inferenz mit einer deutlich geringeren imgsz als der ursprünglichen Bildauflösung ausgeführt wird. Wenn die Ränder gezackt wirken, teste zunächst erneut das native PyTorch-Modell .pt mit einer größeren imgsz, etwa 1024, 1280 oder dem nächstliegenden praktikablen Wert zur Größe des Quellbilds. Verwende exportierte Modelle erst, nachdem du bestätigt hast, dass die Ausgabe .pt akzeptabel ist, da Eingaben mit geringerer Auflösung feine Details, die in der vorhergesagten Klassenkarte nicht enthalten waren, nicht wiederherstellen können.
Instanz- und semantische Segmentierung#
| Aspekt | Instanzsegmentierung (task="segment") | Semantische Segmentierung (task="semantic") |
|---|---|---|
| Ziel der Vorhersage | Jedes erkannte Objekt einzeln segmentieren | Jedem Pixel eine Klassen-ID zuweisen |
| Ausgabefeld | result.masks | result.semantic_mask |
| Hauptdaten | result.masks.data | result.semantic_mask.data |
| Form | (N,H,W) | (H,W) |
| Pixelwerte | Binärmaskenwerte: 0 oder 1 | Klassen-IDs: 0, 1, 2, ... |
| Datentyp | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Objekte derselben Klasse | Als getrennte Instanzen beibehalten | Zu einem Bereich derselben Klasse zusammengeführt |
| Polygone | Ja, über result.masks.xy und result.masks.xyn | Standardmäßig keine Polygon-Ausgabe |
| Boxen und Konfidenz | Ja, über result.boxes | Keine Boxen oder Konfidenzwerte pro Instanz |
| Typische Verwendung | Zählen, Verfolgen, Zuschneiden, Messen auf Objektebene | Dichte Szenenbeschriftung, befahrbare Bereiche, Landbedeckung, medizinische Bereiche |
Exportieren#
Exportiere ein YOLO26n-sem-Modell in ein anderes Format wie ONNX, CoreML usw.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-sem.pt")  # Ein offizielles Modell laden
model = YOLO("path/to/best.pt")  # Ein benutzerdefiniertes Modell laden

# Modell exportieren
model.export(format="onnx")
Die verfügbaren Exportformate für die semantische YOLO26-Segmentierung findest du in der Tabelle unten. Mit dem Argument format kannst du in jedes Format exportieren, also etwa format='onnx' oder format='engine'. Du kannst direkt mit exportierten Modellen Vorhersagen erstellen oder sie validieren, also yolo predict model=yolo26n-sem.onnx. Nach Abschluss des Exports werden Anwendungsbeispiele für dein Modell angezeigt.
| Format | Argument format | Modell | Metadaten | Argumente |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-sem_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None gibt standardmäßig Rohdaten für die externe NMS aus. Lege nms=False fest, um einen verfügbaren Kopf ohne NMS auszuwählen; nicht unterstützte Formate greifen auf ihren nativen Ausgabepfad zurück. Die obigen Einträge nms kennzeichnen Formate, die NMS mit nms=True integrieren können.
Ausführliche Informationen zu export findest du auf der Seite Export.
Häufig gestellte Fragen#
Um ein YOLO26-Modell zur semantischen Segmentierung mit einem benutzerdefinierten Datensatz zu trainieren, musst du PNG-Maskenbilder vorbereiten, bei denen jeder Pixelwert eine Klassen-ID (0, 1, 2, ...) darstellt und Pixel mit dem Wert 255 beim Training ignoriert werden. Erstelle eine YAML-Datei für den Datensatz, die auf die Verzeichnisse mit den Bildern und Masken verweist, und trainiere dann das Modell:
Beispielfrom ultralytics import YOLO # Ein vortrainiertes YOLO26-Modell zur semantischen Segmentierung laden model = YOLO("yolo26n-sem.pt") # Das Modell trainieren results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=1024)Auf der Seite Konfiguration findest du weitere verfügbare Argumente.
Instanzsegmentierung und semantische Segmentierung sind beides Aufgaben auf Pixelebene, unterscheiden sich jedoch in einem wichtigen Punkt:
- Semantische Segmentierung weist jedem Pixel ein Klassenlabel zu, unterscheidet jedoch nicht zwischen einzelnen Objekten derselben Klasse. Beispielsweise haben alle Autos in einer Szene dasselbe Klassenlabel.
- Instanzsegmentierung erkennt jedes einzelne Objekt separat und erzeugt für jedes Objekt eine eigene Maske, selbst wenn die Objekte derselben Klasse angehören.
Semantische Segmentierung eignet sich am besten für Aufgaben zum Szenenverständnis, etwa autonomes Fahren und die Kartierung der Landbedeckung. Instanzsegmentierung ist vorzuziehen, wenn einzelne Objekte gezählt oder verfolgt werden müssen.
Ja. Wenn dein Datensatz Ultralytics-YOLO-Polygonlabels verwendet (ein
.txtpro Bild), lassemasks_dirin der YAML-Datei des Datensatzes weg und stelle sicher, dass sich im Stammverzeichnis des Datensatzes neben deinen Bildern kein Ordnermasks/befindet (allein dessen Vorhandensein aktiviert den PNG-Maskenmodus, auch wennmasks_dirnicht gesetzt ist). Der Loader wandelt Polygone dann während der Ausführung in semantische Masken für jedes Bild um. Bei Datensätzen mit mehreren Klassen (N > 1) wird automatisch eine zusätzliche Klassebackgroundannamesangehängt. Bei Datensätzen mit einer Klasse (N == 1) bleibt das Training bei einer Klasse – deine deklarierte Klasse wird in der Maske zu1, und nicht abgedeckte Pixel werden zu0. Weitere Informationen findest du im Leitfaden zu Datensätzen für semantische Segmentierung.Ultralytics YOLO26 bietet integrierte Konfigurationen für mehrere Datensätze zur semantischen Segmentierung:
- Cityscapes: Städtische Straßenszenen mit 19 Klassen, die häufig in der Forschung zum autonomen Fahren verwendet werden.
- ADE20K: Ein umfangreicher Datensatz zur Szeneninterpretation mit 150 Klassen.
Du kannst auch jeden benutzerdefinierten Datensatz verwenden, der annotierte PNG-Masken bereitstellt, deren Pixelwerte den Klassen-IDs entsprechen.
Validiere ein vortrainiertes YOLO26-Modell zur semantischen Segmentierung mit der für die Auswertung verwendeten YAML-Datei des Datensatzes:
Beispielfrom ultralytics import YOLO # Vortrainiertes Modell laden model = YOLO("yolo26n-sem.pt") # Das Modell validieren metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Mit diesen Schritten erhältst du Validierungsmetriken wie die mittlere Schnittmenge über Vereinigung (mIoU) und die Pixelgenauigkeit. Dies sind gängige Maße zur Bewertung der Leistung semantischer Segmentierung.
Exportiere ein YOLO26-Modell zur semantischen Segmentierung mit Python- oder CLI-Befehlen ins ONNX-Format:
Beispielfrom ultralytics import YOLO # Vortrainiertes Modell laden model = YOLO("yolo26n-sem.pt") # Exportiere das Modell in das ONNX-Format model.export(format="onnx")Weitere Informationen zum Export in verschiedene Formate findest du auf der Seite Export.