Qualcomm QNNエクスポート
Qualcomm AI Engine DirectはQNNとも呼ばれ、SnapdragonおよびDragonwingプロセッサのHexagon NPU向けQualcommランタイムです。Ultralytics YOLO26モデルをformat="qnn"でエクスポートすると、yolo26n_qnn.onnxが作成されます。これは、name引数で選択した世代のHexagon Tensor Processor(HTP)向けに、INT8の重みと16ビットの活性化を使用してコンパイルされたQNNコンテキストバイナリを唯一のノードとして含むONNXモデルです。エクスポートはONNX Runtimeを使用してお使いのコンピューター上で実行され、Qualcommのアカウントやデバイスは必要ありません。
概要#
| プロパティ | 詳細 |
|---|---|
format 引数 | qnn |
| 出力 | yolo26n_qnn.onnx、コンパイル済みQNNコンテキストバイナリを埋め込んだEPContextノードを含む1つのONNXファイル、およびクラス名、タスク、画像サイズをメタデータとして保存します |
| 実行環境 | nameに設定されたHTP世代のHexagon NPU:Snapdragon 888から8 Elite Gen 5までのSnapdragonスマートフォン、Snapdragon X Elite搭載ノートPC、Dragonwing IQ-8275。対応HTPターゲットを参照してください |
| ランタイム | QNN Execution Providerを使用するONNX Runtime:WindowsおよびLinuxではonnxruntime-qnn Pythonパッケージを使用するか、AndroidアプリでQNN対応のONNX Runtimeを使用します |
| 適合率 | W8A16のみ:dataの画像でキャリブレーションしたINT8ウェイトと16ビットアクティベーションです。YOLO26nは3.6 MBです |
| エクスポートホスト | Python 3.11以降を搭載したLinux x86-64またはARM64、あるいはWindows x64またはARM64が必要です。macOSには対応していません。x86-64 Ubuntu 24.04でテスト済みです。エクスポートはCPU上で実行され、GPUやSnapdragonデバイスは不要です |
Ultralytics Platformでは、トレーニング済みモデルを選択したHTPターゲット向けにQNNへエクスポートできるため、ローカルのエクスポート環境は不要です。
クイックスタート#
ONNXエクスポート依存関係とQNN Execution Providerを含むUltralyticsパッケージをインストールします:
pip install "ultralytics[export-base]" onnxruntime-qnnonnxruntime-qnnにはQualcomm AI Runtime(QAIRT)ライブラリが含まれており、必要なonnxruntimeの隣にインストールされます。通常のpip install ultralyticsを使用すると、初回エクスポート時にonnx、onnxslim、onnxruntime、onnxruntime-qnnが自動的にインストールされ、Restart runtime or rerun command for updates to take effectがログに出力された後、同じ実行内でエクスポートが完了します。エクスポートには次のバージョン要件があります:
| 要件 | バージョン |
|---|---|
| Python | onnxruntime-qnn 2.xパッケージが提供されているPython 3.11~3.14です。Python 3.11、3.12、3.14でエクスポートを実行しました |
| オペレーティングシステム | Linux x86-64ではglibc 2.35以降、Linux ARM64ではglibc 2.34以降、Windowsではx64またはARM64が必要です。onnxruntime-qnnにはmacOS向けパッケージがありません。詳しくは制限事項を参照してください |
onnxruntime-qnn | このページのすべてのエクスポートには2.8.0を使用し、onnxruntimeは1.32.0です。Ultralyticsではバージョンを固定していません |
ほかのインストール方法については、インストールガイドを参照してください。その後、モデルをエクスポートします。
from ultralytics import YOLO

# YOLO26モデルを読み込みます
model = YOLO("yolo26n.pt")

# # Snapdragon 8 Elite Gen 5(HTP v81)向けにモデルをQNN形式へエクスポートします
model.export(format="qnn", name="81", imgsz=640) # # 'yolo26n_qnn.onnx'を作成しますエクスポートではyolo26n_qnn.onnxがyolo26n.ptの隣に書き込まれ、そのファイルがすでに存在する場合は失敗するため、再度エクスポートする前に削除するか名前を変更してください。dataを指定しない場合、タスクの小さなデフォルトデータセット(たとえばcoco8.yamlの4枚の画像)を使ってキャリブレーションします。これはエクスポートのテストには十分ですが、モデルをリリースする前にデプロイデータの画像でキャリブレーションしてください。詳しくはキャリブレーションを参照してください。
次に、yolo26n_qnn.onnxをSnapdragonデバイスにコピーします。詳しくはデプロイを参照してください。PredictとValidateもx86-64 Linuxのエクスポートホスト上で低速ながら実行できるため、ファイルをコピーする前にエクスポート結果を確認できます。2つ目のQNNモデルを同じプロセスで実行すると失敗するため、それぞれ新しいPythonプロセスで実行してください。詳しくは制限事項を参照してください:
from ultralytics import YOLO

# # エクスポート済みQNNモデルを読み込みます
model = YOLO("yolo26n_qnn.onnx")

# 推論を実行
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # エクスポート済みQNNモデルを読み込みます
model = YOLO("yolo26n_qnn.onnx")
# COCO8データセットで精度を検証します
metrics = model.val(data="coco8.yaml")対応タスク#
QNNエクスポートは、Ultralyticsの7つすべてのタスクに対応しています:物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、深度推定、分類、姿勢推定、OBB。セマンティックセグメンテーションと深度推定は、それらのヘッドを搭載する唯一のファミリーであるYOLO26でのみ利用できます。各タスクのYOLO26nチェックポイントはすべてエクスポートホスト上でエクスポートして実行でき、YOLO11の物体検出モデルも同様でした。他のモデルファミリーはテストしていません。
エクスポート引数#
| 引数 | 種類 | デフォルト | 説明 |
|---|---|---|---|
format | str | 'qnn' | エクスポートしたモデルのターゲットフォーマットです。さまざまなデプロイ環境との互換性を定義します。 |
name | str | '73' | コンテキストバイナリのコンパイル対象となるHTP世代またはSoCです。例:'81'または'iq-8275'。対応HTPターゲットを参照してください。 |
imgsz | intまたはtuple | 640 | コンテキストバイナリ内で固定されるモデル入力の画像サイズです。正方形の画像の場合は整数、またはタプル(height, width)を指定します。指定しない場合、エクスポートにはチェックポイントのトレーニング時のサイズが使用されます。たとえばOBBでは1024、分類では224です。 |
quantize | intまたはstr | None | 精度です。未設定または'w8a16'の場合、唯一の精度であるINT8ウェイトと16ビットアクティベーションをビルドします。8、16、32を指定するとエラーになります。詳しくは精度を参照してください。非推奨のhalf/int8フラグに代わるものです。 |
data | str | None | キャリブレーション画像を指定するデータセットYAMLです。分類の場合は、代わりにデータセットディレクトリまたは組み込みデータセット名を指定します。splitが設定されていない場合、キャリブレーションにはvalの分割データを使用します。省略すると、Ultralyticsはタスクの小さなデフォルトデータセット(たとえばcoco8.yaml)を使用します。 |
fraction | float、int、またはlist | 1.0 | キャリブレーション用サブセット: 比率、画像数(1を超える整数)、または[train, val, test]リストを指定します。リストの場合、キャリブレーション分割のエントリが使用されます。 |
batch | int | 1 | エクスポート済みモデルのバッチサイズです。入力形状に固定され、キャリブレーションにも使用されます。 |
nms | bool、省略可 | None | 効果はありません。どの値を指定しても、Noneの生出力が書き込まれます。詳しくは出力形式を参照してください。 |
opset | int | None | 中間ONNXグラフのONNX opsetバージョンです。指定しない場合は、PyTorchのバージョンで使用できる最も高いopset(18以下)が使われます。これはPyTorch 2.4以降では18です。ONNX Runtimeの量子化ツールは、16ビットアクティベーションに対応するため、opsetを21に引き上げます。 |
simplify | bool | True | onnxslimを使用して、中間ONNXグラフを簡素化します。 |
device | str | None | 中間ONNXグラフのトレースに使用するデバイスです。デフォルトはcpuです。 |
すべての形式に共通する引数については、エクスポートモードのドキュメントを参照してください。
公式のQNN、LiteRT、Core MLモバイルモデルは、imgsz=640でエクスポートされます。分類ではimgsz=224です。Cityscapesのセマンティックセグメンテーション、深度推定、OBBのチェックポイントは、デフォルトではより大きなサイズでエクスポートされるため、サイズを合わせるにはimgsz=640を渡してください。7つすべてのタスクについて、各サイズおよびHTP v73とv81向けのQNNモデルは、yolo-flutter-appのv0.7.0リリースにあります。
サポート対象のHTPターゲット#
コンテキストバイナリは1つのHTP世代向けにコンパイルされるため、お使いのデバイスのnameを指定してエクスポートしてください。FlutterプラグインのREADMEでは、公式の_v73モデルの要件としてSnapdragon 8 Gen 2以降を挙げています。その他のエクスポートとデバイス世代の組み合わせはテストしていません。nameには、先頭のvの有無を問わず世代を指定できます。例:81、v81、V81。また、2種類のSoC名も大文字・小文字を問わず指定できます。サイズはimgsz=640でのYOLO26n物体検出モデルの値です:
name | Hexagon HTP | デバイスの例 | ONNX Runtimeのオプション | YOLO26nファイル |
|---|---|---|---|---|
68 | v68 | Snapdragon 888 | htp_arch=68 | 3.7 MB |
69 | v69 | Snapdragon 8 Gen 1 | htp_arch=69 | 3.8 MB |
73(デフォルト) | v73 | Snapdragon 8 Gen 2、Snapdragon X Elite | htp_arch=73 | 3.6 MB |
75 | v75 | Snapdragon 8 Gen 3 | htp_arch=75 | 3.6 MB |
79 | v79 | Snapdragon 8 Elite(SM8750) | soc_model=69 | 3.6 MB |
81 | v81 | Snapdragon 8 Elite Gen 5 | htp_arch=81 | 3.6 MB |
iq-8275 | v75 | Dragonwing IQ-8275 | soc_model=82 | 3.5 MB |
qcs8275 | v75 | Dragonwing QCS8275 | soc_model=82 | 3.5 MB |
Snapdragonデバイスは各世代の例であり、すべてを網羅しているわけではありません。nameを指定しない場合、エクスポートはQualcomm QNN export requires a missing 'name' arg for the target Hexagon HTP architecture. Using default name='73' (Snapdragon 8 Gen 2).をログに出力します。それ以外の値を指定すると、Invalid Qualcomm QNN target '66'. Valid targets are ('68', '69', '73', '75', '79', '81', 'iq-8275', 'qcs8275').で失敗します。Dragonwing IQ-615(QCS615)にはHexagon v66 DSPが搭載されていますが、Ultralyticsには対応するQNNターゲットがありません。代わりに、CPUまたはGPU向けの標準的なONNXモデルをエクスポートしてください。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="qnn", name="iq-8275", imgsz=640) # # 'yolo26n_qnn.onnx'を作成します適合率#
すべてのQNNエクスポートは、ONNX RuntimeのQNN QDQフローによってINT8ウェイトと16ビットアクティベーション(W8A16)に量子化されます。FP32またはFP16のエクスポート、および8ビットアクティベーションを使用するINT8エクスポートには対応していません:
quantize | 結果 |
|---|---|
未設定または'w8a16' | W8A16コンテキストバイナリです。YOLO26nは3.6 MBです。quantizeを指定しない場合、エクスポートはqnn export requires INT8 quantization, enabling it.をログに出力します |
8 | quantize=8 (INT8) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations).で失敗します |
16 | quantize=16 (FP16) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations).で失敗します |
32 | quantize=32 (FP32) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations).で失敗します |
セマンティッククラスマップを除き、入力と出力はfloat32のままです。入力の量子化と出力の逆量子化は、コンテキストバイナリ内で実行されるためです。
キャリブレーション#
エクスポートでは、splitで指定した分割データ、またはdataのval分割データから、各フルバッチを使ってアクティベーション範囲をキャリブレーションします。画像が300枚未満の場合は警告>300 images recommended for INT8 calibration, found 4 images.が表示されます。デプロイデータに近い画像をdataで渡し、枚数を制限するにはfractionを使用してください。初回の実行時には、coco.yamlによって約20 GBのCOCOデータセット全体がダウンロードされます:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# COCOの検証画像の10%(500枚)でキャリブレーションします。coco.yamlを独自のデータセットに置き換えてください
model.export(format="qnn", name="81", imgsz=640, data="coco.yaml", fraction=0.1)
上記のキャリブレーションでは使用しないCOCO val2017の最後の500枚の画像で、YOLO26nはx86-64エクスポートホスト上のvalで次のスコアを達成しました。同じ画像を使い、PyTorchチェックポイントおよびFP32 ONNXエクスポートと比較しています:
| モデル | mAPval 50-95 | mAPval 50 |
|---|---|---|
| PyTorch | 42.1 | 57.1 |
| ONNX FP32 | 42.0 | 56.9 |
coco8.yaml(4枚の画像)でキャリブレーションしたQNN | 38.9 | 54.6 |
fraction=0.1(500枚の画像)を使い、coco.yamlでキャリブレーションしたQNN | 39.1 | 54.5 |
coco8.yamlの4枚ではなくCOCO画像500枚でキャリブレーションすると、mAPval 50-95は0.2ポイント上昇し、mAPval 50は0.1ポイント低下しました。また、どちらのQNNモデルも、mAPval 50-95でFP32 ONNXエクスポートを2.9~3.1ポイント下回りました。小さなデフォルトデータセットでは、深度推定の低下が最も大きくなりました。キャリブレーション画像にも使われたdepth8.yamlの検証画像4枚では、QNN深度モデルのdelta1は56.0%で、FP32 ONNXエクスポートの89.7%を下回りました。デプロイ前に、エクスポート済みモデルを独自のデータで検証してください。
出力形式#
エクスポートでは1つのファイルを書き込み、中間ONNXモデルをその隣に保持します:
| ファイル | 内容 |
|---|---|
yolo26n_qnn.onnx | QNNコンテキストバイナリを埋め込んだ1つのEPContextノードを含むONNXモデルです。クラス名、タスク、画像サイズ、バッチサイズ、ストライド、エクスポート引数はONNXメタデータとして保存され、モデルの読み込み時にUltralyticsが読み取ります |
yolo26n.onnx | 量子化されたFP32 ONNXグラフで、入力は同じくchannels-lastです。同じディレクトリにある同じチェックポイントの以前のyolo26n.onnxエクスポートが置き換えられます。デプロイには不要です。YOLO()では実行できず、Got invalid dimensions for input: imagesで失敗します |
モデルは(batch, height, width, 3)の形状を持つimagesという名前の入力を1つ受け取ります。RGB、channels-last(NHWC)、float32で、値は0~1にスケーリングされています。これはONNXエクスポートのchannels-first入力とは異なり、カメラフレームおよびHTPのレイアウトに一致します。出力の形状はデフォルトのONNXエクスポートと同じです。以下の形状は、公式モバイルモデルのサイズであるimgsz=640を使用したYOLO26nチェックポイントと、分類用のimgsz=224、セマンティックセグメンテーション用のCityscapesチェックポイントyolo26n-sem.ptに対応します:
| タスク | imgsz | 出力 |
|---|---|---|
| Detect | 640 | (1, 84, 8400) |
| Segment | 640 | (1, 116, 8400)と(1, 32, 160, 160) |
| セマンティック | 640 | (1, 640, 640)、uint8。各ピクセルのクラスインデックス |
| 深度 | 640 | (1, 1, 640, 640)、深度マップ |
| 分類 | 224 | (1, 1000)、クラス確率 |
| 姿勢推定 | 640 | (1, 56, 8400) |
| OBB | 640 | (1, 20, 8400) |
- 生出力:各アンカーについて、入力ピクセル単位のボックス中心x、中心y、幅、高さに続いてクラススコア、さらにタスク固有の値(32個のマスク係数、17個のキーポイント値×3、またはラジアン単位のOBB角度)が出力されます。NMSはご自身で適用してください。各タスクのレイアウトについてはONNX出力形式を参照してください。NMSなし、またはNMS組み込みの出力には対応していません。
nms=FalseはThis export format does not support end2end models, disabling the end2end branch.をログに出力し、nms=Trueはformat=qnn does not support embedded NMS; using nms=None.をログに出力しますが、どちらもこの生出力を書き込みます。 - セマンティックセグメンテーション:出力は各ピクセルのクラスインデックスを示す
uint8です(256を超えるクラスを持つモデルではint32)。クラスごとのスコアではなく、NPU上で計算されます。 - セグメンテーション: 2つ目の出力にはマスクプロトタイプが格納されます。
- ONNXと同じレイアウト:各タスクにつき1枚の画像で比較したところ、すべてのQNNモデルの出力は、同じチェックポイントのFP32 ONNXエクスポートと形状および型が一致しました。物体検出、インスタンスセグメンテーション、姿勢推定、OBBの第1出力の相関は0.999以上で、セグメンテーションマスクのプロトタイプは0.95でした。分類(相関0.76)、セマンティックセグメンテーション(ピクセルの69%が一致)、深度推定(相関0.24)では、生出力の差が大きくなりました。小さなデフォルトデータセットでの
valでは、深度推定の低下が最も大きくなりました。詳しくはキャリブレーションを参照してください。
YOLO("yolo26n_qnn.onnx")はONNXメタデータからレイアウトを読み取るため、モデルを独自コードで実行する場合にのみ、以下の詳細が必要です。メタデータキーにはnames、task、imgsz、stride、batch、end2end、argsが含まれます。姿勢推定モデルでは、さらにkpt_shapeも含まれます。
ONNX Runtimeで実行する#
Ultralyticsパッケージ以外でモデルを実行するには、onnxruntime-qnnのQNN Execution ProviderをONNX Runtimeに登録し、HTPバックエンドライブラリを指定します。onnxruntime-qnn 2.xが必要で、これはonnxruntime_qnnモジュールを提供します。x86-64エクスポートホストでは動作しましたが、Snapdragonデバイスでは実行していません:
# # 先にエクスポートします:yolo export model=yolo26n.pt format=qnn name=81 imgsz=640
import ast

import numpy as np
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]
options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)

image = np.zeros((1, 640, 640, 3), dtype=np.float32)  # # レターボックス処理した画像:RGB、NHWC、0-1
output = session.run(None, {session.get_inputs()[0].name: image})[0]
assert output.shape == (1, 84, 8400), "export a detection model at imgsz=640"

names = ast.literal_eval(session.get_modelmeta().custom_metadata_map["names"]) # {0: 'person', 1: 'bicycle', ...}デプロイする#
Windows on Snapdragon搭載ノートPC、またはBSPがHTPランタイムを提供するLinux ARM64ボード(Qualcomm Linuxボードを参照)では、pip install ultralytics onnxruntime-qnnを指定してパッケージをインストールし、yolo26n_qnn.onnxをデバイスにコピーします。次にYOLO("yolo26n_qnn.onnx")がQNN Execution Providerを登録し、HTPバックエンドを使ってコンテキストバイナリを実行します。このページ向けにonnxruntime-qnn 2.8.0で作成したエクスポートはSnapdragonデバイスで実行していません。Windowsでの計測では、それ以前のv73エクスポートを使用しました。
- HTPの一致:デバイスのHTP世代に対応する
nameを指定してエクスポートしてください。 - Androidアプリ:FlutterプラグインのREADMEには、
_qnn.onnxモデルで使用するセットアップが記載されています。これにはcom.microsoft.onnxruntime1.29.0およびcom.qualcomm.qti2.51.0パッケージと、Hexagon DSPローダーが実際の.soファイルを必要とするため、packagingOptions.jniLibs内のuseLegacyPackaging = trueが含まれます。また、Ultralytics 8.4.188より前にonnxruntime-qnn2.4以降で作成したエクスポートは、Input name not foundが原因で読み込みに失敗すると記載されています。このセットアップは、このページのエクスポートでは実行していません。 - NPUのみ:Snapdragonデバイスでは、コンテキストバイナリはHTP上でのみ実行されます。Adreno GPUまたはCPU向けには、代わりにLiteRTモデルまたは標準的なONNXモデルをエクスポートしてください。Androidでの計測では、CPUおよびGPU上のLiteRTと、NPU上のQNNを比較しています。
- 入力形状は固定:モデルは常に、エクスポート時の
imgszとbatchで実行され、これらはUltralyticsがONNXメタデータから読み取ります。predictまたはvalに渡したimgszは無視されます。小さいバッチはパディングされます。また、batch=2モデルでは、1枚および3枚の画像で予測を実行できました。 - 1プロセスにつきQNNモデルは1つ:2つ目のQNNモデルを読み込む場合、または
predictの後にvalを実行する場合は、新しいPythonプロセスで実行してください。詳しくは制限事項を参照してください。 - ファイル名:Ultralyticsはファイル名の末尾で形式を識別するため、ファイル名の最後に
_qnn.onnxを付けてください。yolo26n_npu.onnxという名前のコピーは通常のONNXモデルとして読み込まれ、EPContext node generated by 'QNNExecutionProvider' is not compatible with any execution provider added to the session.で失敗します
Ultralytics Flutterプラグイン#
Ultralytics YOLO Flutterプラグインは、YOLO26の7つすべてのタスクのQNNエクスポートをAndroid上で実行し、リアルタイムカメラ推論と単一画像の予測に対応します。QNNサポートはオプトイン方式です。プラグインのREADMEに従ってQNNランタイムを有効にし、ONNX Runtime依存関係を追加してください。このページのAndroidでの計測には、このプラグインを使用しました。iOSについては、Ultralytics iOS SDKとCore ML統合を参照してください。
Qualcomm Linuxボード#
Qualcomm LinuxまたはYocto BSPを搭載したIQ-8275などのDragonwingボードでは、ランタイムはボードベンダーのQAIRT対応BSPから提供され、エクスポート済みモデルには含まれません。HTP推論を行うには、BSPがONNX Runtime QNN Execution Provider、libQnnSystem.so、libQnnHtp.so、ボードのHTP世代に対応するHTPスタブおよびスケルトンライブラリ(IQ-8275ではv75)、libcdsprpc.soなどのFastRPCユーザー空間サポート、DSPファームウェア、および対応するFastRPCカーネルドライバーを提供する必要があります。スケルトンライブラリはBSPのDSPライブラリパスに配置する必要があります。GPUで実行するには、代わりにlibQnnGpu.soとAdrenoユーザー空間ドライバーが必要です。また、_qnn.onnxファイルはHTPを対象とするため、標準的なONNXエクスポートを使用してください。
デプロイガイド#
- ONNX Runtime QNN Execution Provider:
_qnn.onnxファイルを読み込むプロバイダーのオプション、対応演算子、AndroidおよびWindows向けパッケージです。 - Qualcomm AI Engine Direct SDK:QNNとQAIRTに関するQualcommのリファレンスです。
- Ultralytics YOLO Flutterプラグイン:QNN、LiteRT、Core MLモデルを使用するAndroidアプリ向けです。
- LiteRTとMediaTek Dimensity:CPUおよびGPUでのAndroidデプロイと、MediaTek NPUでのデプロイに対応します。
- モデルのデプロイ方法:QNNとその他のエクスポート形式を比較します。
制限事項とトラブルシューティング#
- macOSおよびPython 3.10:
onnxruntime-qnn2.xのパッケージは、LinuxおよびWindowsのPython 3.11~3.14向けのみです。macOSおよびPython 3.10のLinuxでは、onnxruntime-qnnのインストールが失敗し(pipはNo matching distribution found for onnxruntime-qnnを報告します)、エクスポートは続行されてモデルを量子化した後、Failed to load library .../onnxruntime/capi/libonnxruntime_providers_qnn.soで失敗します。Python 3.10のWindows x64では、代わりに以前のonnxruntime-qnn1.23.2がpipによってインストールされますが、これはテストしていません。Python 3.11以降のLinuxまたはWindowsでエクスポートするか、Ultralytics Platformを使用してください。 - 自動インストールが無効:
YOLO_AUTOINSTALL=falseがあり、onnxruntime-qnnがない場合、エクスポートはUltralytics requirement ['onnxruntime-qnn'] not found, AutoUpdate disabled by YOLO_AUTOINSTALL=Falseをログに出力し、同じFailed to load libraryエラーで失敗します。クイックスタートの手順に従ってインストールしてください。 - 出力ファイルがすでに存在する場合:エクスポートでは
yolo26n_qnn.onnxを.ptファイルの隣に書き込みますが、ONNX Runtimeは既存ファイルを上書きしません。ファイルが存在すると、エクスポートはFailed to generate EP context model since the file '"yolo26n_qnn.onnx"' exists already. Please remove the EP context model if you want to re-generate it.で失敗し、その後Pythonプロセスがセグメンテーションフォルトで終了する場合があります。異なるname、imgsz、dataを使用する場合も含め、再度エクスポートする前に以前のファイルを削除するか名前を変更してください。 - 1つのプロセスで2つ目のQNNモデルを使用する場合:2つ目の
_qnn.onnxモデルを読み込むか、QNNモデルでpredictを実行した後にvalまたはエクスポートを実行すると、EP library is already registered under QNNExecutionProviderで失敗します。同じYOLOオブジェクトで複数回予測すること、およびエクスポート直後にpredictを実行することは可能です。yoloCLIと同様に、モデルごとに新しいPythonプロセスを使用してください。 - 入力形状は固定です:
dynamic=Trueはargument 'dynamic' is not supported for format='qnn'で失敗します。画像サイズまたはバッチサイズを変更するには、再度エクスポートしてください。 dataを指定しないキャリブレーション:エクスポートはINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.をログに出力し、タスクの小さなデフォルトデータセットでキャリブレーションします。デプロイデータを代表する画像を含むdataを指定してください。- Opsetの警告:
opset=21を指定しない場合、ONNX Runtimeの量子化ツールはThe original model opset version is 18, which does not support 16-bit integer quantization natively. Please update the model to opset >= 21. Automatically update the model to opset 21. Please verify the quantized model.をログに出力します。その際、18の代わりにエクスポート時のopsetが表示され、グラフのopsetが21に引き上げられます。エクスポートは続行されるため、対応は不要です。 quantize=8でトレーニングしたチェックポイント:量子化を考慮したトレーニングでファインチューニングしたチェックポイントは、format='qnn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backendsで失敗します。代わりに、ファインチューニング開始時に使用したチェックポイントをエクスポートしてください。- エクスポートホストでの推論:x86-64 Linuxでは、
onnxruntime-qnnにより、YOLO26nのname=73およびname=81コンテキストバイナリを、CPU負荷の高いサーバー上で1画像あたり約0.3秒(分類)から16秒(深度推定)で実行できました。スマートフォンではミリ秒単位です。速度の測定ではなく、エクスポート結果の確認に使用してください。
その他のエラーについては、よくある問題のガイドを参照してください。
実測パフォーマンス#
以下の表には、2台のSnapdragonデバイスで測定した画像1枚あたりのレイテンシー(公開済みのv0.7.0 HTP v81モデル(Android)および以前のHTP v73エクスポート(Windows)で測定)と、このページ用にx86-64 Linuxサーバーで作成したエクスポートのサイズが示されています。レイテンシーの各セルには合計時間(ミリ秒)が示され、その下に前処理/推論/後処理の内訳が表示され、各モデルで最速の列は太字で示されています。YOLO26モデルページには、PyTorchチェックポイントの精度が掲載されています。
Androidスマートフォン#
ハードウェア:12 GB LPDDR5XメモリおよびAndroid 17 / API 37を搭載したXiaomi 17です。3 nmプロセスのSnapdragon 8 Elite Gen 5(SM8850)には、8コアのQualcomm Oryon CPU(最大4.6 GHzのPrimeコア2基、最大3.62 GHzのPerformanceコア6基)、Adreno GPU、Hexagon NPU(HTP v81)が搭載されています。
| モデル | タスク | サイズ (ピクセル) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Detect | 640 | 36.9 1.9 / 32.6 / 2.3 | 10.6 1.8 / 6.2 / 2.6 | 10.2 1.9 / 6.0 / 2.3 |
| YOLO26n-seg | Segment | 640 | 50.5 1.9 / 42.9 / 5.8 | 18.0 1.9 / 9.5 / 6.6 | 16.2 2.1 / 8.4 / 5.7 |
| YOLO26n-sem | セマンティック | 640 | 45.7 1.9 / 35.7 / 8.2 | 30.6 1.9 / 20.5 / 8.3 | 10.8 2.0 / 6.2 / 2.6 |
| YOLO26n-depth | 深度 | 640 | 66.8 2.2 / 55.0 / 9.7 | 21.9 2.1 / 10.1 / 9.8 | 19.3 2.2 / 7.4 / 9.7 |
| YOLO26n-cls | 分類 | 224 | 3.6 0.3 / 3.3 / 0.0 | 2.0 0.4 / 1.4 / 0.2 | 0.8 0.3 / 0.5 / 0.0 |
| YOLO26n-pose | 姿勢推定 | 640 | 39.9 2.0 / 36.5 / 1.4 | 10.0 1.8 / 6.7 / 1.4 | 9.7 1.9 / 5.9 / 1.8 |
| YOLO26n-obb | OBB | 640 | 36.3 2.0 / 33.2 / 1.2 | 10.1 2.6 / 5.9 / 1.6 | 8.1 1.9 / 5.1 / 1.0 |
- 速度は単一画像のバーストレイテンシーです。
bus.jpg上でウォームアップ3回の後に15回実行した平均値で、Flutterプラグインの0.7.1オンデバイスベンチマークハーネスと、公式のv0.7.0アセット(Ultralytics 8.4.188エクスポート)を使って測定しました。バックエンドの順序は、1回の連続計測中にタスク間でローテーションしました。ネイティブログにより、すべてのCPU行がLiteRT CPU/XNNPACKを、すべてのGPU行がLiteRT OpenCL(LITERT_CL)にグラフ全体を委譲する方式を、すべてのNPU行がQNN Hexagon HTPバックエンドを使用したことを確認しました。 - CPU列とGPU列には、同じリリースの
w8a32LiteRTモデルを使用しているため、表では同一のスマートフォンにおいてNPUを他のプロセッサと比較しています。 - 詳細なベンチマーク記録はFlutterパフォーマンスドキュメントにあります。
- LiteRT統合では、MediaTek Dimensityガイドを含む他のAndroidデバイスを比較できます。Appleデバイスについては、Core ML統合を参照してください。
Windows on Snapdragon搭載ノートPC#
ハードウェア:メモリ32 GB、Windows 11搭載のLenovoノートPCです。Snapdragon X Elite(X1E78100)には、12コアのQualcomm Oryon CPU、Adreno GPU、Hexagon NPU(HTP v73)が搭載されています。Lenovoの正確なモデルは記録されていません。
この以前の計測では、PyTorch FP32のCPUベースラインとHexagon NPU上のQNNモデルを比較しています。ultralytics 8.4.67、onnxruntime-qnn 2.2.0、torch 2.10.0+cpu、Python 3.12.10を使って測定しました。224/640のモバイルサイズが標準になる前にエクスポートしたv73モデルを使用したため、セマンティックセグメンテーションモデルとOBBモデルは1024ピクセルで実行され、深度推定の行はありません。各セルにはmodel.predict()の全実時間と、その下に報告された前処理/推論/後処理の内訳を示します。合計時間には、これら3段階以外のフレームワークオーバーヘッドが含まれる場合があります。
| モデル | タスク | サイズ (ピクセル) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Detect | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segment | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | セマンティック | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | 分類 | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | 姿勢推定 | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- 速度は単一画像のバーストレイテンシーです。
bus.jpg上でウォームアップ10回の後に100回実行した平均値で、温度が安定したデバイス上で、time.perf_counter()を使ってmodel.predict()の呼び出し全体を計測しました。 - Hexagon NPUは、640および1024ピクセルではPyTorch CPUベースラインより2.2~4.1倍高速で、固定の前処理時間の比重がより大きい224ピクセルの分類モデルでは1.3倍高速でした。
モデルサイズ#
YOLO26物体検出モデルのサイズを、PyTorchチェックポイントおよびHTP v81向けimgsz=640の_qnn.onnxファイルとしてMB(10^6バイト)単位で示します。エクスポートログにはMiB単位で表示されます。YOLO26n v81では(3.5 MB)です:
| モデル | PyTorch | QNN v81 |
|---|---|---|
| YOLO26n | 5.5 | 3.6 |
| YOLO26s | 20.4 | 11.1 |
| YOLO26m | 44.3 | 22.8 |
| YOLO26l | 53.2 | 27.9 |
| YOLO26x | 118.7 | 60.6 |
Snapdragonハードウェアのないx86-64 Linuxサーバーで、ultralytics 8.4.215、onnxruntime-qnn 2.8.0、onnxruntime 1.32.0を使ってエクスポートしました。キャリブレーションのセクションには、YOLO26nエクスポートのCOCO精度が記載されています。
Qualcomm QNNについて#
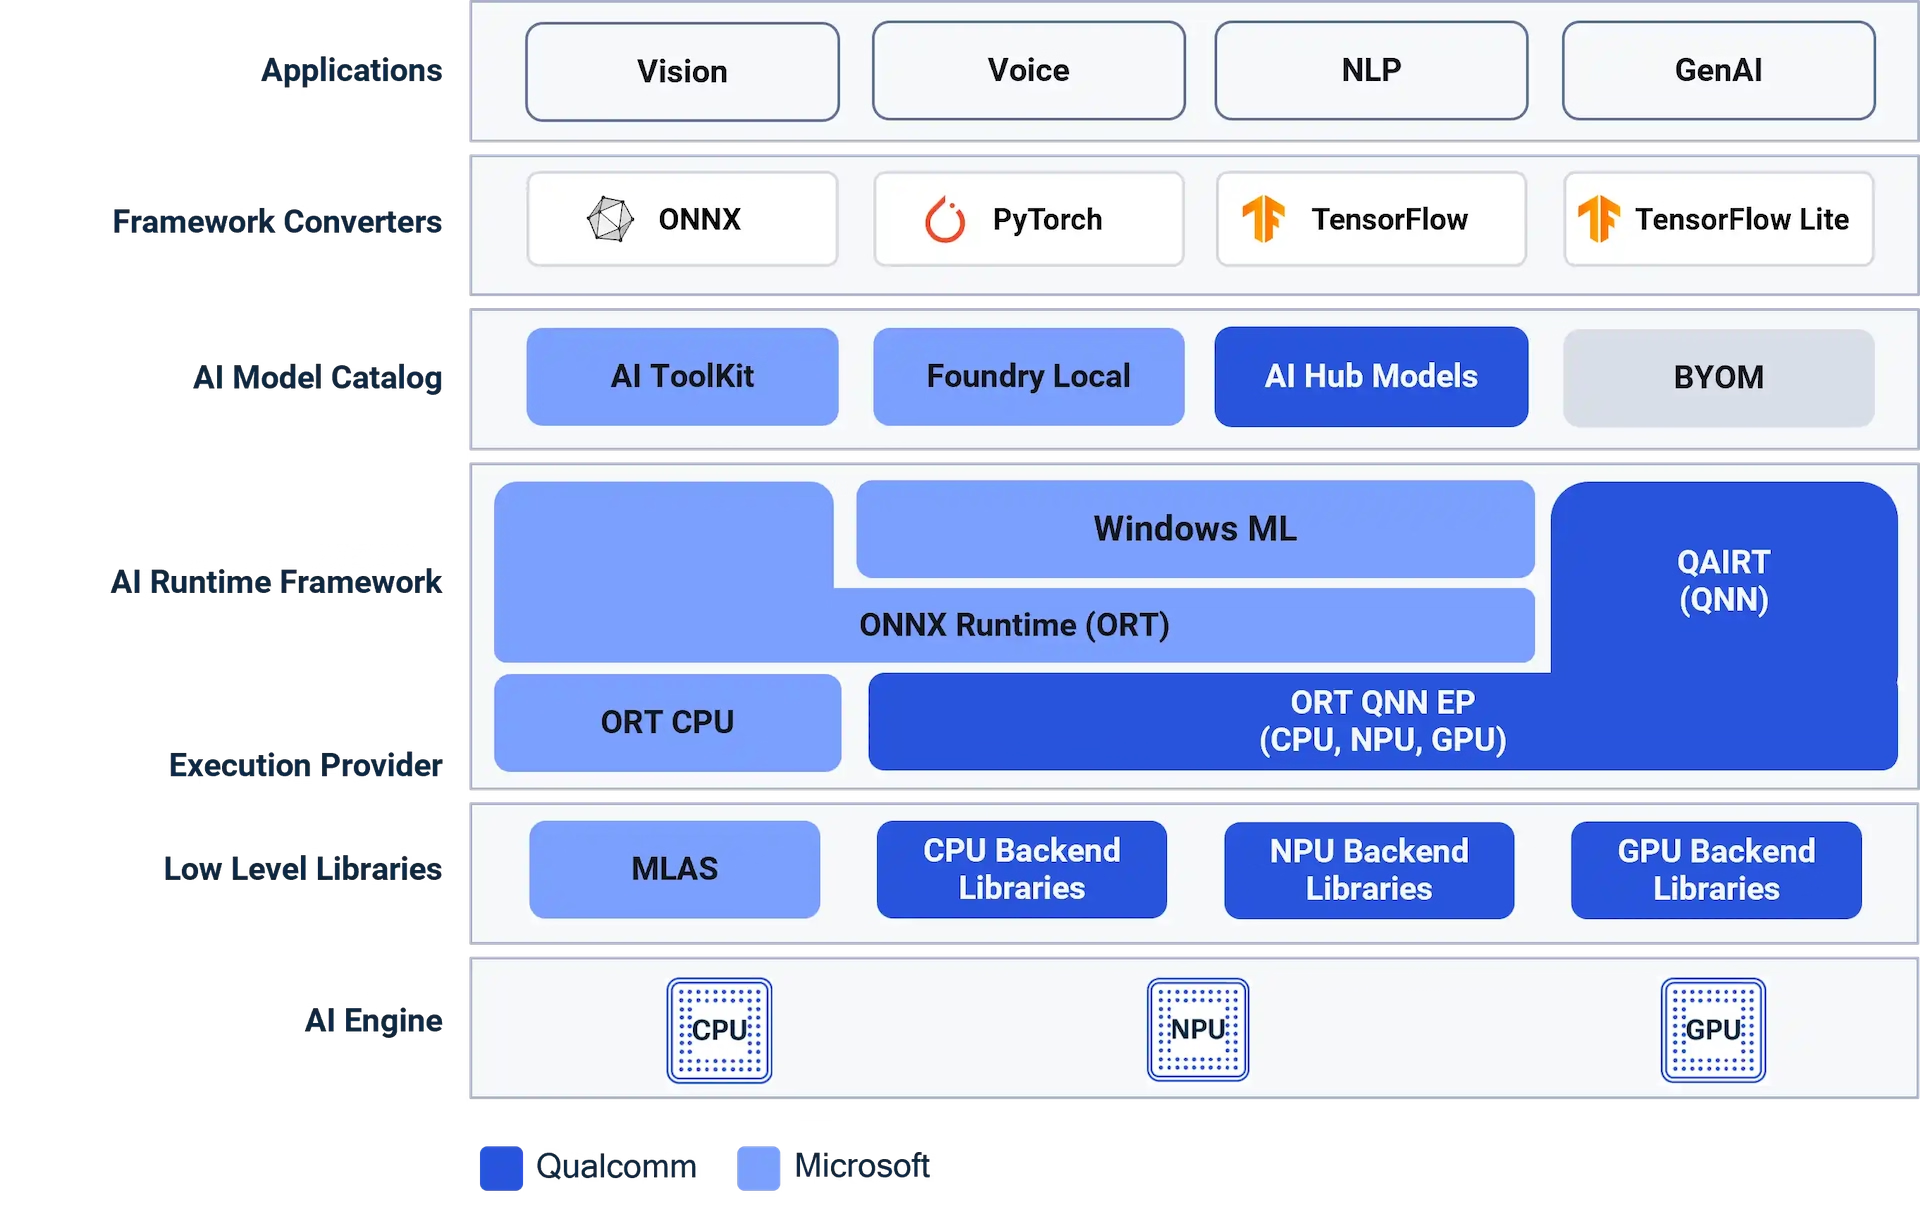
Qualcomm AI Engine Direct(QNN)はQualcomm AI Runtime(QAIRT)SDKの一部で、各プロセッサ向けのバックエンドライブラリを通じて、1つのAPIからSnapdragonおよびDragonwingプロセッサのCPU、Adreno GPU、Hexagon NPU上でニューラルネットワークを実行します。以前のSnapdragon Neural Processing Engine(SNPE)SDKに代わるものです。Ultralyticsは、ONNX Runtime QNN Execution Providerを通じてHTPバックエンドを使用します。詳しいリファレンスはQualcomm AI Engine Direct SDKを参照してください。
よくある質問#
いいえ。エクスポートは、QAIRTライブラリを含むPyPIの
onnxruntime-qnnパッケージで実行できます。このページ向けに作成したすべてのエクスポートは、Qualcommアカウント、SDKのダウンロード、Snapdragonハードウェアなしで、x86-64 Linuxサーバー上で実行しました。NPUの速度でモデルを実行するにはデバイスが必要です。Qualcomm AI Hubは、ホストされたSnapdragonデバイス上でモデルをコンパイル、プロファイリング、ベンチマークするためのQualcommのクラウドサービスで、利用にはQualcommアカウントが必要です。Ultralyticsのエクスポートでは、
export(format="qnn")を1回呼び出すだけで、アカウント登録やアップロードをせずに、同じHexagon NPU向けのQNNコンテキストバイナリを自分のコンピューター上でコンパイルでき、速度も自分のデバイスで測定できます。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。