Ultralytics YOLOによるセマンティックセグメンテーション
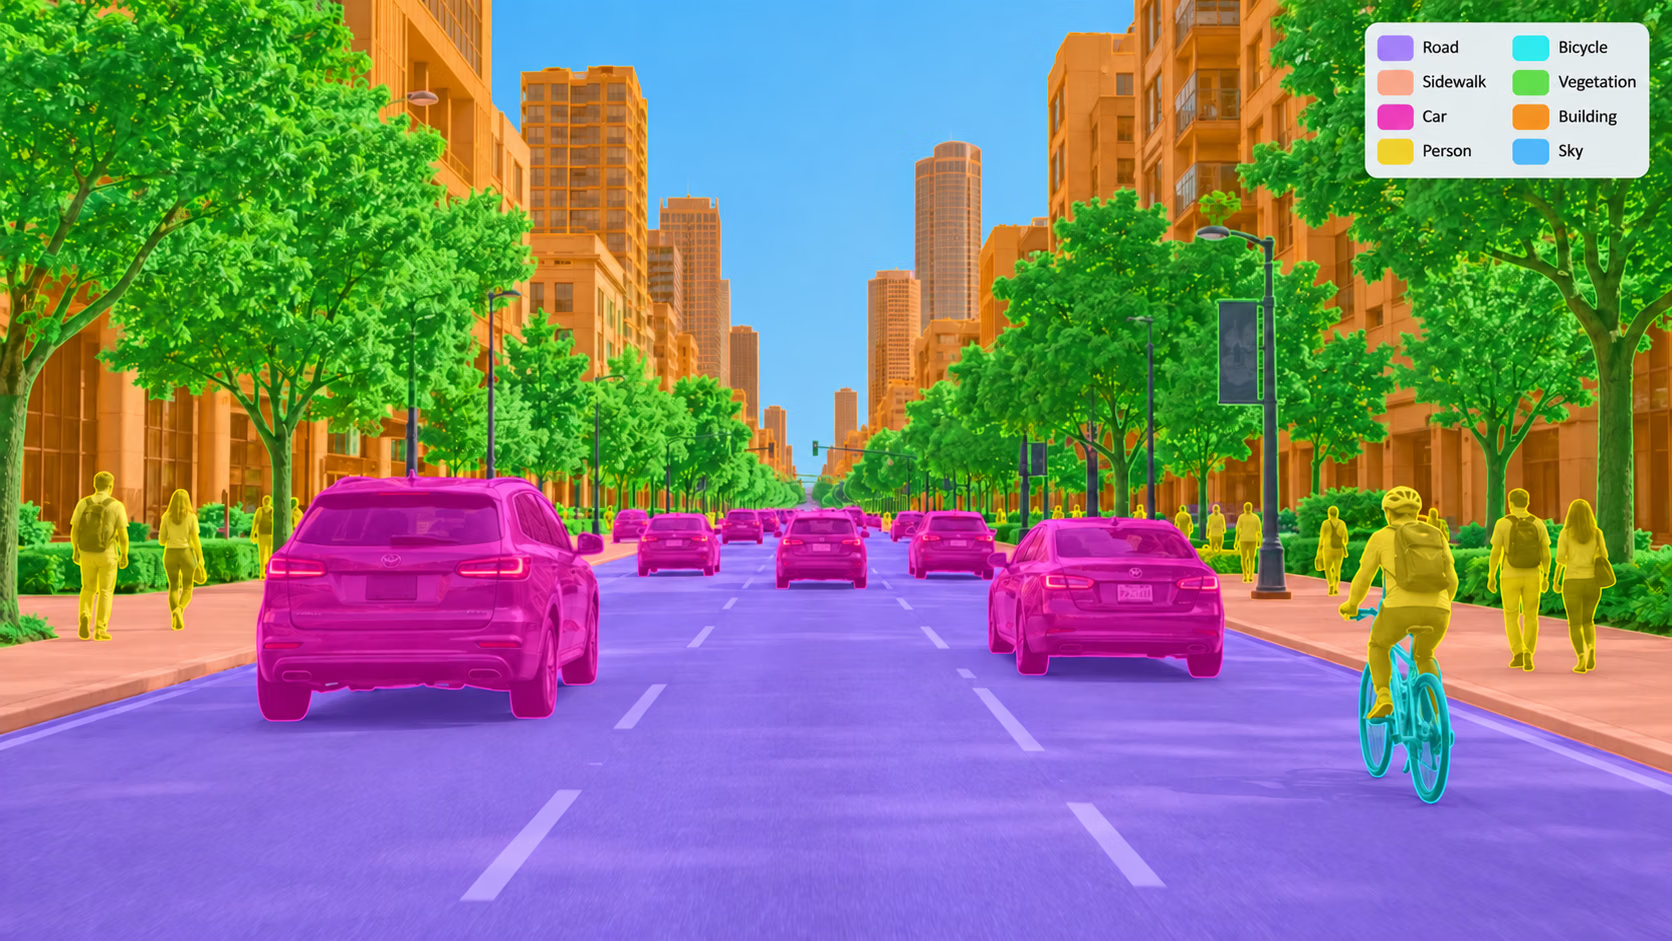
セマンティックセグメンテーションは、画像内のすべてのピクセルにクラスラベルを割り当て、シーン全体を覆う高密度なクラスマップを生成します。個々のオブジェクトを分離するインスタンスセグメンテーションとは異なり、セマンティックセグメンテーションでは、個別のオブジェクトの数にかかわらず、同じクラスのすべてのピクセルをまとめます。
視聴: Ultralytics YOLO26 によるセマンティックセグメンテーション | クイックスタートチュートリアル
セマンティックセグメンテーションモデルの出力は、高さ×幅の単一のクラスマップで、各ピクセル値が予測されたクラスIDに対応します。そのため、自動運転、医療画像、土地被覆マッピングなどのシーン解析タスクに適しています。
セマンティックセグメンテーションには、task=semanticまたはyolo semantic CLIタスクを使用します。YOLO26のセマンティックセグメンテーションモデルファイルは-semサフィックスを使用します(例: yolo26n-sem.pt)。
モデル#
Cityscapesデータセットで事前学習されたYOLO26 Semanticモデルを以下に示します。
モデルは、初回使用時に最新のUltralytics リリースから自動的にダウンロードされます。
| モデル | サイズ (ピクセル) | mIoUval | 速度 RTX3090 PyTorch (ms) | パラメーター (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- mIoUvalの値は、Cityscapes検証セットにおける単一モデル、単一スケールでのものです。
yolo semantic val data=cityscapes.yaml device=0 imgsz=2048で再現できます。 - Speedメトリクスは、RTX3090インスタンスを使用してCityscapes検証画像全体で平均した値です。
yolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048で再現できます。 - ParamsとFLOPsの値は、ConvレイヤーとBatchNormレイヤーを統合する
model.fuse()の実行後の融合モデルに対するものです。事前学習済みチェックポイントはトレーニング時の完全なアーキテクチャを保持するため、より大きな値を示す場合があります。
ADE20Kデータセットで事前学習されたYOLO26 Semanticモデルを以下に示します。
| モデル | サイズ (ピクセル) | mIoUval | 速度 RTX3090 PyTorch (ms) | パラメーター (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- mIoUvalの値は、ADE20K検証セットにおける単一モデル、単一スケールでのものです。
yolo26n-sem-ade20k.ptを目的のyolo26*-sem-ade20k.ptチェックポイントに置き換えて、yolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640で再現できます。 - Speedメトリクスは、RTX3090インスタンスを使用してADE20K検証画像全体で平均した値です。
yolo26n-sem-ade20k.ptを目的のyolo26*-sem-ade20k.ptチェックポイントに置き換えて、yolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640で再現できます。 - ParamsとFLOPsの値は、ConvレイヤーとBatchNormレイヤーを統合する
model.fuse()の実行後の融合モデルに対するものです。事前学習済みチェックポイントはトレーニング時の完全なアーキテクチャを保持するため、より大きな値を示す場合があります。
予備的なCityscapes mIoUの結果については、未リリースのYOLO27プレビューをご覧ください。
学習#
Cityscapes8データセットで、画像サイズ1024、100エポックの条件でYOLO26n-semモデルをトレーニングします。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-sem.yaml")  # YAMLから新しいモデルを構築します
model = YOLO("yolo26n-sem.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # YAMLからモデルを構築し、重みを転送します

# モデルをトレーニングする
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)trainモードの詳細は、Trainページをご覧ください。セマンティックセグメンテーションモデルは、Ultralytics Platformのクラウドトレーニングでもトレーニングできます。
完全な再現性が必要でない場合は、低速な決定論的CUDAカーネルを回避するためにdeterministic=Falseを設定します。
データセットのフォーマット#
セマンティックセグメンテーションデータセットでは、通常PNG形式のシングルチャンネルマスク画像を使用し、各ピクセル値がクラスIDを表します。値が255のピクセルは「ignore」として扱われ、損失計算から除外されます。データセットのYAMLには、画像と対応するマスクディレクトリのパスを指定します。YOLOポリゴンラベルを含むデータセットは、オンザフライでマスクに変換され、直接トレーニングできます(下記のインスタンスセグメンテーションのデータを使用できますかをご覧ください)。形式の詳細は、Semantic Segmentation Dataset Guideをご覧ください。対応データセットには、CityscapesとADE20Kがあります。Ultralytics Platformのアノテーションを使用して、セマンティックデータセットを管理し、ラベル付けできます。
検証#
トレーニング済みYOLO26n-semモデルの精度を、セマンティックセグメンテーションデータセット上で平均Intersection over Union(mIoU)として測定して検証します。意図したデータセットのYAMLが使用されるよう、data を明示的に渡してください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-sem.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルを検証します
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # 平均IoU
metrics.pixel_accuracy  # 全体のピクセル精度
save_json=True を設定すると、検証実行の results/ フォルダーに、各予測を元画像と同じサイズのシングルチャンネルPNGクラスマスクとして保存します。マスクでは、すべての検証画像に共通する親ディレクトリからの相対パスが各画像について保持されるため、images/val/a/1.png と images/val/b/1.png はそれぞれ results/a/1.png と results/b/1.png として保存されます。データセットYAMLで label_mapping が定義されている場合、マスクには元のラベルIDが使用されます(例:Cityscapesの labelIds)。
推論#
トレーニング済みのYOLO26n-semモデルを使用して、画像の推論を実行します。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-sem.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルで予測します
results = model("https://ultralytics.com/images/bus.jpg")  # 画像に対して予測します

# 結果にアクセスします
for result in results:
semantic_mask = result.semantic_mask.data # クラスマップ、shape (H,W)、クラス数に応じて選択される整数dtypePredictページでpredictモードの詳細をご確認ください。
結果の出力#
YOLOのセマンティックセグメンテーションは、画像ごとに1つのResultsオブジェクトを返します。各結果には、物体マスクのリストではなく、画像全体を対象とした1つの高密度なクラスマップが格納されます。予測クラスが同じピクセルには、別々の物体に属していても同じクラスIDが割り当てられます。
| 属性 | 種類 | 形状 | 説明 |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | 密なクラスマップです。 |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | クラスIDです。データ型はクラス数に応じて選択されます。 |
result.masks | - | - | インスタンスマスクはありません。 |
result.boxes | - | - | インスタンスボックス/信頼度はありません。 |
すべてのタスクにおける、タスク固有のResultsフィールドについては、タスク別の予測結果セクションをご覧ください。
セマンティックセグメンテーションは高密度なクラスマップを予測し、その後、可視化や後続処理に使用できるよう、マップを画像サイズにリサイズします。そのため、車線標示、コートのライン、ポール、ワイヤーなどの非常に細い構造は、元画像の解像度よりも大幅に低いimgszで推論すると、階段状に見えることがあります。境界がぎざぎざに見える場合は、まずネイティブのPyTorch .ptモデルを、1024、1280などの大きなimgsz、または元画像サイズに最も近い実用的な値で再テストしてください。低解像度の入力では、予測クラスマップに含まれていなかった細部を復元できないため、.ptの出力が許容できることを確認してから、エクスポート済みモデルを使用してください。
インスタンスセグメンテーションとセマンティックセグメンテーションの比較#
| 観点 | インスタンスセグメンテーション(task="segment") | セマンティックセグメンテーション(task="semantic") |
|---|---|---|
| 予測の目的 | 検出された各物体を個別にセグメント化する | すべてのピクセルに1つのクラスIDを割り当てる |
| 出力フィールド | result.masks | result.semantic_mask |
| 主なデータ | result.masks.data | result.semantic_mask.data |
| 形状 | (N,H,W) | (H,W) |
| ピクセル値 | バイナリマスク値: 0または1 | クラスID: 0、1、2、... |
| データ型 | torch.uint8 | torch.uint8torch.int16torch.int32 |
| 同じクラスの物体 | 個別のインスタンスとして保持 | 同じクラス領域に統合 |
| ポリゴン | はい。result.masks.xyとresult.masks.xynを通じて出力できます | いいえ。デフォルトではポリゴンを出力しません |
| ボックスと信頼度 | はい。result.boxesを通じて出力できます | インスタンスごとのボックスや信頼度スコアはありません |
| 一般的な用途 | カウント、トラッキング、クロップ、物体単位の測定 | 高密度なシーンラベリング、走行可能領域、土地被覆、医用画像の領域 |
エクスポート#
YOLO26n-semモデルをONNXやCoreMLなどの別の形式にエクスポートします。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-sem.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルをエクスポートする
model.export(format="onnx")使用可能なYOLO26のセマンティックセグメンテーション用エクスポート形式を以下の表に示します。format 引数を使用して、任意の形式にエクスポートできます(例:format='onnx' または format='engine')。エクスポート済みモデルに対して直接予測または検証を実行できます(例:yolo predict model=yolo26n-sem.onnx)。エクスポートが完了すると、モデルの使用例が表示されます。
| 形式 | format引数 | モデル | メタデータ | 引数 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, device |
| IMX500 | imx | yolo11n_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, quantize, batch, data, fraction, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-sem_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
| NXP | nxp | yolo26n-sem_nxp.tflite | ✅ | imgsz, quantize, data, fraction, device |
| ST Edge AI | stedgeai | yolo26n-sem_stedgeai.onnx | ✅ | imgsz, quantize, data, fraction, opset, simplify, device |
nms=None は、外部NMS用にデフォルトでraw出力を返します(YOLO26はAxelera上でNMSフリーヘッドを維持します)。利用可能なNMSフリーヘッドを選択するには、nms=Falseを設定します。非対応の形式では、ネイティブの出力経路にフォールバックします。上記のnmsの項目は、nms=Trueを使用してNMSを埋め込める形式を示しています。
詳細なexport情報については、Exportページをご覧ください。
よくある質問#
カスタムデータセットでYOLO26セマンティックセグメンテーションモデルをトレーニングするには、各ピクセル値がクラスID(0、1、2、...)を表し、値が255のピクセルはトレーニング中に無視されるPNGマスク画像を用意する必要があります。画像とマスクのディレクトリを指定するデータセットYAMLファイルを作成し、モデルをトレーニングします。
例from ultralytics import YOLO # 事前トレーニング済みのYOLO26セマンティックセグメンテーションモデルを読み込みます model = YOLO("yolo26n-sem.pt") # モデルをトレーニングする results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=1024)使用可能なその他の引数については、Configurationページをご覧ください。
インスタンスセグメンテーションとセマンティックセグメンテーションはいずれもピクセル単位のタスクですが、重要な違いがあります。
- セマンティックセグメンテーションはすべてのピクセルにクラスラベルを割り当てますが、同じクラスの個々のオブジェクトは区別しません。たとえば、シーン内のすべての車に同じクラスラベルを割り当てます。
- インスタンスセグメンテーションは個々のオブジェクトをそれぞれ識別し、同じクラスに属する場合でも、オブジェクトごとに異なるマスクを生成します。
セマンティックセグメンテーションは、自動運転や土地被覆マッピングなどのシーン理解タスクに最適です。一方、個々のオブジェクトのカウントや追跡が重要な場合は、インスタンスセグメンテーションが適しています。
はい。データセットでUltralytics YOLOのポリゴンラベル(画像ごとに1つの
.txt)を使用している場合は、データセットYAMLからmasks_dirを省略し、データセットのルートにある画像と同じ階層にmasks/フォルダーが存在しないことを確認してください(このフォルダーが存在するだけで、masks_dirが設定されていなくてもPNGマスクモードが有効になります)。ローダーはポリゴンを画像ごとのセマンティックマスクにオンザフライで変換します。マルチクラスデータセット(N > 1)では、追加のbackgroundクラスがnamesに自動的に追加されます。シングルクラスデータセット(N == 1)では、トレーニング時のクラス数は1のままです。宣言したクラスはマスク内で1になり、未カバーのピクセルは0になります。詳細については、セマンティックセグメンテーションデータセットガイドをご覧ください。Ultralytics YOLO26には、複数のセマンティックセグメンテーションデータセット向けの組み込み設定が用意されています。
- Cityscapes:自動運転研究で広く使用される、19クラスの都市の街路シーンです。
- ADE20K:150クラスを含む大規模なシーン解析データセットです。
ピクセル値がクラスIDに対応するPNGマスクアノテーションを含むカスタムデータセットも使用できます。
評価に使用するデータセットYAMLを使って、事前トレーニング済みのYOLO26セマンティックセグメンテーションモデルを検証します。
例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n-sem.pt") # モデルを検証します metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)これらの手順により、セマンティックセグメンテーションの性能評価に標準的に使われる平均交差領域(mIoU)やピクセル精度などの検証メトリクスが得られます。
PythonまたはCLIコマンドを使って、YOLO26セマンティックセグメンテーションモデルをONNX形式にエクスポートします。
例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n-sem.pt") # モデルをONNXフォーマットにエクスポート model.export(format="onnx")さまざまな形式へのエクスポートの詳細は、Exportページをご覧ください。


コメント1
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
RizwanMunawar(編集済み)
Ultralytics just dropped semantic segmentation support 🤯
Ultralytics YOLO now supports semantic segmentation, a pixel-level classification task that assigns a class label to every pixel in an image, generating a dense map of the entire scene.
Unlike instance segmentation, which distinguishes between individual objects, semantic segmentation groups all pixels belonging to the same class under a single label. The result is an H×W class map where each pixel value represents a predicted class ID.
Ideal for autonomous driving, medical imaging, and land-cover mapping.
https://github.com/user-attachments/assets/1a1da64c-5459-4607-910e-a476b0b02781
CC: @jing-qiu @lmycross @glenn-jocher @kayselmecnun @fatih @raimbekovm @mohammed-yasin
13