Ultralytics YOLOによる単眼深度推定#
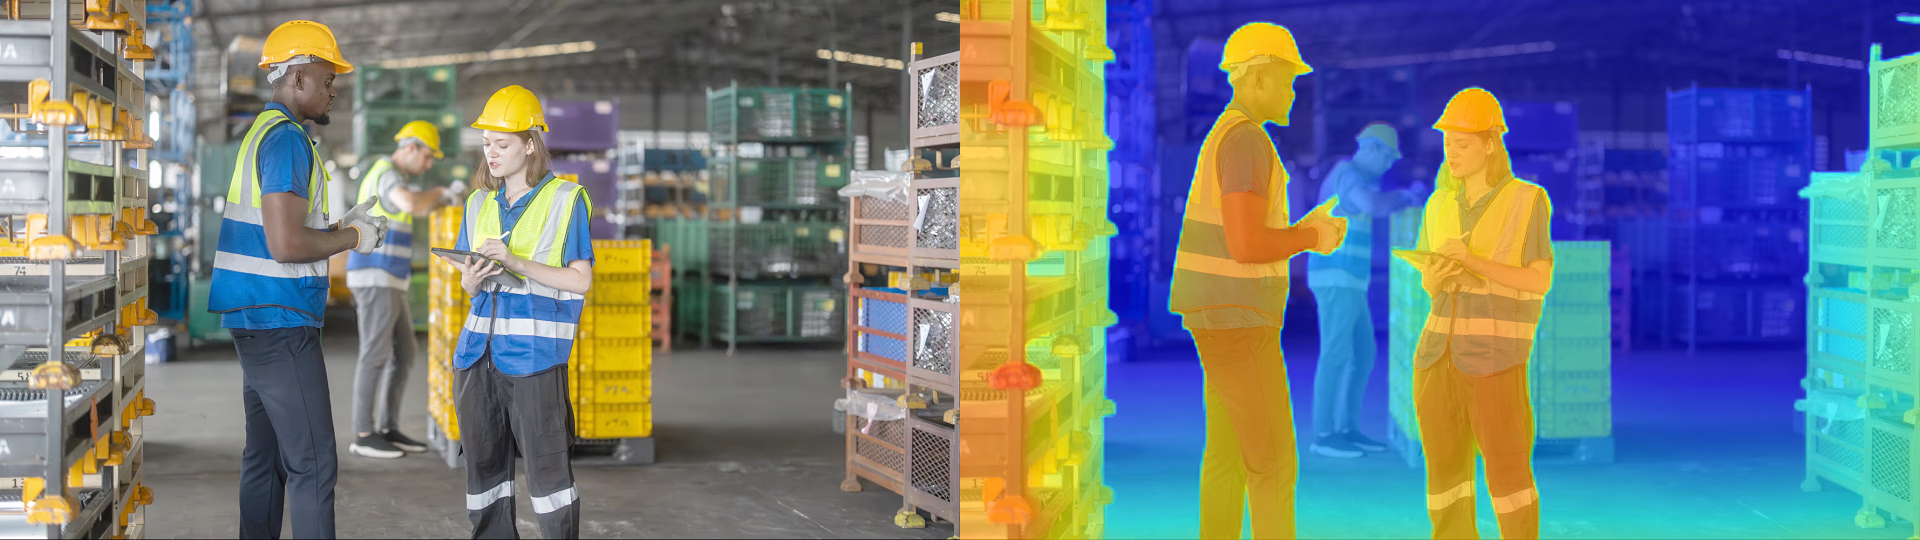
単眼深度推定では、単一のRGB画像からピクセルごとの深度マップを予測します。出力の各ピクセルには、カメラからその表面上の点までの推定距離を表す深度値がメートル単位で格納されます。
深度モデルの出力は、入力画像に位置合わせされた形状(H, W)の高密度な浮動小数点マップです。このピクセル単位の表現により、単眼深度推定は3Dシーン再構築、ロボットナビゲーション、AR/VRコンテンツ作成など、単一カメラから空間配置を把握する必要があるあらゆる用途に適しています。
視聴: Ultralytics YOLO26 による単眼深度推定 | Python チュートリアル | Vision AI 🚀
単眼深度推定には、task=depthまたはyolo depth CLIタスクを使用します。YOLO26の深度モデルファイルには-depthのサフィックスが付いています。たとえば、yolo26n-depth.ptのようになります。
モデル#
幅広い複数データセットの組み合わせ(屋内+屋外、~219万枚の画像)で事前トレーニングされたYOLO26深度モデルを以下に示します。メトリクス列は、NYU Depth V2のEigenテスト分割で測定した値です。
モデルは、初回使用時に最新のUltralytics リリースから自動的にダウンロードされます。
| モデル | サイズ (ピクセル) | delta1NYU | abs_relNYU | rmseNYU | 速度 CPU ONNX (ms) | 速度 T4 TensorRT10 (ms) | パラメーター (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYUは、NYU Depth V2のEigenテスト分割(654枚)で、マルチスケール+水平反転TTAと対数最小二乗アライメントを適用した場合に、予測深度が正解深度の1.25倍以内に収まるピクセルの割合です。
- TTAを使用しない単一スケールの精度は、
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0を使って再現できます(各サイズにはmodel=を代入します)。この方法では中央値(スケールのみ)によるアライメントを使用し、スコアは低くなります。delta1は、nで0.783、sで0.793、mで0.840、lで0.853、xで0.860です。 - abs_relは、予測された深度値と正解深度値の間の平均絶対相対誤差です。
- rmseは、メートル単位の二乗平均平方根誤差です。
- 速度は、
imgsz=768、batch=1で測定した推論のみのレイテンシ(前処理・後処理を除く)で、ウォームアップ後の計測実行における平均±標準偏差です。CPU ONNXは32コアのIntel Xeon(Skylake)でのONNX Runtime fp32です。T4 TensorRT10はTesla T4でのTensorRT fp16です。 - paramsとFLOPsは、公開済みの重みのトレーニング解像度である768×768で測定しています。
予備的なNYU Depth V2の結果については、未公開のYOLO27プレビューをご覧ください。
Depth Anything V2との速度比較#
Depth Anything V2は、単眼深度推定で広く使われているオープンなベースラインです。DINOv2のビジョントランスフォーマーバックボーンとDPTデコーダーは計算負荷が高いため、同じTesla T4上でTensorRT fp16を使用した場合、公開済みのDepth Anything V2モデルのうち最小のモデルでも、パラメーター数が2倍以上のYOLO26x-depthを含む、すべてのYOLO26深度モデルより低速です。
~768 pxの場合 — YOLO26ではimgsz=768(公開済みの重みがトレーニングされた解像度)、Depth Anything V2では770 pxです。Depth Anything V2のDINOv2バックボーンでは、パッチサイズ14の倍数が必要です。
| モデル | パラメーター数(M) | FLOPs(B) | T4 TensorRT10(ms) | FPS | V2 Smallに対する高速化倍率 | V2 Baseに対する高速化倍率 |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
~640 pxの場合 — それぞれimgsz=640と644 pxです。モデルの順位は変わらず、YOLO26n-depthはDepth Anything V2 Smallより5.9倍高速です。
| モデル | T4 TensorRT10(ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- レイテンシは推論のみで、
batch=1、Tesla T4上のTensorRT fp16を使用しています。上記のモデル表と同じ計測環境で、小数点以下2桁まで示しています。FPSは丸め前のレイテンシの逆数です。高速化倍率の列は、Depth Anything V2 Small(20.99 ms)およびBase(55.40 ms)のレイテンシをYOLO26のレイテンシで割った値です。 - Depth Anything V2 SmallとBaseは、公開済みのViT-SおよびViT-Bチェックポイントです。
- この比較の対象はレイテンシのみです。ここでは、2つのモデルファミリーを共通の精度評価プロトコルで評価していません。
深度範囲と対数深度ヘッド#
深度ヘッドはexp(logit)を予測します。これは上限がなく(~0.02~150 m)、シーン形状と絶対スケールを分離します。ネットワークは相対的な対数深度フィールドを予測し、絶対的なメートル値は、評価時に推定するか、軽量なキャリブレーションまたはファインチューニングで求める、2パラメーターの別個の変換(exp(a·log d + b))によって設定します。一般的な代替手法である上限付きのsigmoid × max_depthヘッドでは、固定の上限値がアーキテクチャに組み込まれます。そのため、max_depthを超える深度はすべてクリップされ、より長距離のシーンでのトレーニングと予測ができません。
条件を揃えたA/Bテスト — データとスケジュールは同一で、ヘッドのみを変更。屋内(≤10 m)と屋外(≤80 m)のデータを同じ比率で組み合わせ、両方のヘッドをスクラッチからトレーニングします。
| ヘッド | 出力範囲 | 混合範囲の検証δ1 | トレーニング時の挙動 |
|---|---|---|---|
sigmoid × max_depth(10 m) | 上限付き、0~10 m | 0.221 | エポック1で頭打ち |
log(上限なし) | 0–~150 m | 0.367 (+66%) | 全期間にわたって改善 |
上限付きヘッドでは、屋外ピクセルの大半を占める10 m超の深度を表現できないため、ほぼすぐに改善が止まります。一方、logヘッドは全範囲から学習します。
解決する失敗モード — 深度範囲で層別化した、単一データセットでのファインチューニング。上限付き(10 m)ヘッドを個々のデータセットでファインチューニングした場合、データが上限内なら機能しますが、上限を超えると性能が大幅に低下します。
| データセット | 深度範囲 | 上限付きヘッドのδ1 |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | 大半が≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌(abs_rel ≈ 7.0 — 80/10のスケール不一致) |
| vKITTI2 | 80 m | 0.04 ❌ |
性能の崩壊は、上限の境界で正確に発生します。logヘッドには、そのような境界がありません。
公開済みモデル — 範囲をまたいだ性能。提供中のlogヘッドのモデルファミリーについて、10 m(NYU、iBims-1)から80 m(KITTI)までのベンチマークで、スケールを揃えたδ1を評価しました。
| ベンチマーク | 範囲 | YOLO26x-depth(log) | 以前公開された上限付きモデル |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| 平均 | — | 0.819 | 0.799 |
両方の列は公開済みの値です。その他の行は、各データセットのページに記載されたTTAと対数最小二乗プロトコルで評価していますが、このリポジトリのバリデーターはそのプロトコルを実装していません。そのため、KITTIの行を同じ条件で再測定することはできません。KITTIのページには、標準的な652フレームのEigen分割で測定した値が掲載されています。
最大の改善は、より長距離の屋外ベンチマーク(KITTI、ETH3D)で見られます。ここは固定の10 m上限が最も大きな影響を与える範囲です。屋内での性能は維持されています。
学習#
Depth8データセットでYOLO26n-depthを100エポック、画像サイズ640でトレーニングします。使用可能な引数の一覧については、設定ページをご覧ください。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-depth.yaml")  # YAMLから新しいモデルを構築します
model = YOLO("yolo26n-depth.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # YAMLからモデルを構築し、重みを転送します

# モデルをトレーニングする
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)Trainページでtrainモードの詳細をご覧ください。深度モデルは、Ultralytics Platformのクラウドトレーニングでもトレーニングできます。
データセットのフォーマット#
深度推定データセットでは、各RGB画像に、スケーリング済みのuint16深度PNGまたはメートル単位の浮動小数点NPY深度マップを対応付けます。PNGの値はデフォルトでミリメートル単位です。別の規則を使用するデータセットでは、YAMLにdepth_scaleを設定します。ローダーはimagesの部分をdepthに置き換えて深度ファイルのパスを生成し、.pngを優先して、存在しない場合は.npyにフォールバックします。
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
└── val/たとえば、images/train/scene_001.jpgにある画像には、depth/train/scene_001.pngにある深度マップが対応します。形式の詳しい仕様については、深度推定データセットガイドをご覧ください。
独自データでのファインチューニング#
事前トレーニング済みの深度モデルをカスタムデータセットに適応させる場合は、学習率を下げ、AdamWオプティマイザーを使用してください。デフォルトのオプティマイザー設定はスクラッチからのトレーニング向けに調整されています。すでに収束した深度モデルにその設定を適用すると、事前学習済みの知識が上書きされ、結果が悪化する可能性があります。特に、単一ドメインでファインチューニングする場合に顕著です。
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # 事前学習済みの重みから開始

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # スクラッチ学習時のデフォルト値より約100倍低く設定
    warmup_bias_lr=1e-4,  # ウォームアップも緩やかに設定
)
追加のヒント:
- データ拡張は標準の引数で制御します(
degrees、translate、scale、shear、perspective、flipud、fliplr、hsv_h、hsv_s、hsv_v)。幾何学的なワープと反転は、ペアになった深度マップにも同じように適用されます。リリース済みのYOLO26-Depthの重みに使用された正確なレシピを確認するには、チェックポイントに保存されたtrain_argsを調べてください。詳しくはYOLO26チェックポイントの学習引数を確認するをご覧ください。 - 深度推定では
mosaic、mixup、cutmix、copy_pasteは実装されていません。 深度データセットローダーはこれらの確率を自動的に0に設定するため、指定しても効果はありません。これらのデータ拡張は複数の画像を組み合わせるため、ペアになった深度マップが無効になることからサポートされていません。 - 深度範囲はそのまま使用できます。
logヘッドのモデルは範囲に制限のない深度を予測するため、変更を加えずに近距離(マクロ撮影)または遠距離(屋外/運転)データに適応します。データセットYAMLでmax_depth:を設定すると(メートル単位)、検証指標の対象となるGTピクセルの範囲を指定できます。 - 汎用的な性能を維持します。 学習データセット以外のシーンでもモデルの精度を維持する必要がある場合は、多様な汎用画像を少量(~5–10%)学習データに混ぜてください。ファインチューニング中の忘却を大幅に抑えられます。
- スクラッチから学習(
model=yolo26s-depth.yaml)するのは、対象ドメインが大きく異なり、かつ大規模なデータセットがある場合に限ってください。その場合は保持すべき事前学習済みの重みがないため、デフォルトのoptimizer=autoが適切です。
深度スケールのキャリブレーション#
深度ヘッドは形状(シーンの相対的な構造)とスケール(メートル単位の絶対値)を分離します。モデルが対象シーンの相対深度を適切に予測しているものの、使用するカメラに対して絶対値がずれている場合は、model.calibrate()を使って数秒でスケールを補正できます。これは、少量のラベル付きデータセットに対してヘッドの対数アフィン変換をスケールのみで閉形式適合する方法で、交差検証でのホールドアウトδ1が改善した場合にのみ適用されます。勾配による学習もネットワーク重みの変更もないため、相対構造の精度が低下することはありません。
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# ラベル付きの分割データ(約100枚以上で十分)でスケールを適合し、適用する
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")キャリブレーションでは適合にグラウンドトゥルース深度が必要なため、ラベル付きデータの分割で実行します。ラベルなしの推論時には実行できません。検証指標の評価対象と同じピクセルで適合とスコア計算を行います。データセットYAMLのmax_depth(デフォルトは100 m)以上のGTは除外されます。相対深度がすでに適切で、スケールや範囲だけが不正確な場合に使用してください。対象ドメインに合わせて相対構造自体を変更する必要がある場合は、代わりにファインチューニングを行ってください。
学習ではこの処理が自動的に実行されます。model.train(...)の完了後、bestおよびlastチェックポイントが検証セットでキャリブレーションされ、メートル単位にスケーリングされた深度をそのまま出力します。
リリース済みのyolo26*-depth.ptチェックポイントには、このキャリブレーションが事前学習の検証データの混合セットで適合された状態で組み込まれています。これはすべてのドメインで共通の単一のグローバルスケールです。そのため、特定のカメラやシーンタイプで絶対深度の精度を最大限に高めるには、独自データの少量のラベル付き分割データでmodel.calibrate()を実行してください。これにより、組み込み済みの適合結果が置き換えられます。
深度カメラを使わずに正解深度を取得する方法#
カメラに深度センサーがなくても、キャリブレーションは可能です。キャリブレーションではグローバルスケールを1つだけフィッティングし、深度が0のピクセルは無視するため、画像ごとに実測点が数点あれば十分です。
-
画像を収集します。 使用するカメラを、導入時と同じ解像度およびレンズ設定にして50〜150枚の画像を撮影し、
dataset/images/val/に保存します。キャリブレーションではvalのsplitを読み込みます。 -
深度をラベル付けします。 以下の2つの方法のいずれかを使用します。どちらの方法でも、データセット形式に従って、画像ごとに1つの深度マップを
dataset/depth/val/に書き込みます。
レーザー距離計または巻尺を使って、物体の端から離れた平坦な面上の各画像内の数点までの距離を測定し、各点のピクセル位置をpoints.csvに記録します。
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672次に深度マップを書き込み、実測していないピクセルはすべて0のままにします。各点は小さなドットとして描画されるため、imgszへのリサイズ後も残ります。
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
cv2.imwrite(str(out), depth)距離計で測定するのは点までの直線距離ですが、深度マップに格納されるのはカメラの視線軸に沿った距離です。この2つは画像の中央では一致し、中央から15°離れた位置では約3.5%異なるため、中央付近の点を測定するか、カメラの内部パラメーターを使ってmeters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2)で各測定値を変換してください。
-
データセットYAMLを
calib.yamlとして書き込みます。depth_scale: 100は実測点から作成したセンチメートル単位のPNGを読み込み、NPYマップの場合は無視されます。path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
キャリブレーションを実行して保存し、予測またはエクスポートには
yolo26s-depth-calibrated.ptを読み込みます。from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
yolo26s-depth.ptを使い、カメラごとに150枚の画像でテストしたところ、リリース済みのキャリブレーションは、NYU、KITTI、および狭角レンズのカメラにおいて、完全な正解データに基づくスケールフィッティングに対して4〜46%の誤差がありました。画像ごとに5つの実測点を使ってキャリブレーションすると、そのフィッティングとの差は1%以内となり、DA3METRIC-LARGEのラベルを使った場合は7%以内となりました。画像ごとの点数を増やすより、画像数を増やす方が効果的です。1点ずつ使用した150枚の画像では誤差が約3%以内でしたが、5点ずつ使用した20枚の画像では最大9%の差が生じました。
検証#
深度推定データセットで、学習済みYOLO26n-depthモデルの精度を検証します。検証で意図したデータセットYAMLが使われるように、dataを明示的に指定してください。リリース済みの重みは、パディングを加えるレターボックス処理ではなく、画像を正方形に引き伸ばしてimgsz=768のサイズで学習されています。そのため、最高の精度を得るには、そのサイズで検証と予測を行ってください。予測、検証、model.calibrate()はいずれも入力を同じ方法で引き伸ばします。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-depth.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルを検証します
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # しきい値δ=1.25以内のピクセルの割合
metrics.abs_rel  # 平均絶対相対誤差
metrics.rmse  # 二乗平均平方根誤差(メートル)
metrics.silog # スケール不変対数誤差推論#
学習済みのYOLO26n-depthモデルを使用して、画像の予測を実行します。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-depth.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルで予測します
results = model("https://ultralytics.com/images/bus.jpg")  # 画像に対して予測します

# 結果にアクセスします
for result in results:
depth_map = result.depth.data.cpu().numpy() # torch.Tensor → NumPy float32、形状 (H, W)、単位はメートルPredictページでpredictモードの詳細をご確認ください。
結果の出力#
YOLOの深度推定では、画像ごとに1つのResultsオブジェクトが返されます。各結果には、画像全体を対象とする1つの密な浮動小数点深度マップが格納されます。
| 属性 | 種類 | 形状 | 説明 |
|---|---|---|---|
result.depth | DepthMap | (H,W) | ピクセルごとの高密度深度マップです。 |
result.depth.data | torch.Tensor | (H,W) | 深度の値はメートル単位です。NumPyの場合は.cpu().numpy()を呼び出します。 |
result.boxes | - | - | インスタンスボックスはありません。 |
result.masks | - | - | インスタンスマスクはありません。 |
すべてのタスクにおける、タスク固有のResultsフィールドについては、タスク別の予測結果セクションをご覧ください。
インスタンスセグメンテーションによるオブジェクトごとの深度#
インスタンスセグメンテーションと深度を組み合わせることで、検出された各オブジェクトまでの距離を推定できます。retina_masks=Trueを使って両方のモデルを同じ画像に対して実行し、マスクを深度マップの元画像と同じ解像度にしたうえで、各マスク内の有効な深度ピクセルの中央値を求めます。
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
print(f"{seg.names[int(cls)]}: {values.median():.2f} m")中央値を使うとマスクの端にある背景ピクセルの影響を受けにくくなりますが、オブジェクトの中心ではなく可視表面を表し、精度はモデルの深度スケールに依存します(深度スケールのキャリブレーションを参照してください)。
深度マップのカラー化#
生の深度マップはメートル単位の単一チャンネル浮動小数点配列です。計算には便利ですが、そのままでは読み取りにくい形式です。カラー画像に変換するには、ultralytics.utils.plottingのcolorize_depthヘルパーを使います。このヘルパーは(H, W)深度配列を(H, W, 3) BGR uint8画像に変換します(無効なピクセル<= 0は黒で表示されます)。
result.plot()はデフォルト値(cmap="jet"、mode="disparity")を使って、このカラー化を入力画像にすでにブレンドしています。単独のカラー深度画像や、別のカラーマップまたは正規化を使用する場合は、colorize_depthを直接呼び出してください。
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# 近距離を暖色でカラー化して保存
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# 範囲を0~20 mに固定し、フレーム間で同じ色が同じ距離を表すようにする
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Resultsオブジェクトから直接ブレンドしたオーバーレイ(cmap="jet"、mode="disparity"を使用)
result.save("depth_overlay.png")すべてのカラーマップは寒色/暗色から暖色/明色へ変化します。modeで近距離に対応する色端を決め、vmin/vmaxでフレーム間の範囲を固定すると、常に同じ色が同じ距離を示します。
| 引数 | 値 | 説明 |
|---|---|---|
cmap | jet(デフォルト) | コントラストの高い青→緑→赤の配色で、result.plot()が使用します。 |
cmap | inferno | 黒→紫→オレンジ→黄の配色です。知覚的に均一で、色覚多様性に配慮しており、グレースケールでも読み取れます。 |
cmap | spectral | 赤→黄→緑→青の配色です(matplotlibのSpectral_r)。 |
mode | disparity(デフォルト) | 逆深度(1/d)を2パーセンタイルから98パーセンタイルの範囲で正規化します。暖色が近距離を示し、遠距離の外れ値は範囲に含まれません。 |
mode | metric | メートル単位の深度をvminからvmaxまで線形に正規化します。暖色が遠距離を示すため、色は実際の距離に対応します。 |
エクスポート#
YOLO26n-depthモデルをONNX、CoreMLなどの別の形式にエクスポートする
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-depth.pt")  # 公式モデルを読み込みます
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルをエクスポートする
model.export(format="onnx")利用可能なYOLO26の深度推定エクスポート形式を以下の表に示します。format引数を使って任意の形式にエクスポートできます(例:format='onnx'またはformat='engine')。エクスポート済みモデルを使って直接予測または検証することもできます(例:yolo predict model=yolo26n-depth.onnx)。エクスポートが完了すると、モデルの使用例が表示されます。
| 形式 | format引数 | モデル | メタデータ | 引数 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None は外部NMS向けにraw出力をデフォルトで使用します。利用可能なNMSフリーヘッドを選択するには、nms=Falseを設定してください。未対応のフォーマットでは、ネイティブの出力パスにフォールバックします。上記のnmsの項目は、nms=Trueを使用してNMSを埋め込めるフォーマットを示しています。
詳細なexport情報については、Exportページをご覧ください。
よくある質問#
ペアになったRGB画像と、16ビット深度PNGまたはメートル単位の浮動小数点NPY深度マップを用意し、
images/ディレクトリを参照するデータセットYAMLを作成します。ローダーはパス内のimagesをdepthに置き換えて深度ファイルを自動的に検索し、.pngを優先して、見つからない場合は.npyを使用します。事前学習済みの重みから開始し、AdamWと低い学習率を使用して、モデルがすでに習得した内容をファインチューニング後も保持します(理由については独自データでのファインチューニングをご覧ください)。
例from ultralytics import YOLO # 事前学習済みのYOLO26深度モデルを読み込む model = YOLO("yolo26s-depth.pt") # カスタム深度データセットでファインチューニングする results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )使用可能なその他の引数については、Configurationページをご覧ください。
深度推定の検証では、Depth Anythingや関連する単眼深度推定研究で使われている指標一式が報告されます。
- delta1 / delta2 / delta3 — 予測深度とグラウンドトゥルース深度の比(またはその逆数)が、それぞれ1.25、1.25²、1.25³未満であるピクセルの割合です。値が大きいほど優れています。
- abs_rel — 平均絶対相対誤差です。値が小さいほど優れています。
- rmse — メートル単位の二乗平均平方根誤差です。値が小さいほど優れています。
- silog — スケール不変対数誤差です。値が小さいほど優れています。
各予測は画像ごとにグラウンドトゥルースに対して中央値でアラインメントされ、各指標はその画像上で算出されます。画像ごとの結果を検証セット全体で平均するため、有効な深度ピクセル数にかかわらず各画像の重みは同じです。有効なグラウンドトゥルースピクセルが10未満の画像は、わずかなピクセルの中央値をアラインメントしても意味がないためスキップされ、平均には含まれません。有限でない予測値は深度の上限・下限を使ってスコア化されます。これはDepth Anything V2で使用されるサンプル単位の平均化と、10ピクセルの下限に準拠しています。
深度マップは形状
(H, W)のtorch.Tensorとして保存され、各値はメートル単位の予測深度を表します(NumPyのfloat32配列にはresult.depth.data.cpu().numpy()を使用してください)。予測の実行後にresult.depth.dataを通じてアクセスできます。マップは入力画像の解像度にアラインメントされています。Ultralytics YOLO26には、NYU Depth V2、KITTI、Hypersim、SUN RGB-D、ARKitScenesなど、複数の深度推定データセット用のデータセットYAML設定が組み込まれています。全リストと形式の詳細については、深度推定データセットガイドをご覧ください。
事前学習済みのYOLO26深度モデルを検証するには、評価に使用するデータセットYAMLを指定します。
例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n-depth.pt") # モデルを検証します metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)PythonまたはCLIを使ってYOLO26深度モデルをONNXにエクスポートします。
例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n-depth.pt") # モデルをONNXフォーマットにエクスポート model.export(format="onnx")さまざまな形式へのエクスポートの詳細は、Exportページをご覧ください。