MNIST 데이터셋#
MNIST 데이터셋은 손글씨 숫자 10개 클래스(숫자 0~9)에 걸쳐 있는 28x28 그레이스케일 이미지 70,000개로 구성된 이미지 분류 벤치마크입니다. 사전 정의된 분할에 따라 학습 이미지 60,000개와 테스트 이미지 10,000개가 제공되며, 오랫동안 머신 러닝 및 컴퓨터 비전 알고리즘을 평가하는 표준 벤치마크로 사용되어 왔습니다. 더 어려운 의류 이미지 대체 데이터셋은 관련 Fashion-MNIST 데이터셋을, 컬러 이미지는 CIFAR-10을 참조하십시오.
Ultralytics Platform의 MNIST를 살펴보고 샘플을 미리 확인하고, 데이터셋 통계를 검사하며, 학습을 위해 클론할 수 있습니다.
주요 기능#
- MNIST에는 손글씨 숫자 이미지가 학습용 60,000개와 테스트용 10,000개, 총 70,000개 포함되어 있습니다.
- 각 이미지는 단일 숫자를 나타내는 28x28 그레이스케일 이미지이며, 정규화 및 안티앨리어싱 처리를 거쳐 고정된 28x28 바운딩 박스에 맞춰집니다.
- 10개 클래스는 숫자 0~9로 구성되며, 클래스별 이미지 수는 대체로 균형을 이룹니다.
- 사전 정의된 학습/테스트 분할이 제공되므로 수동 또는 자동 분할이 필요하지 않습니다.
- MNIST는 이미지 분류 및 딥러닝 연구를 위한 표준 벤치마크입니다.
데이터셋 구조#
MNIST에는 공식 사전 정의 분할이 제공되므로 자동 또는 수동 파티셔닝이 필요하지 않습니다:
- 클래스: 10개(손글씨 숫자 0~9)
- 전체 이미지: 70,000개 (28x28 그레이스케일)
- 학습 세트: 이미지 60,000개
- 테스트 세트: 이미지 10,000개
MNIST에는 별도의 검증 폴더가 없으므로 Ultralytics는 기본적으로 학습 중 10,000개의 테스트 이미지 세트를 검증 분할로 사용합니다.
각 이미지에는 해당 숫자(0~9) 라벨이 지정되어 있으므로 MNIST는 분류 작업에 적합한 지도 학습 데이터셋입니다.
응용 분야#
MNIST는 이미지 분류 모델을 학습하고 평가하는 데 널리 사용되며, 기존의 합성곱 신경망 (CNNs)과 서포트 벡터 머신 (SVMs)부터 최신 딥 아키텍처까지 다양한 모델에 적용됩니다. 작은 그레이스케일 이미지와 10개 숫자 클래스로 구성되어 있어 알고리즘 비교 및 컴퓨터 비전 실험을 위한 빠르고 재현 가능한 벤치마크로 활용됩니다.
일반적인 애플리케이션은 다음과 같습니다:
- 새로운 분류 알고리즘 벤치마킹
- 머신 러닝 개념 교육을 위한 교육용 활용
- 이미지 인식 시스템 프로토타이핑
- 모델 최적화 기법 테스트
사용법#
이미지 크기 28로 100 에포크 동안 MNIST에서 YOLO 분류 모델을 학습합니다. 데이터셋은 처음 사용할 때 자동으로 다운로드되고 캐시됩니다. 전처리를 완전히 직접 제어하려는 경우 MNIST 데이터베이스에서 원본 gzip 아카이브도 사용할 수 있습니다. 사용 가능한 인수의 전체 목록은 학습 페이지와 이미지 분류 작업 가이드를 참조하십시오.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="mnist", epochs=100, imgsz=28)Ultralytics는 data="mnist160"도 제공합니다. 이는 학습 및 테스트 분할에서 각 숫자(0~9)의 처음 8개 이미지를 포함하는 160개 이미지 슬라이스입니다. MNIST 디렉터리 구조를 그대로 따르므로 다른 인수를 변경하지 않고도 데이터셋을 교체할 수 있으며, 전체 70,000개 이미지 데이터셋을 사용하기 전에 CI 파이프라인이나 기본 점검에 적합합니다.
yolo classify train data=mnist160 model=yolo26n-cls.pt epochs=5 imgsz=28샘플 이미지 및 주석#
MNIST 데이터셋의 샘플 이미지:
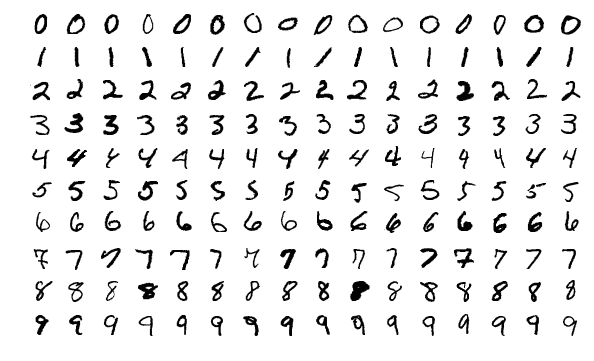
샘플은 데이터셋이 10개 숫자 클래스에서 포착하는 다양한 필기 스타일을 보여줍니다.
인용 및 감사의 글#
연구 또는 개발 작업에서 MNIST 데이터셋을 사용하는 경우 다음 논문을 인용해 주십시오:
@article{lecun2010mnist,
         title={MNIST handwritten digit database},
         author={LeCun, Yann and Cortes, Corinna and Burges, CJ},
         journal={ATT Labs [Online]},
         volume={2},
         year={2010}
}
머신 러닝 및 컴퓨터 비전 연구 커뮤니티를 위한 귀중한 리소스인 MNIST 데이터셋을 만들고 유지 관리한 Yann LeCun, Corinna Cortes, Christopher J.C. Burges에게 감사의 뜻을 표합니다. MNIST 데이터셋과 제작자에 대한 자세한 내용은 MNIST 데이터셋 웹사이트를 방문하십시오.
FAQ#
MNIST에는 손글씨 숫자 0~9에 해당하는 10개 클래스와 총 70,000개의 그레이스케일 이미지가 있으며, 각 이미지의 크기는 28x28 픽셀입니다. 학습 이미지 60,000개와 테스트 이미지 10,000개로 구성된 사전 정의 분할이 제공되며, 숫자별 샘플 수는 대체로 균일합니다.
MNIST에서 Ultralytics YOLO 모델을 학습하려면 아래 코드 스니펫을 사용하십시오. 데이터셋은 처음 사용할 때 자동으로 다운로드됩니다. 사용 가능한 학습 인수의 자세한 목록은 학습 페이지를 참조하십시오.
학습 예제from ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="mnist", epochs=100, imgsz=28)MNIST에는 학습 이미지 60,000개와 테스트 이미지 10,000개로 구성된 사전 정의 분할이 제공됩니다. Ultralytics가 자동으로 분할하는 폴더 기반 분류 데이터셋과 달리 MNIST의 공식 파티션은 그대로 사용되며, 기본적으로 학습 중 테스트 세트가 검증 분할로 사용됩니다.
MNIST 데이터셋에는 손글씨 숫자만 포함되는 반면, 확장 MNIST (EMNIST) 데이터셋에는 숫자와 대문자 및 소문자가 모두 포함됩니다. EMNIST는 MNIST의 후속 데이터셋으로 개발되었으며 동일한 28x28 픽셀 형식을 사용하므로 원본 MNIST 데이터셋용으로 설계된 도구 및 모델과 호환됩니다. 더 다양한 문자를 포함하므로 EMNIST는 더욱 폭넓은 머신 러닝 애플리케이션에 유용합니다.
예. Ultralytics Platform을 사용하면 광범위한 코딩 없이 데이터셋을 업로드하고 이미지 분류 모델을 학습하며 배포할 수 있습니다. 클라우드에서 MNIST 실험을 실행하는 편리한 방법이며, 관련 옵션은 분류 데이터셋 개요를 참조하십시오.
MNIST는 CIFAR-10이나 ImageNet과 같은 많은 최신 데이터셋보다 단순하므로 초보자와 빠른 실험에 적합합니다. 더 복잡한 데이터셋은 컬러 이미지와 다양한 객체 카테고리로 더 큰 도전 과제를 제공하지만, MNIST는 단순성, 작은 파일 크기, 머신 러닝 알고리즘 개발에서의 역사적 중요성 때문에 여전히 가치가 있습니다. 동일한 구조를 유지하면서 더 어려운 대체 데이터셋은 숫자 대신 의류 항목을 포함하는 Fashion-MNIST를 참조하십시오.