使用 DeepStream SDK 和 TensorRT 在 NVIDIA Jetson 上运行 Ultralytics YOLO26#
观看: 如何在 Jetson Orin NX 上通过 NVIDIA Deepstream 使用 Ultralytics YOLO26 模型 🚀
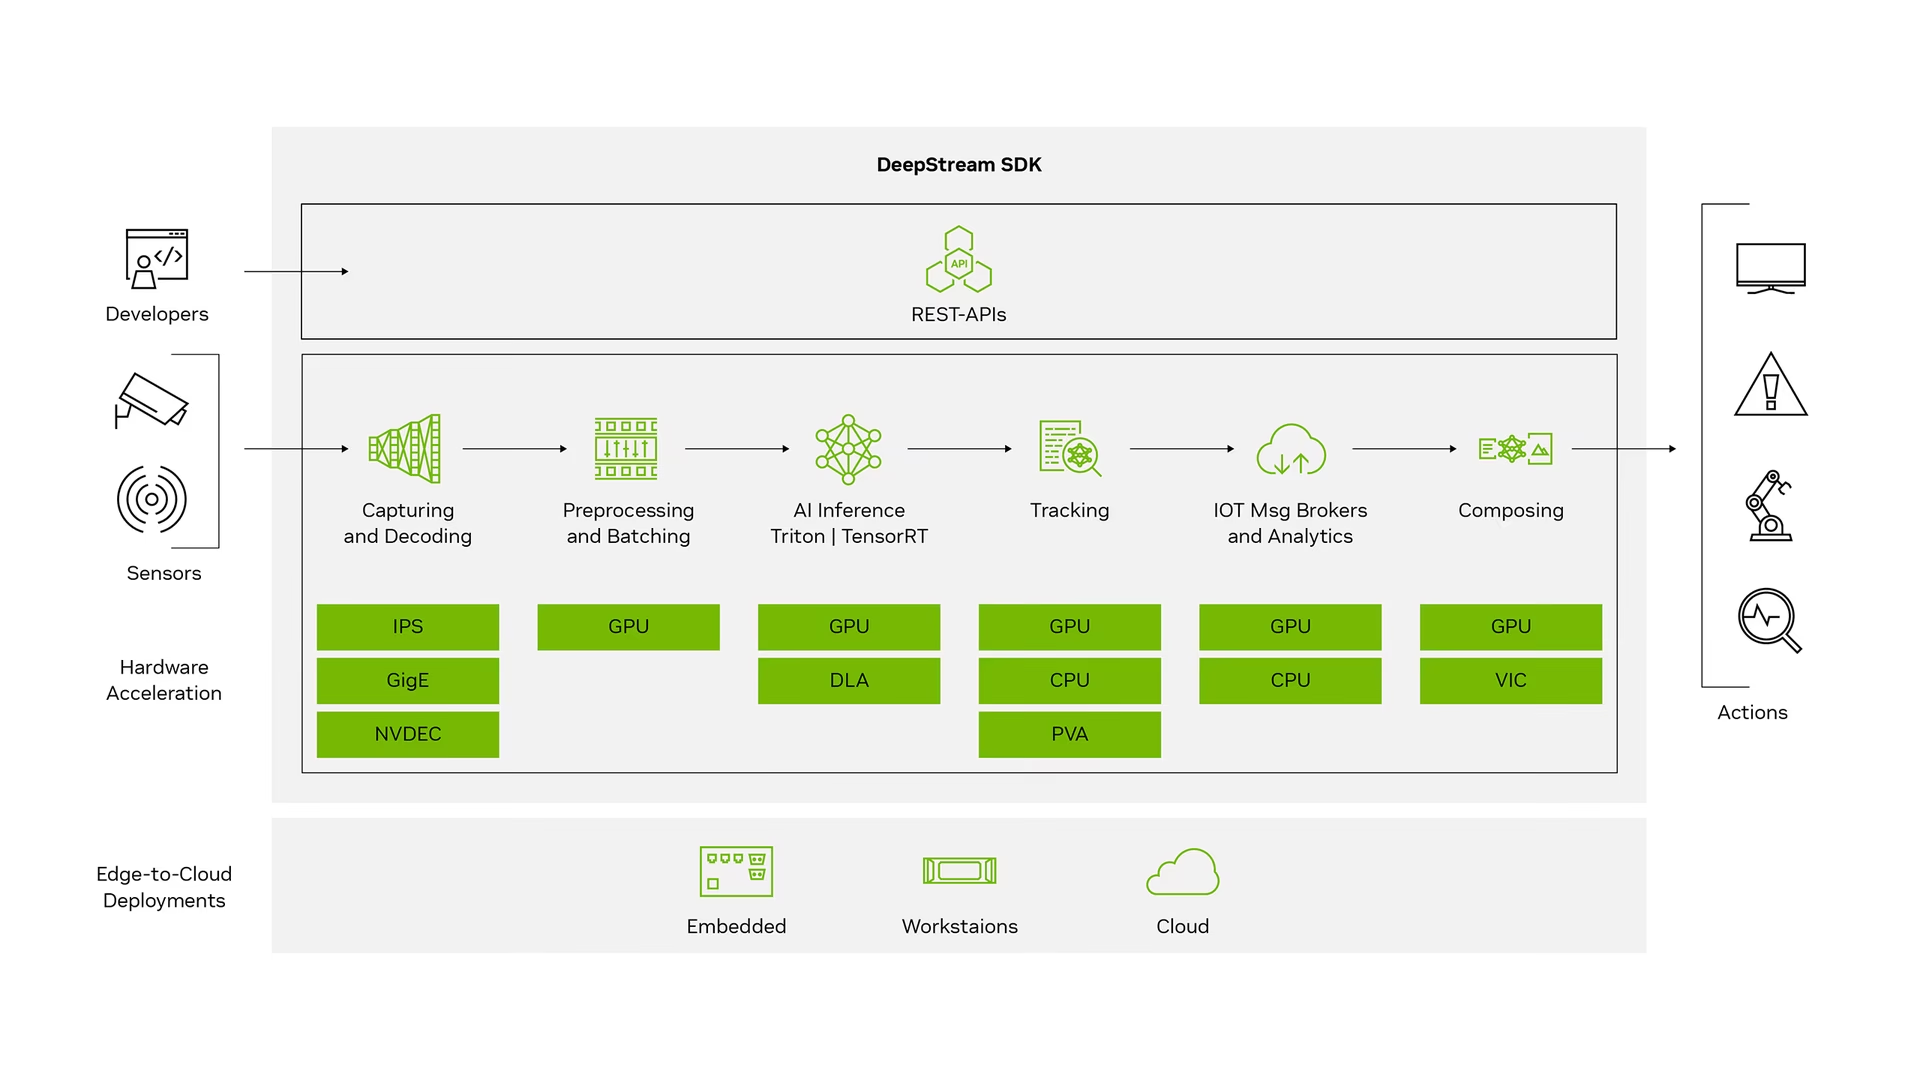
本指南全面详细地介绍了如何使用 DeepStream SDK 和 TensorRT 在 NVIDIA Jetson 设备上部署 Ultralytics YOLO26。我们在这里使用 TensorRT,以最大限度地提升 Jetson 平台上的推理性能。
本指南将带你了解 YOLO26 的 DeepStream 配置、INT8 校准、多流设置和基准测试结果。
本指南已在运行 JetPack JP6.1 版本的 NVIDIA Jetson Orin Nano Super Developer Kit、基于 NVIDIA Jetson Orin NX 16GB 且运行 JetPack JP5.1.3 版本的 Seeed Studio reComputer J4012,以及基于 NVIDIA Jetson Nano 4GB 且运行 JetPack JP4.6.4 版本的 Seeed Studio reComputer J1020 v2 上进行测试。本指南预计适用于整个 NVIDIA Jetson 硬件系列,包括最新和旧款设备。
什么是 NVIDIA DeepStream?#
NVIDIA 的 DeepStream SDK 是一套基于 GStreamer 的完整流式分析工具包,适用于基于 AI 的多传感器处理、视频、音频和图像理解。它非常适合开发视觉 AI 应用和服务的开发者、软件合作伙伴、初创公司和 OEM 厂商。现在,你可以创建流处理管道,将神经网络与跟踪、视频编码/解码和视频渲染等复杂处理任务结合起来。这些管道能够对视频、图像和传感器数据进行实时分析。DeepStream 的多平台支持让你能够更快速、更轻松地在本地、边缘端和云端开发视觉 AI 应用和服务。
前置条件#
开始阅读本指南之前:
- 请访问我们的文档 快速入门指南:使用 Ultralytics YOLO26 的 NVIDIA Jetson,为你的 NVIDIA Jetson 设备配置 Ultralytics YOLO26
- 根据 JetPack 版本安装 DeepStream SDK
- 对于 JetPack 4.6.4,请安装 DeepStream 6.0.1
- 对于 JetPack 5.1.3,请安装 DeepStream 6.3
- 对于 JetPack 6.1,请安装 DeepStream 7.1
- 对于 JetPack 7.1,请安装 DeepStream 9.0
本指南采用 Debian 软件包方式在 Jetson 设备上安装 DeepStream SDK。你也可以访问 Jetson 上的 DeepStream SDK(存档),获取 DeepStream 的旧版本。
YOLO26 的 DeepStream 配置#
这里我们使用 marcoslucianops/DeepStream-Yolo GitHub 仓库,该仓库提供 NVIDIA DeepStream SDK 对 YOLO 模型的支持。感谢 marcoslucianops 的贡献!
-
安装 Ultralytics 及必要的依赖项
pip install ultralytics onnx onnxslim -
克隆 DeepStream-Yolo 仓库
cd ~ git clone https://github.com/marcoslucianops/DeepStream-Yolo -
从 YOLO26 项目下载你选择的 Ultralytics YOLO26 检测模型(.pt)。这里我们使用 yolo26s.pt。
wget https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26s.pt
你也可以使用自定义训练的 YOLO26 模型。
-
将模型转换为 ONNX,并写入
labels.txt文件,DeepStream 会从中读取类别名称from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # 创建了 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))
nms=False 会导出无 NMS 的检测头,而 agnostic_nms=True 会让每个检测结果只保留一个类别,这样 DeepStream 配置中的 cluster-mode=4(无聚类)就不会重复绘制边界框。添加 imgsz=1280 可更改推理尺寸(默认值:640);添加 batch=4 可将批次大小设为 4(导出的批次大小是静态的,因此必须与 DeepStream 配置中的 batch-size 匹配);添加 opset=12 可用于 TensorRT 8.2 或更早版本(DeepStream 6.0.1 及更早版本)。完整列表请参阅导出参数。
-
将生成的
.onnx模型文件和labels.txt文件复制到DeepStream-Yolo文件夹cp yolo26s.onnx labels.txt ~/DeepStream-Yolo cd ~/DeepStream-Yolo -
根据已安装的 JetPack 版本设置 CUDA 版本
对于 JetPack 4.6.4:
export CUDA_VER=10.2对于 JetPack 5.1.3:
export CUDA_VER=11.4对于 JetPack 6.1:
export CUDA_VER=12.6对于 JetPack 7.1:
export CUDA_VER=13.0 -
编译库
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
根据你的模型编辑
config_infer_primary_yolo26.txt文件(适用于包含 80 个类别的 YOLO26s)[property] ... onnx-file=yolo26s.onnx ... num-detected-classes=80 ... parse-bbox-func-name=NvDsInferParseYolo ...
YOLO26 会对输入进行缩放并在中心填充,且不使用 NMS。为获得最佳精度,请将以下内容添加到 config_infer_primary_yolo26.txt 的 [property] 部分:
[property]
...
maintain-aspect-ratio=1
symmetric-padding=1
cluster-mode=4
...-
编辑
deepstream_app_config文件... [primary-gie] ... config-file=config_infer_primary_yolo26.txt -
你也可以在
deepstream_app_config文件中更改视频源。这里加载的是默认视频文件... [source0] ... uri=file:///opt/nvidia/deepstream/deepstream/samples/streams/sample_1080p_h264.mp4
运行推理#
deepstream-app -c deepstream_app_config.txt开始推理前,生成 TensorRT 引擎文件需要较长时间,请耐心等待。
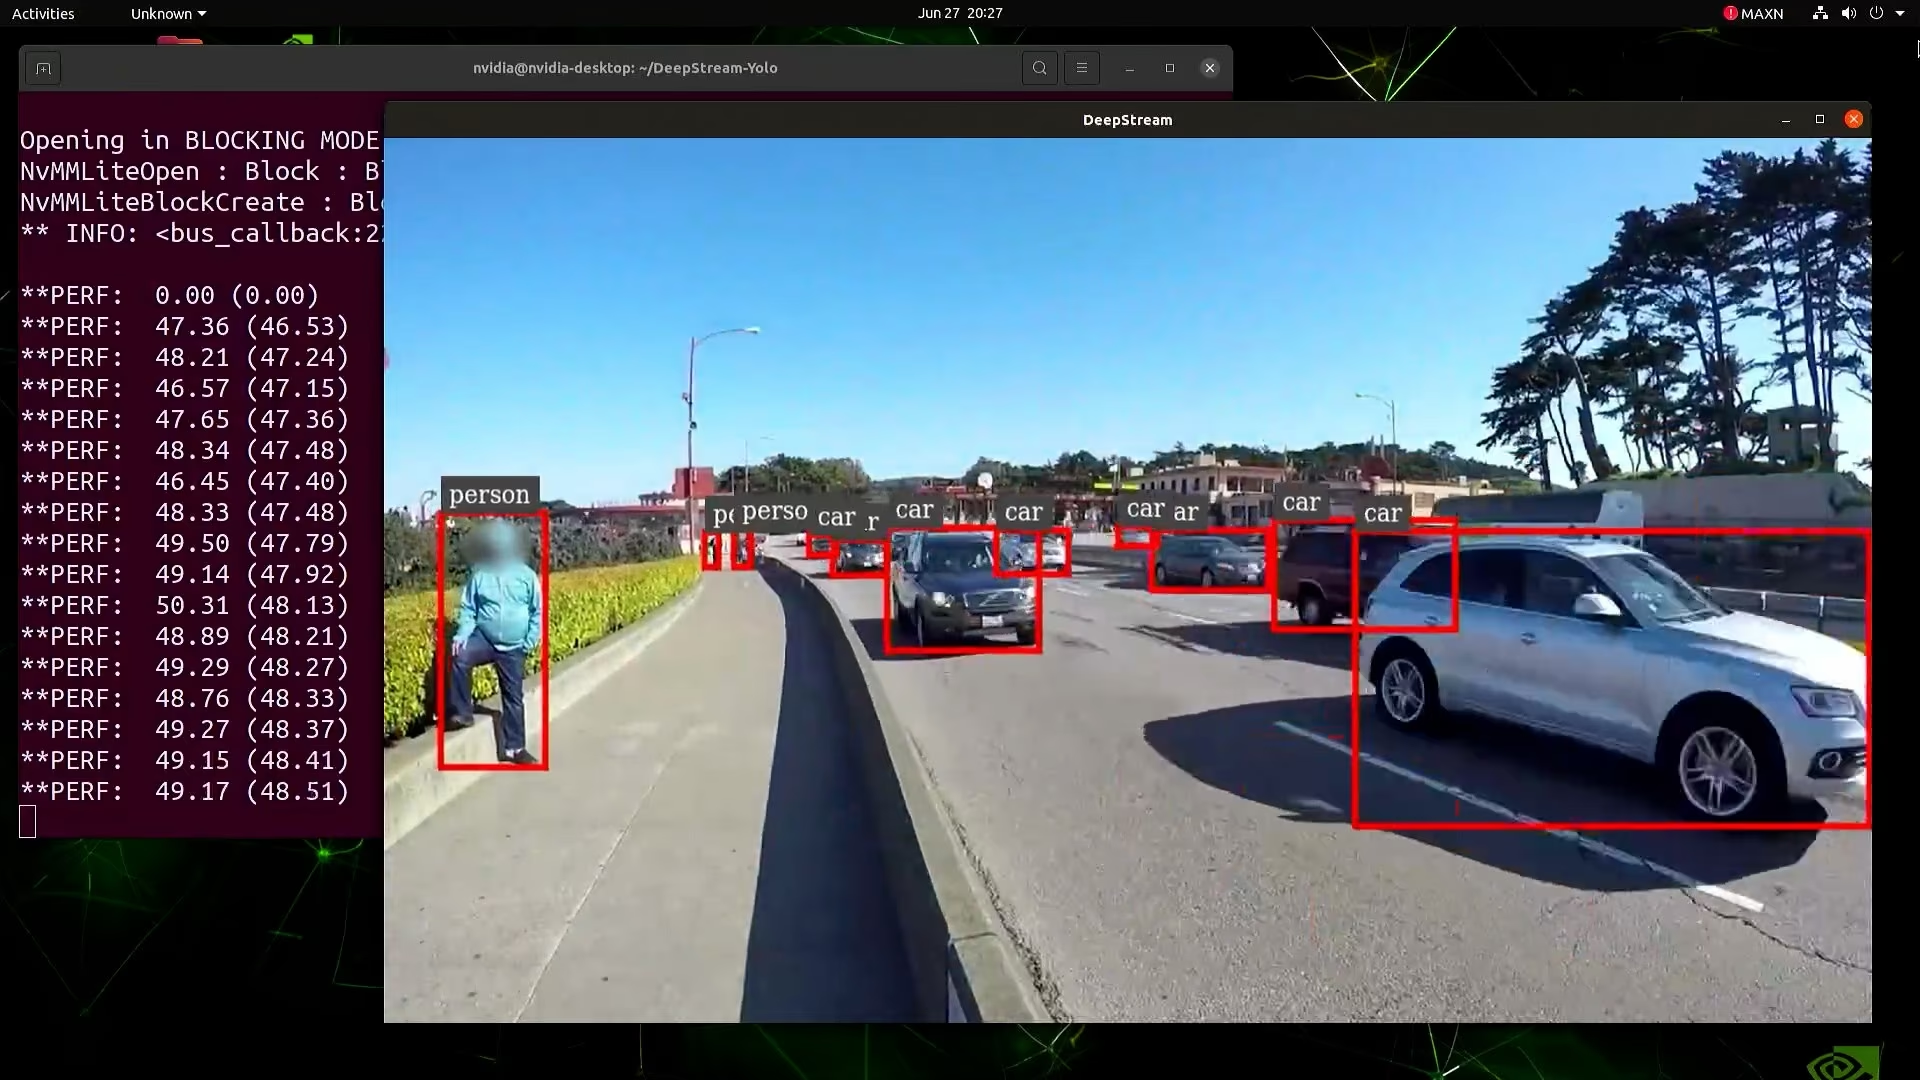
如果要将模型转换为 FP16 精度,只需在 config_infer_primary_yolo26.txt 中设置 model-engine-file=model_b1_gpu0_fp16.engine 和 network-mode=2
INT8 校准#
如果要使用 INT8 精度进行推理,请按以下步骤操作:
目前 INT8 无法与 TensorRT 10.x 配合使用。本指南的这一部分已使用 TensorRT 8.x 进行测试,预计可正常运行。
-
设置
OPENCV环境变量export OPENCV=1 -
编译库
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
对于 COCO 数据集,请下载 val2017,解压后移动到
DeepStream-Yolo文件夹 -
新建一个目录,用于存放校准图像
mkdir calibration -
运行以下命令,从 COCO 数据集中随机选取 1000 张图像用于校准
for jpg in $(ls -1 val2017/*.jpg | sort -R | head -1000); do
  cp ${jpg} calibration/
done
NVIDIA 建议至少使用 500 张图像,以获得较好的精度。本示例选取了 1000 张图像以获得更高精度(图像越多,精度越高)。你可以通过 head -1000 设置数量。例如,选取 2000 张图像时使用 head -2000。此过程可能需要较长时间。
-
创建
calibration.txt文件,并将所有选中的图像列入其中realpath calibration/*jpg > calibration.txt -
设置环境变量
export INT8_CALIB_IMG_PATH=calibration.txt
export INT8_CALIB_BATCH_SIZE=1
较大的 INT8_CALIB_BATCH_SIZE 值可以提高精度并加快校准速度。请根据 GPU 内存进行设置。
-
更新
config_infer_primary_yolo26.txt文件从
...
model-engine-file=model_b1_gpu0_fp32.engine
#int8-calib-file=calib.table
...
network-mode=0
...
到
...
model-engine-file=model_b1_gpu0_int8.engine
int8-calib-file=calib.table
...
network-mode=1
...
运行 INT8 推理#
运行相同的命令来构建 INT8 引擎并开始推理:
deepstream-app -c deepstream_app_config.txt多流设置#
观看: 如何在 Jetson Orin 上使用 NVIDIA DeepStream 和 Ultralytics YOLO26 执行多路流推理 🚀
要在单个 DeepStream 应用程序中设置多个流,请对 deepstream_app_config.txt 文件进行以下更改:
-
根据要使用的流数量,更改行数和列数以构建网格显示。例如,对于 4 个流,可以添加 2 行和 2 列。
[tiled-display] rows=2 columns=2 -
为每个流添加单独的
[sourceN]组,每组都要有自己的uri和num-sources=1。[source0] enable=1 type=3 uri=file:///path/to/video1.mp4 num-sources=1 [source1] enable=1 type=3 uri=file:///path/to/video2.mp4 num-sources=1 [source2] enable=1 type=3 uri=file:///path/to/video3.mp4 num-sources=1 [source3] enable=1 type=3 uri=file:///path/to/video4.mp4 num-sources=1
运行多流推理#
运行相同的命令,在平铺显示中启动所有流:
deepstream-app -c deepstream_app_config.txt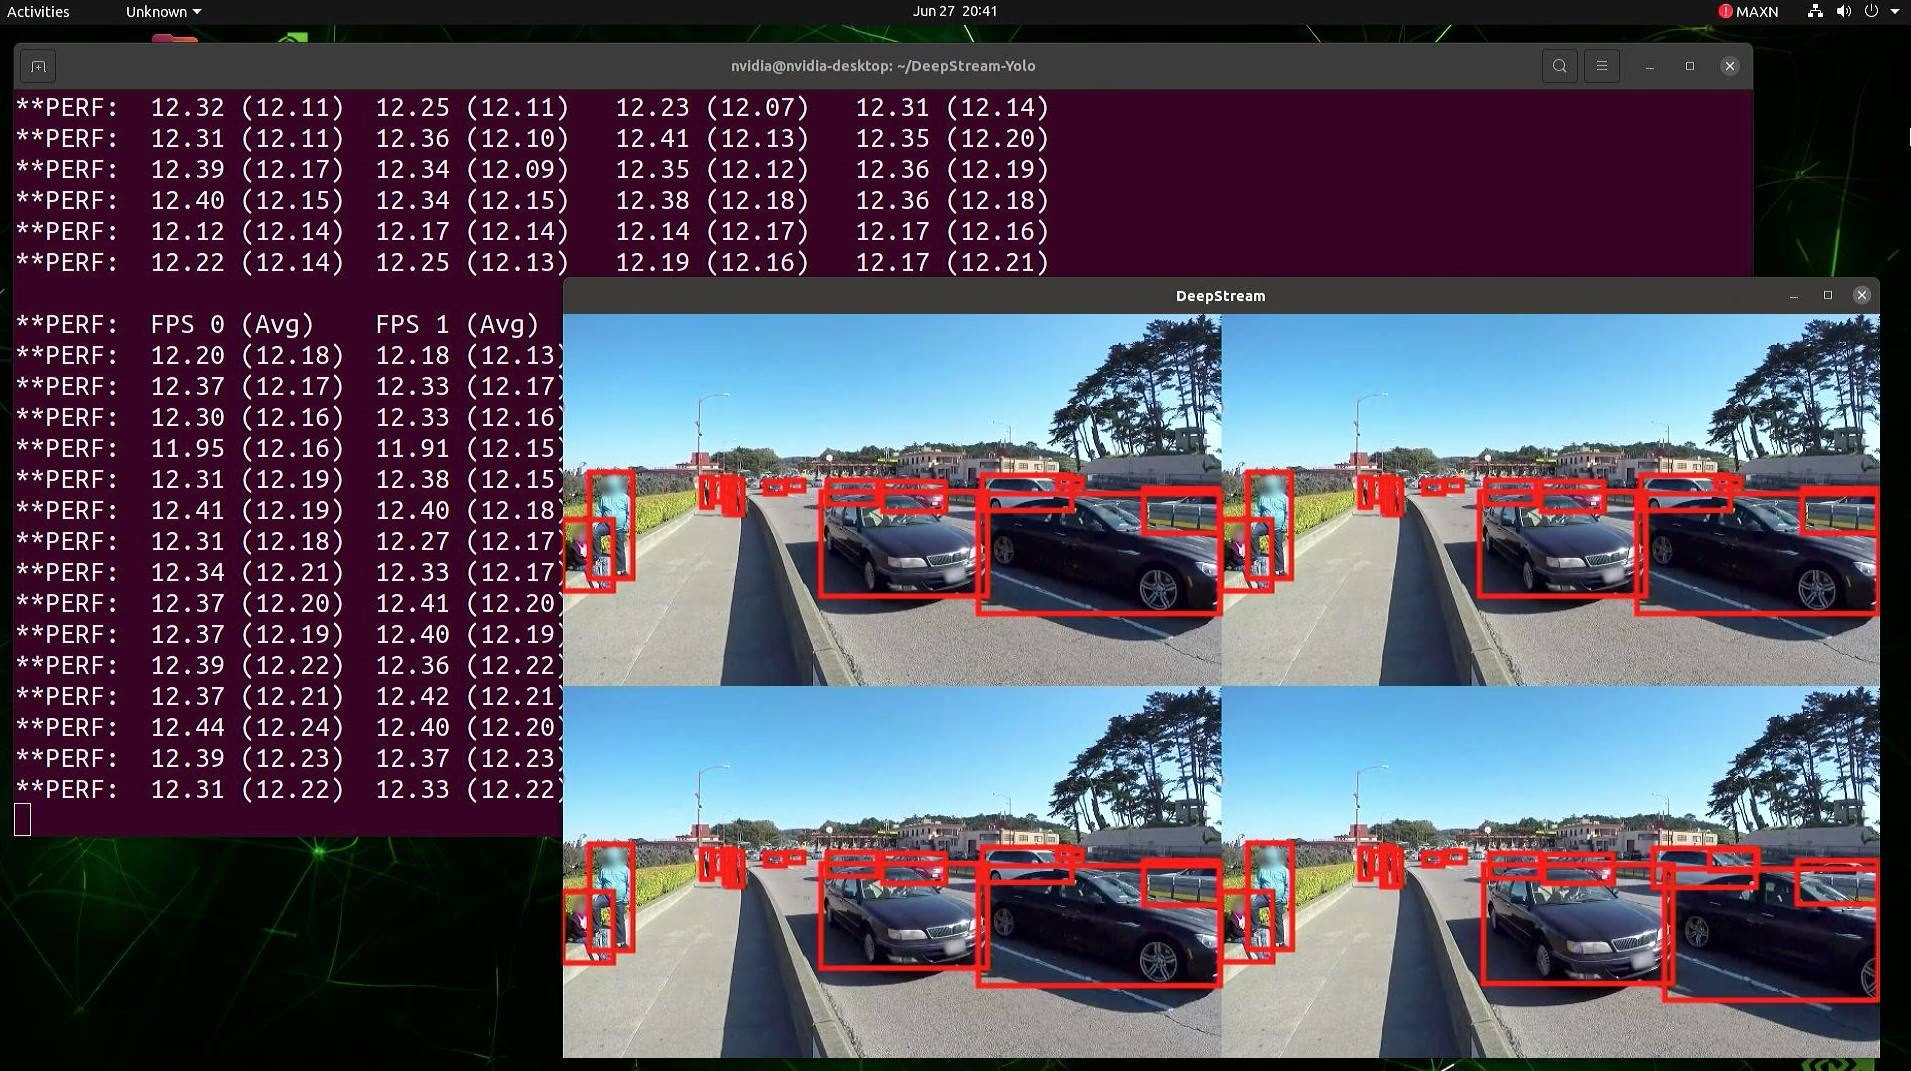
基准测试结果#
以下基准测试总结了 YOLO11 模型在 NVIDIA Jetson Orin NX 16GB 上使用不同 TensorRT 精度级别、输入尺寸为 640x640 时的性能。YOLO26 使用上文介绍的相同 DeepStream 导出和推理工作流。
对比图表#
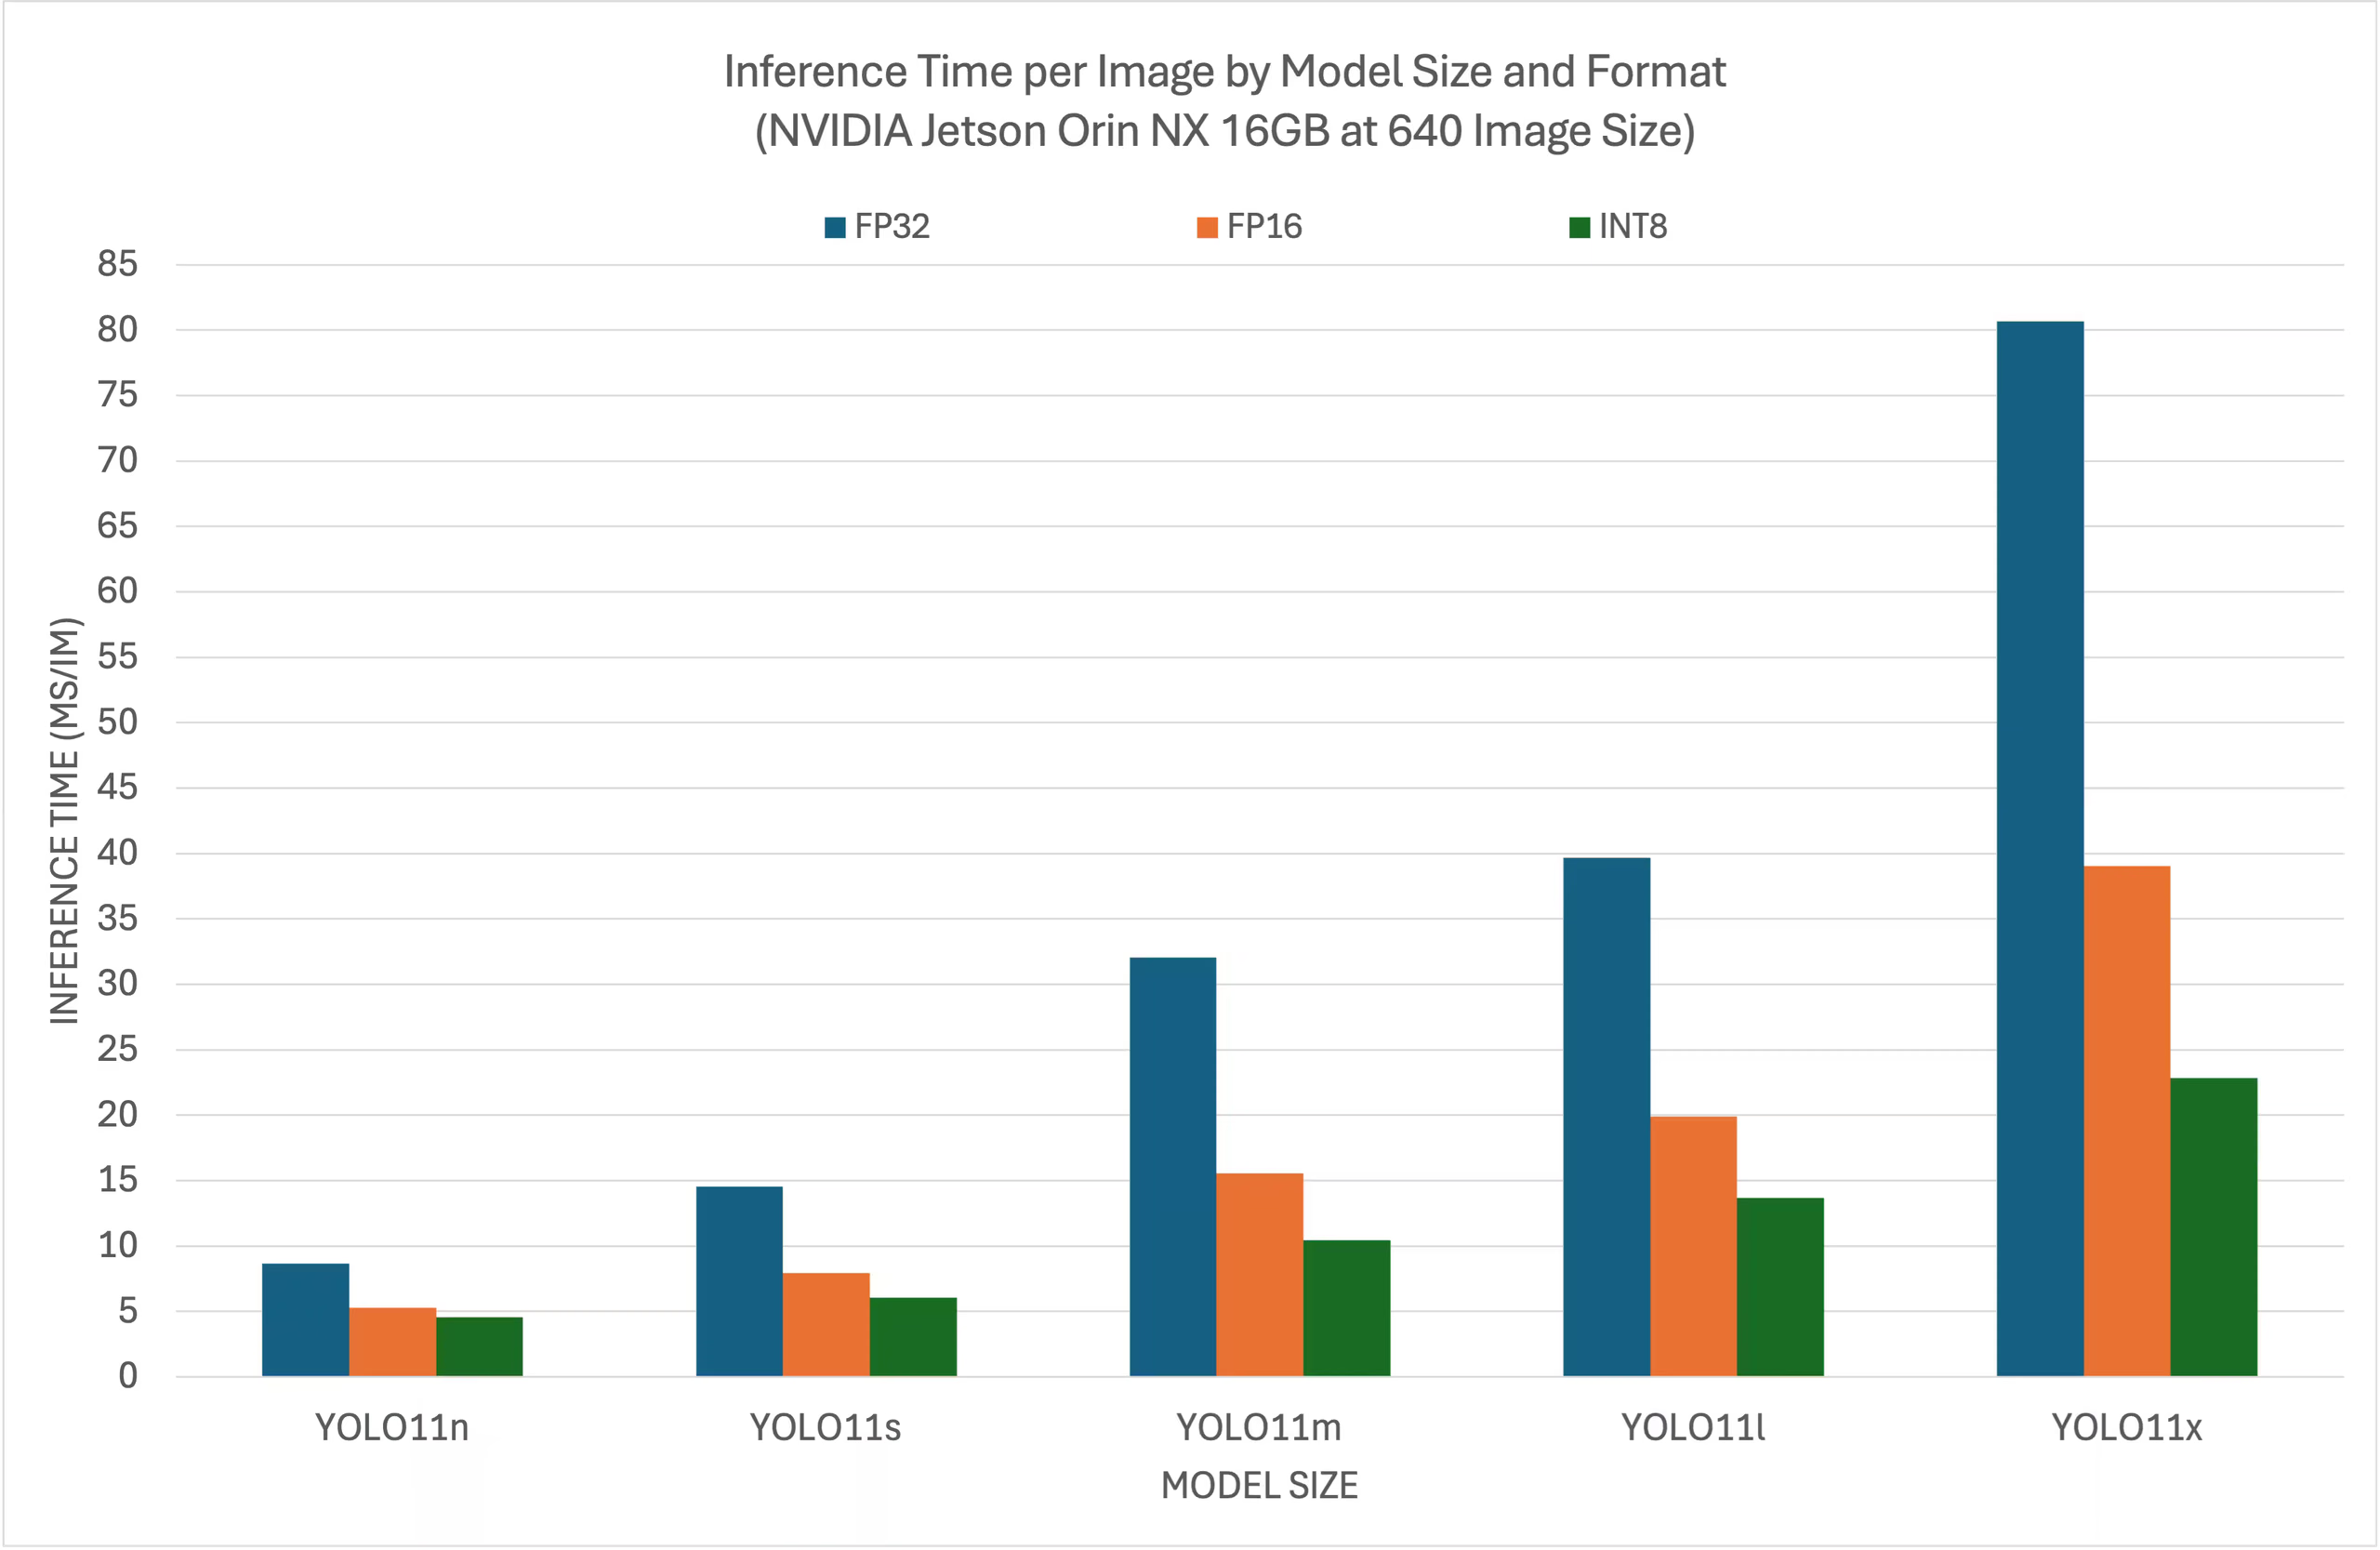
详细对比表#
| 格式 | 状态 | 推理时间 (ms/im) |
|---|---|---|
| TensorRT (FP32) | ✅ | 8.64 |
| TensorRT (FP16) | ✅ | 5.27 |
| TensorRT (INT8) | ✅ | 4.54 |
致谢#
本指南最初由 Seeed Studio 的朋友 Lakshantha 和 Elaine 编写。
常见问题#
要在 NVIDIA Jetson 设备上设置 Ultralytics YOLO26,你需要先安装与你的 JetPack 版本兼容的 DeepStream SDK。请按照我们的快速入门指南中的分步说明,为 YOLO26 部署配置 NVIDIA Jetson。
使用 TensorRT 与 YOLO26 配合,可以优化模型以进行推理,显著降低延迟并提高 NVIDIA Jetson 设备上的吞吐量。TensorRT 通过层融合、精度校准和内核自动调优,提供高性能、低延迟的深度学习推理。这能带来更快速、更高效的执行,尤其适用于视频分析和自主机器等实时应用。
可以,使用 DeepStream SDK 和 TensorRT 部署 Ultralytics YOLO26 的指南兼容整个 NVIDIA Jetson 系列。这包括搭载 JetPack 5.1.3 的 Jetson Orin NX 16GB,以及搭载 JetPack 4.6.4 的 Jetson Nano 4GB。详细步骤请参阅 YOLO26 的 DeepStream 配置部分。
使用 Ultralytics 导出器导出带有无 NMS 检测头的模型,并写入
labels.txt文件,DeepStream 会从中读取类别名称:from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # 创建了 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))对于 TensorRT 8.2 或更早版本(DeepStream 6.0.1 及更早版本),请添加
opset=12。有关模型转换的更多详情,请参阅我们的模型导出部分。要运行 INT8 推理,请使用具有代表性的图像集校准模型,并将 DeepStream 配置切换为 INT8 模式。下载 COCO val2017 图像,选取约 1000 张校准图像,设置
INT8_CALIB_IMG_PATH和INT8_CALIB_BATCH_SIZE环境变量,然后使用model-engine-file=model_b1_gpu0_int8.engine、int8-calib-file=calib.table和network-mode=1更新config_infer_primary_yolo26.txt。完整步骤请参阅 INT8 校准部分。目前,INT8 需要 TensorRT 8.x。要在单个 DeepStream 应用程序中处理多个流,请编辑
deepstream_app_config.txt文件,添加平铺显示网格并列出每个源 URI。在[tiled-display]下设置rows和columns以构建网格;为每个流添加单独的[sourceN]组,并为其设置各自的uri和num-sources=1;然后调整网格以适应流的数量。完整示例请参阅多流设置部分。YOLO11 模型在 NVIDIA Jetson Orin NX 16GB 上的性能因 TensorRT 精度级别而异。例如,YOLO11s 模型可达到:
- FP32 精度:14.53 ms/im,68.8 FPS
- FP16 精度:7.91 ms/im,126 FPS
- INT8 精度:6.05 ms/im,165 FPS
这些基准测试凸显了在 NVIDIA Jetson 硬件上使用经过 TensorRT 优化的 YOLO11 模型的效率和性能。有关更多详情,请参阅我们的基准测试结果部分。