Fashion-MNIST 데이터셋#
Fashion-MNIST 데이터셋은 Zalando의 의류 제품을 담은 28x28 크기의 흑백 이미지 70,000장으로 구성된 이미지 분류 벤치마크이며, 이미지는 티셔츠/상의, 바지, 풀오버, 드레스, 코트, 샌들, 셔츠, 스니커즈, 가방, 앵클부츠의 10개 클래스에 균등하게 분포합니다. 사전 정의된 분할로 학습 이미지 60,000장과 테스트 이미지 10,000장(클래스당 7,000장)을 제공하며, 기존 MNIST 데이터셋을 그대로 대체하여 머신 러닝 알고리즘을 벤치마킹하는 데 사용할 수 있습니다. 컬러 이미지 버전에 해당하는 데이터셋은 관련 CIFAR-10 데이터셋을 참조하시기 바랍니다.
Ultralytics Platform의 Fashion-MNIST를 살펴보며 샘플을 미리 보고, 데이터셋 통계를 확인하고, 복제하여 학습에 사용하세요.
주요 기능#
- Fashion-MNIST에는 28x28 픽셀 크기의 흑백 이미지 70,000개가 있으며, 10개 클래스에 균등하게 나뉩니다.
- 클래스마다 이미지가 정확히 7,000개씩 있으며, 학습용 6,000개와 테스트용 1,000개로 구성되어 데이터셋의 균형이 완벽하게 맞습니다.
- MNIST의 대체재로 바로 사용할 수 있습니다. 이미지 크기, 형식, 분할 구조는 동일하지만 손글씨 숫자 대신 더 까다로운 의류 카테고리로 구성됩니다.
- 데이터셋에 미리 정의된 학습/테스트 분할이 포함되어 있어 수동 또는 자동으로 분할할 필요가 없습니다.
- Fashion-MNIST는 이미지 분류 및 딥러닝 연구의 표준 벤치마크입니다.
데이터셋 구조#
Fashion-MNIST에는 공식적인 사전 정의 분할이 제공되므로 자동 또는 수동 분할이 필요하지 않습니다:
- 클래스: 10개(티셔츠/상의, 바지, 풀오버, 드레스, 코트, 샌들, 셔츠, 스니커즈, 가방, 앵클부츠)
- 전체 이미지: 70,000개(28x28 흑백)
- 학습 세트: 이미지 60,000개(클래스당 6,000개)
- 테스트 세트: 이미지 10,000개(클래스당 1,000개)
Fashion-MNIST에는 별도의 검증 폴더가 없으므로 기본적으로 Ultralytics는 학습 중 이미지 10,000개로 구성된 테스트 세트를 검증 분할로 사용합니다.
응용 분야#
Fashion-MNIST는 이미지 분류 모델의 학습과 평가에 널리 사용되며, 적용 범위는 고전적인 합성곱 신경망 (CNNs)과 서포트 벡터 머신 (SVMs)부터 최신 딥 아키텍처까지 이릅니다. 작은 흑백 이미지와 10개의 의류 카테고리로 인해 알고리즘 비교와 컴퓨터 비전 실험에 빠르고 재현성 높은 벤치마크가 되며, 손글씨 숫자로 구성된 MNIST보다 더 까다롭습니다.
사용법#
이미지 크기를 28로 설정하고 Fashion-MNIST에서 YOLO 모델을 100개의 에포크 동안 학습합니다. 사용 가능한 인수 전체 목록은 학습 페이지와 이미지 분류 작업 가이드를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-cls.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델 학습
results = model.train(data="fashion-mnist", epochs=100, imgsz=28)
샘플 이미지 및 어노테이션#
Fashion-MNIST 데이터셋의 샘플 이미지:
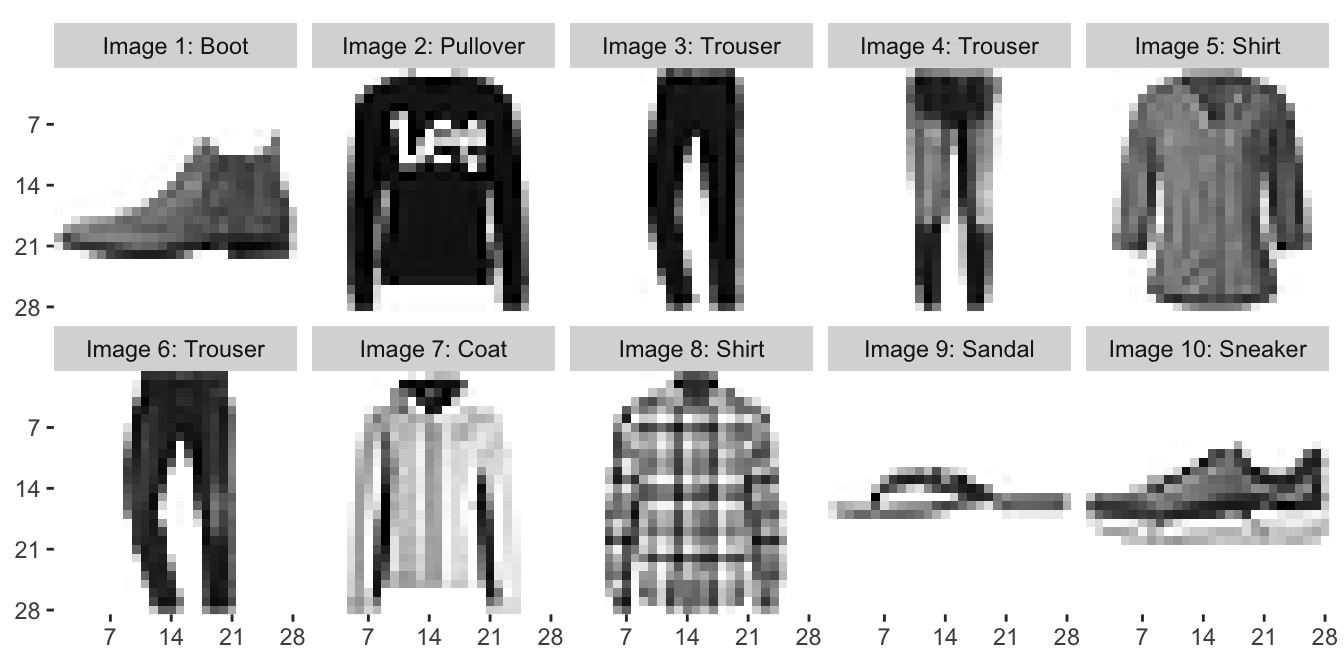
샘플은 Fashion-MNIST 데이터셋에 포함된 의류 카테고리의 다양성을 보여 주며, 강건한 이미지 분류 모델 학습에 다양한 데이터셋이 얼마나 중요한지 강조합니다.
인용 및 감사의 글#
연구 또는 개발 작업에 Fashion-MNIST 데이터셋을 사용하는 경우 다음 논문을 인용해 주세요:
@article{xiao2017fashion,
         title={Fashion-MNIST: a Novel Image Dataset for Benchmarking Machine Learning Algorithms},
         author={Han Xiao and Kashif Rasul and Roland Vollgraf},
         year={2017},
         eprint={1708.07747},
         archivePrefix={arXiv},
         primaryClass={cs.LG}
}
머신 러닝 및 컴퓨터 비전 연구 커뮤니티에 귀중한 자료인 Fashion-MNIST 데이터셋을 만들고 관리해 온 Zalando Research에 감사드립니다. Fashion-MNIST 데이터셋과 제작자에 관한 자세한 내용은 Fashion-MNIST GitHub 저장소를 방문하세요.
자주 묻는 질문#
Fashion-MNIST 데이터셋은 Zalando 의류 품목의 28x28 흑백 이미지 70,000개를 10개 클래스로 구성한 벤치마크로, 기존 MNIST 데이터셋의 대체재로 만들어졌습니다. MNIST와 이미지 크기, 형식, 학습/테스트 분할(60,000/10,000)은 정확히 같지만 손글씨 숫자를 티셔츠/상의, 바지, 앵클부츠 등 더 어려운 패션 카테고리로 대체하여 이미지 분류 모델에 더 까다로운 벤치마크를 제공합니다.
Fashion-MNIST에서 Ultralytics YOLO 모델을 학습하려면 아래 코드 조각을 사용하세요. 데이터셋은 처음 사용할 때 자동으로 다운로드됩니다. 인수 전체 목록은 모델 학습 페이지를 참조하세요.
학습 예제from ultralytics import YOLO # 모델 로드 model = YOLO("yolo26n-cls.pt") # 사전 학습된 모델을 불러옵니다(학습에 권장). # 모델 학습 results = model.train(data="fashion-mnist", epochs=100, imgsz=28)Fashion-MNIST에는 티셔츠/상의, 바지, 풀오버, 드레스, 코트, 샌들, 셔츠, 스니커즈, 가방, 앵클부츠의 10개 클래스가 있으며, 각 클래스에는 이미지가 정확히 7,000개씩, 총 70,000개가 있습니다. 각 이미지는 Zalando 의류 품목 하나를 담은 28x28 흑백 이미지이며, 클래스별 데이터 수가 완벽하게 균형을 이룹니다.
Fashion-MNIST에는 학습 이미지 60,000개와 테스트 이미지 10,000개로 구성된 사전 정의 분할이 제공되며, 클래스마다 학습 이미지 6,000개와 테스트 이미지 1,000개가 있습니다. Ultralytics가 자동으로 분할하는 폴더 기반 분류 데이터셋과 달리, Fashion-MNIST의 공식 분할은 그대로 사용되며 기본적으로 학습 중 테스트 세트가 검증 분할로 사용됩니다.
예. Ultralytics Platform을 사용하면 많은 코드를 작성하지 않고도 데이터셋을 관리하고, 이미지 분류 모델을 학습하고, 배포할 수 있습니다. 클라우드에서 Fashion-MNIST 실험을 진행하기에 편리하며, 분류 데이터셋 개요에서 더 많은 옵션을 살펴볼 수 있습니다.