Ultralytics YOLO를 사용한 단안 깊이 추정#
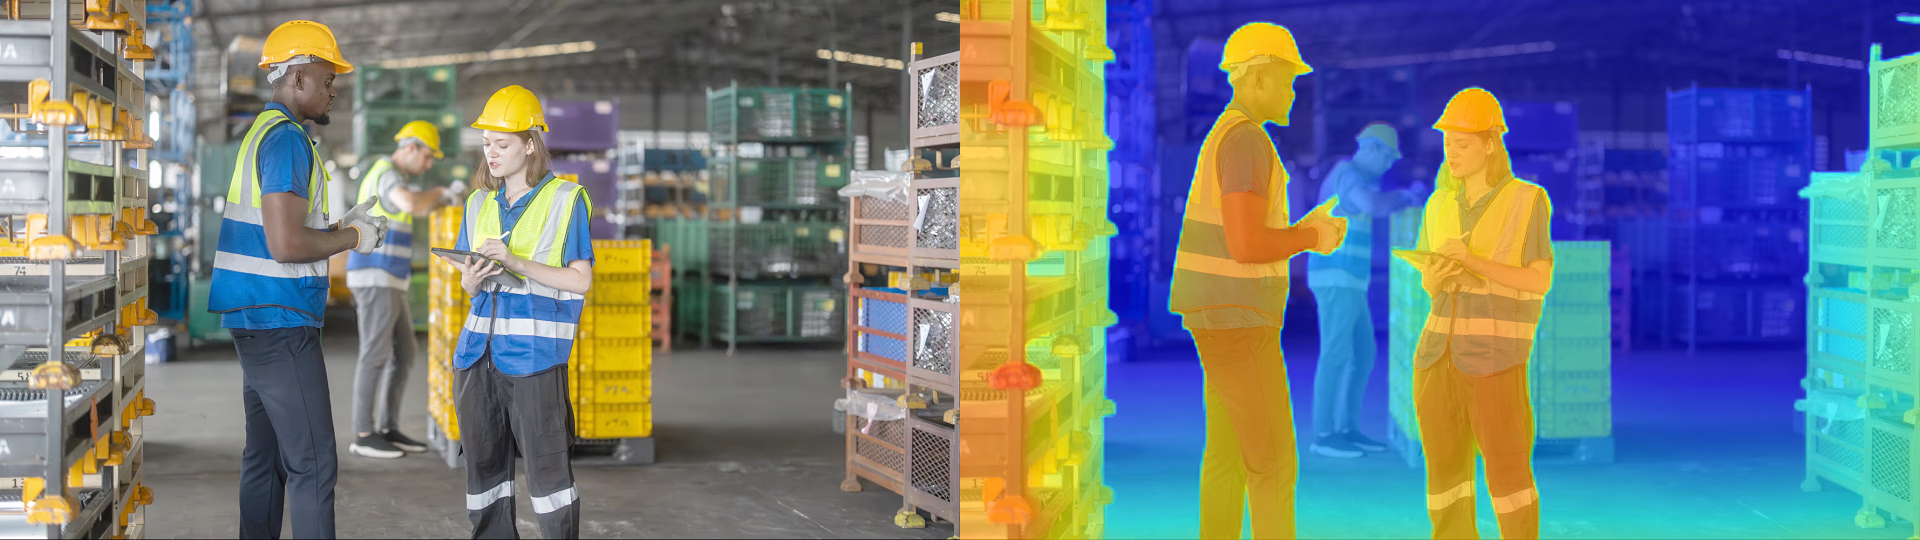
단안 깊이 추정은 단일 RGB 이미지에서 픽셀별 깊이 맵을 예측합니다. 각 출력 픽셀에는 카메라에서 해당 표면 지점까지의 추정 거리를 나타내는 미터 단위 깊이 값이 포함됩니다.
깊이 모델의 출력은 입력 이미지와 정렬된 (H, W) 형태의 조밀한 부동소수점 맵입니다. 이 픽셀별 표현 덕분에 단안 깊이 추정은 3D 장면 재구성, 로봇 내비게이션, AR/VR 콘텐츠 제작 및 단일 카메라에서 공간 배치를 추론해야 하는 모든 애플리케이션에 적합합니다.
시청: Ultralytics YOLO26을 사용한 단안 깊이 추정 | Python 튜토리얼 | Vision AI 🚀
단안 깊이 추정에는 task=depth 또는 yolo depth CLI 작업을 사용합니다. YOLO26 깊이 모델 파일은 -depth 접미사를 사용합니다(예: yolo26n-depth.pt).
모델#
광범위한 여러 데이터셋 혼합(실내 + 실외, ~2.19M 이미지)으로 사전 학습된 YOLO26 깊이 모델을 아래에 표시했습니다. 지표 열은 NYU Depth V2 Eigen 테스트 분할에서 측정한 결과입니다.
모델은 처음 사용할 때 최신 Ultralytics 릴리스에서 자동으로 다운로드됩니다.
| 모델 | 크기 (픽셀) | delta1NYU | abs_relNYU | rmseNYU | 속도 CPU ONNX (ms) | 속도 T4 TensorRT10 (ms) | 파라미터 (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU는 NYU Depth V2 Eigen 테스트 분할(654개 이미지)에서 멀티 스케일 및 수평 뒤집기 TTA와 로그 최소제곱 정렬을 적용했을 때, 예측 깊이가 실제 깊이의 1.25배 이내인 픽셀의 비율입니다.
- TTA를 적용하지 않은 단일 스케일 정확도는
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0을 사용하여 재현할 수 있습니다(각 크기에는model=을 대입). 이 방식은 중앙값(스케일만) 정렬을 사용하며 점수가 더 낮습니다: delta1은 n 0.783, s 0.793, m 0.840, l 0.853, x 0.860입니다. - abs_rel은 예측 깊이 값과 실제 깊이 값 사이의 평균 절대 상대 오차입니다.
- rmse는 미터 단위의 평균 제곱근 오차입니다.
- 속도는
imgsz=768,batch=1에서 측정한 추론 전용 지연 시간(전처리/후처리 제외)이며, 워밍업 후 실행 시간을 측정한 여러 번의 실행에 대한 평균 ± 표준편차로 보고합니다. CPU ONNX는 32코어 Intel Xeon(Skylake)에서의 ONNX Runtime fp32이고, T4 TensorRT10은 Tesla T4에서의 TensorRT fp16입니다. - params와 FLOPs는 공개된 가중치의 학습 해상도인 768×768에서 측정했습니다.
예비 NYU Depth V2 결과는 미공개 YOLO27 프리뷰를 참조하세요.
Depth Anything V2와의 속도 비교#
Depth Anything V2는 단안 깊이 추정에 널리 사용되는 오픈 베이스라인입니다. DINOv2 비전 트랜스포머 백본과 DPT 디코더는 연산량이 많기 때문에, 동일한 Tesla T4에서 TensorRT fp16을 사용하면 공개된 Depth Anything V2 모델 중 가장 작은 모델도 모든 YOLO26 깊이 모델보다 느립니다. 여기에는 파라미터가 두 배 이상 많은 YOLO26x-depth도 포함됩니다.
~768px 기준 — YOLO26은 공개 가중치의 학습 해상도인 imgsz=768을 사용하고, Depth Anything V2는 DINOv2 백본이 패치 크기 14의 배수를 요구하므로 770px을 사용합니다:
| 모델 | 매개변수(M) | FLOPs(B) | T4 TensorRT10(ms) | FPS | V2 Small 대비 속도 향상 | V2 Base 대비 속도 향상 |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
~640px 기준 — 각각 imgsz=640 및 644px을 사용합니다. 모델 순서는 동일하며 YOLO26n-depth는 Depth Anything V2 Small보다 5.9배 빠릅니다:
| 모델 | T4 TensorRT10(ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- 지연 시간은 추론 전용이며,
batch=1에서 Tesla T4의 TensorRT fp16으로 측정했습니다. 위 모델 표와 동일한 테스트 환경을 사용했으며 여기서는 소수점 둘째 자리까지 표시합니다. FPS는 반올림 전 지연 시간의 역수입니다. 속도 향상 열은 Depth Anything V2 Small(20.99ms) 및 Base(55.40ms)의 지연 시간을 YOLO26 지연 시간으로 나눈 값입니다. - Depth Anything V2 Small 및 Base는 공개된 ViT-S 및 ViT-B 체크포인트입니다.
- 이 비교는 지연 시간만 다룹니다. 두 모델 제품군은 여기서 동일한 정확도 평가 프로토콜로 평가하지 않았습니다.
깊이 범위 및 로그 깊이 헤드#
깊이 헤드는 exp(logit)을 예측하며, 범위가 제한되지 않습니다(~0.02–150m). 또한 장면 형태와 절대 스케일을 분리합니다. 네트워크는 상대 로그 깊이 필드를 예측하고, 절대 미터 값은 평가 시 복원하거나 경량 보정 또는 파인 튜닝으로 설정하는 별도의 2개 매개변수 변환(exp(a·log d + b))을 통해 정해집니다. 일반적인 대안인 범위 제한 sigmoid × max_depth 헤드는 대신 아키텍처에 고정 상한을 설정하므로 max_depth을 초과하는 깊이는 잘립니다. 이로 인해 더 먼 거리의 장면에 대한 학습과 예측이 불가능합니다.
통제된 A/B 테스트 — 동일한 데이터, 동일한 스케줄, 헤드만 다릅니다. 실내(≤10m) 및 실외(≤80m) 데이터가 동일하게 혼합된 데이터에서 두 헤드를 처음부터 학습합니다:
| 헤드 | 출력 범위 | 혼합 범위 검증 δ1 | 학습 동작 |
|---|---|---|---|
sigmoid × max_depth (10m) | 범위 제한 0–10m | 0.221 | 1 epoch에서 정체됩니다 |
log (범위 제한 없음) | 0–~150 m | 0.367 (+66%) | 학습 내내 성능이 향상됩니다 |
범위 제한 헤드는 실외 픽셀의 대다수인 10m 초과 깊이를 표현할 수 없어 거의 즉시 성능 향상이 멈춥니다. log 헤드는 전체 범위에서 학습합니다.
해결하는 실패 사례 — 범위별로 층화한 단일 데이터셋 파인 튜닝. 범위 제한(10m) 헤드를 개별 데이터셋에 파인 튜닝하면 데이터가 상한 이내일 때는 작동하지만, 상한을 넘으면 성능이 무너집니다:
| 데이터셋 | 깊이 범위 | 범위 제한 헤드 δ1 |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | 대부분 ≤10m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 — 80/10 스케일 불일치) |
| vKITTI2 | 80 m | 0.04 ❌ |
성능 붕괴는 상한 경계에서 정확히 발생합니다. log 헤드에는 이러한 경계가 없습니다.
공개 모델 — 범위 전반의 성능. 배포된 log 헤드 제품군을 10m(NYU, iBims-1)부터 80m(KITTI)까지의 벤치마크에서 평가했으며, 스케일 정렬 δ1을 사용했습니다:
| 벤치마크 | 범위 | YOLO26x-depth (log) | 이전 범위 제한 모델 |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| 평균 | — | 0.819 | 0.799 |
두 열의 값은 모두 발표된 그대로입니다. 나머지 행은 각 데이터셋 페이지에 설명된 TTA 및 로그 최소제곱 프로토콜로 점수를 측정했습니다. 이 저장소의 검증기는 해당 프로토콜을 구현하지 않으므로 KITTI 행을 동일한 조건에서 다시 측정할 수 없습니다. KITTI 페이지에는 표준 652프레임 Eigen 분할에서 측정한 값이 대신 표시되어 있습니다.
가장 큰 성능 향상은 범위가 더 긴 실외 벤치마크(KITTI, ETH3D)에서 나타납니다. 고정된 10m 상한이 가장 큰 영향을 미치는 곳이며, 실내 성능은 유지됩니다.
학습#
Depth8 데이터셋에서 YOLO26n-depth를 이미지 크기 640으로 100 epoch 동안 학습합니다. 사용 가능한 전체 인수 목록은 구성 페이지를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-depth.yaml")  # YAML에서 새 모델을 생성합니다.
model = YOLO("yolo26n-depth.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # YAML에서 모델을 생성하고 가중치를 전이합니다.

# 모델 학습
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
학습 페이지에서 train 모드의 전체 세부 정보를 확인하세요. 깊이 모델은 Ultralytics Platform 클라우드 학습으로도 학습할 수 있습니다.
데이터셋 형식#
깊이 추정 데이터셋은 각 RGB 이미지에 스케일이 조정된 uint16 깊이 PNG 또는 미터 단위 부동소수점 NPY 깊이 맵을 연결합니다. PNG 값은 기본적으로 밀리미터를 사용하며, 다른 규칙을 사용하는 데이터셋은 YAML에서 depth_scale을 설정합니다. 로더는 images 구성 요소를 depth로 바꾸어 깊이 경로를 계산하고, .png을 우선 사용한 뒤 없으면 .npy를 사용합니다.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
예를 들어 images/train/scene_001.jpg에 있는 이미지는 depth/train/scene_001.png에 있는 깊이 맵과 연결됩니다. 전체 형식 사양은 깊이 추정 데이터셋 가이드를 참조하세요.
자체 데이터로 파인 튜닝#
사전 학습된 깊이 모델을 사용자 지정 데이터셋에 맞게 조정할 때는 학습률을 낮추고 AdamW 옵티마이저를 사용하세요. 기본 옵티마이저 설정은 처음부터 학습하도록 조정되어 있습니다. 이미 수렴한 깊이 모델에 이를 적용하면 사전 학습된 지식이 덮어쓰여 결과가 저하될 수 있으며, 특히 단일 도메인에서 파인 튜닝할 때 그렇습니다.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # 사전 학습된 가중치에서 시작합니다

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # 처음부터 학습하는 기본값보다 약 100배 낮습니다
    warmup_bias_lr=1e-4,  # 워밍업도 완만하게 설정합니다
)
추가 팁:
- 증강은 표준 인수로 제어합니다 (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v). 기하학적 워프와 플립은 쌍을 이루는 깊이 맵에 동일하게 적용됩니다. 배포된 YOLO26-Depth 가중치에 사용된 정확한 레시피를 확인하려면 체크포인트에 저장된train_args을 살펴보세요. 자세한 내용은 YOLO26 체크포인트 학습 인수 확인을 참조하세요. mosaic,mixup,cutmix,copy_paste은 깊이 추정용으로 구현되지 않았습니다. 깊이 데이터셋 로더는 이 확률을 자동으로 0으로 설정하므로, 해당 인수를 전달해도 효과가 없습니다. 이러한 증강은 여러 이미지를 결합하므로 유효하지 않은 쌍별 깊이 맵을 만들게 되어 지원되지 않습니다.- 모든 깊이 범위를 별도 설정 없이 사용할 수 있습니다.
log헤드 모델은 제한되지 않은 깊이를 예측하므로 별도 변경 없이 근거리(매크로) 또는 원거리(실외/주행) 데이터에 적응합니다. 데이터셋 YAML에서max_depth:을 설정하면(미터 단위) 검증 지표 계산에 포함되는 GT 픽셀의 범위를 제한할 수 있습니다. - 일반적인 성능을 유지합니다. 학습 데이터셋 밖의 장면에서도 모델의 정확도를 유지해야 한다면, 다양한 범용 이미지의 일부(약 5~10%)를 학습 데이터에 섞으세요. 이렇게 하면 미세 조정 중 발생하는 망각을 크게 줄일 수 있습니다.
- 도메인이 매우 다르고 대규모 데이터셋이 있는 경우에만 처음부터 학습(
model=yolo26s-depth.yaml)하세요. 사전 학습된 가중치가 보존되지 않으므로 이 경우에는 기본optimizer=auto이 적절합니다.
깊이 스케일 보정#
깊이 헤드는 형상(장면의 상대적 구조)과 스케일(절대 거리, 미터 단위)을 분리합니다. 모델이 장면의 상대적 깊이는 잘 예측하지만 카메라 기준 절대값이 맞지 않는다면, 소량의 라벨링된 데이터셋을 대상으로 헤드의 로그-아핀 변환을 스케일만 조정해 폐쇄형 방식으로 맞추는 model.calibrate()을 사용하여 몇 초 만에 스케일을 보정할 수 있습니다. 교차 검증된 홀드아웃 δ1이 개선되는 경우에만 결과를 유지하며, 그래디언트 학습이나 네트워크 가중치 변경이 없으므로 상대적 구조를 저하시킬 수 없습니다.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# 라벨링된 분할(약 100장 이상이면 충분함)에서 스케일을 맞춘 다음 저장합니다
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
보정에는 기준으로 사용할 정답 깊이가 필요하므로 라벨링된 분할에서 실행되며, 라벨이 없는 추론 단계에서는 수행할 수 없습니다. 보정은 검증 지표를 계산하는 동일한 픽셀에서 맞춤 및 점수를 계산합니다. 데이터셋 YAML의 max_depth(기본값 100 m) 이상인 GT는 제외됩니다. 상대적 깊이는 이미 양호하지만 스케일/범위만 잘못된 경우 사용하세요. 도메인에 맞게 상대적 구조 자체를 변경해야 한다면 대신 미세 조정을 수행하세요.
학습 과정에서 이 작업이 자동으로 수행됩니다. model.train(...)이 완료되면 검증 세트에서 최적 및 마지막 체크포인트를 보정하므로 별도 설정 없이 미터 단위로 스케일이 조정된 깊이를 출력합니다.
배포된 yolo26*-depth.pt 체크포인트에는 사전 학습 검증 데이터 조합으로 맞춘 이 보정이 이미 적용되어 있습니다. 모든 도메인에 단일 전역 스케일을 사용하므로, 특정 카메라나 장면 유형에서 가장 정확한 절대 깊이를 얻으려면 자체 데이터에서 소량의 라벨링된 분할을 사용해 model.calibrate()을 실행하세요. 이 작업은 기존에 적용된 보정값을 대체합니다.
깊이 카메라 없이 정답 깊이 데이터 얻기#
카메라에 깊이 센서가 없어도 보정할 수 있습니다. 보정은 전역 스케일 하나를 피팅하고 깊이가 0인 픽셀은 무시하므로, 이미지당 측정한 지점 몇 개면 충분합니다.
-
이미지를 수집합니다. 실제 배포 시 사용할 해상도와 렌즈 설정으로 카메라를 사용해 이미지 50~150장을 촬영하고
dataset/images/val/에 저장합니다. 보정 과정에서는val분할을 읽습니다. -
깊이를 레이블링합니다. 아래 두 가지 방법 중 하나를 사용합니다. 두 방법 모두 데이터셋 형식에 따라 이미지마다 깊이 맵 하나를
dataset/depth/val/에 저장합니다.
레이저 거리 측정기나 줄자를 사용해 각 이미지에서 평평한 표면의 물체 가장자리에서 떨어진 몇 개 지점까지의 거리를 측정하고, 각 지점의 픽셀 위치를 points.csv에 기록합니다.
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
그런 다음 측정하지 않은 픽셀은 모두 0으로 유지하면서 깊이 맵을 작성합니다. 각 지점은 imgsz 크기로 리사이즈한 뒤에도 유지되도록 작은 점으로 표시합니다.
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
거리 측정기는 지점까지의 직선거리를 측정하지만, 깊이 맵은 카메라 시선 축을 따라 잰 거리를 저장합니다. 두 거리는 이미지 중앙에서 일치하고 중앙에서 15° 벗어나면 약 3.5% 차이가 나므로, 중앙 근처의 지점을 측정하거나 카메라 내부 파라미터를 사용해 meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2)으로 각 측정값을 변환합니다.
-
데이터셋 YAML을
calib.yaml으로 작성합니다.depth_scale: 100은 측정 지점에서 생성한 센티미터 단위 PNG를 읽으며 NPY 맵에는 사용되지 않습니다.path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
보정한 후 저장하고, 예측 또는 내보내기를 위해
yolo26s-depth-calibrated.pt을 로드합니다.from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
yolo26s-depth.pt과 카메라당 이미지 150장을 사용한 테스트에서, 공개된 보정값은 NYU, KITTI 및 좁은 렌즈 카메라의 전체 정답 데이터에 피팅한 스케일과 비교해 4~46% 차이가 났습니다. 이미지당 측정 지점 5개를 사용해 보정하면 해당 피팅값과의 차이가 1% 이내였고, DA3METRIC-LARGE 레이블을 사용하면 7% 이내였습니다. 이미지당 지점 수를 늘리는 것보다 이미지 수를 늘리는 편이 효과적입니다. 이미지당 지점 1개로 150장을 사용하면 차이가 약 3% 이내였지만, 이미지당 지점 5개로 20장을 사용하면 최대 9% 차이가 났습니다.
검증#
깊이 추정 데이터셋에서 학습된 YOLO26n-depth 모델의 정확도를 검증합니다. 의도한 데이터셋 YAML을 사용해 검증하도록 data을 명시적으로 전달합니다. 공개된 가중치는 패딩을 추가한 레터박스 방식이 아니라 이미지를 정사각형으로 늘린 상태에서 imgsz=768로 학습되었으므로, 정확도를 높이려면 해당 크기로 검증하고 예측합니다. 예측, 검증 및 model.calibrate()은 모두 입력을 같은 방식으로 늘립니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-depth.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델을 검증합니다
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # 임계값 δ=1.25 이내인 픽셀의 비율
metrics.abs_rel  # 평균 절대 상대 오차
metrics.rmse  # 제곱 평균 제곱근 오차(미터)
metrics.silog # 스케일 불변 로그 오차예측#
학습된 YOLO26n-depth 모델을 사용해 이미지에 대한 예측을 수행합니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-depth.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델로 예측을 수행합니다
results = model("https://ultralytics.com/images/bus.jpg")  # 이미지에 대해 예측을 수행합니다

# 결과에 액세스합니다
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, shape (H, W), 미터 단위
Predict 페이지에서 predict 모드의 전체 세부 정보를 확인하세요.
결과 출력#
YOLO 깊이 추정은 이미지당 Results 객체 하나를 반환합니다. 각 결과에는 전체 이미지에 대한 단일 밀집 부동 소수점 깊이 맵이 저장됩니다.
| 속성 | 유형 | 형태 | 설명 |
|---|---|---|---|
result.depth | DepthMap | (H,W) | 픽셀별 조밀한 깊이 맵입니다. |
result.depth.data | torch.Tensor | (H,W) | 깊이 값은 미터 단위이며, NumPy 배열을 얻으려면 .cpu().numpy()을 호출합니다. |
result.boxes | - | - | 인스턴스 박스가 없습니다. |
result.masks | - | - | 인스턴스 마스크가 없습니다. |
모든 작업에서 작업별 Results 필드를 확인하려면 작업별 예측 결과 섹션을 참조하세요.
인스턴스 세그멘테이션을 통한 객체별 깊이#
인스턴스 세그멘테이션과 깊이를 결합해 검출된 각 객체까지의 거리를 추정합니다. retina_masks=True을 사용해 동일한 이미지에서 두 모델을 모두 실행하면 마스크가 깊이 맵의 원본 이미지 해상도와 일치하므로, 각 마스크 내부의 유효한 깊이 픽셀에 대해 중앙값을 구합니다.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
중앙값은 마스크 가장자리의 배경 픽셀에 영향을 덜 받지만, 객체의 중심이 아니라 보이는 표면을 나타내며, 정확도는 모델의 깊이 스케일에 따라 달라집니다(깊이 스케일 보정을 참조하세요).
깊이 맵에 색상 입히기#
원시 깊이 맵은 미터 단위의 단일 채널 부동 소수점 배열입니다. 연산에는 유용하지만 그대로 읽기는 어렵습니다. 이를 컬러 이미지로 변환하려면 ultralytics.utils.plotting의 colorize_depth 헬퍼를 사용하세요. 이 헬퍼는 (H, W) 깊이 배열을 (H, W, 3) BGR uint8 이미지로 매핑합니다(유효하지 않은 픽셀 <= 0은 검은색으로 표시됩니다).
result.plot()은 기본값(cmap="jet", mode="disparity")을 사용해 이 색상화를 입력 이미지에 이미 합성합니다. 독립적인 컬러 깊이 이미지나 다른 컬러맵 또는 정규화가 필요하면 colorize_depth을 직접 호출하세요.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# 가까운 곳은 따뜻한 색으로 표시해 색상화한 다음 저장합니다
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# 프레임 간 색상이 동일한 거리를 나타내도록 범위를 0~20 m로 고정합니다
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Results 객체에서 바로 가져온 합성 오버레이(cmap="jet", mode="disparity" 사용)
result.save("depth_overlay.png")
모든 컬러맵은 차가운/어두운 색에서 따뜻한/밝은 색으로 이어집니다. mode은 어느 쪽이 가까운지를 결정하고, vmin/vmax는 프레임 간 범위를 고정하여 색상이 항상 동일한 거리를 나타내도록 합니다.
| 인수 | 값 | 설명 |
|---|---|---|
cmap | jet(기본값) | 높은 대비의 파랑 → 초록 → 빨강 팔레트로, result.plot()에서 사용합니다. |
cmap | inferno | 검정 → 보라 → 주황 → 노랑입니다. 지각적으로 균일하고 색각 이상이 있는 사용자도 구분할 수 있으며, 그레이스케일에서도 읽기 쉽습니다. |
cmap | spectral | 빨강 → 노랑 → 초록 → 파랑입니다(matplotlib Spectral_r). |
mode | disparity(기본값) | 역깊이(1/d)를 2~98 백분위수 사이로 정규화합니다. 따뜻한 색은 가까운 곳을 나타내며, 원거리 이상치는 흡수됩니다. |
mode | metric | 깊이를 미터 단위로 vmin과 vmax 사이에서 선형 정규화합니다. 따뜻한 색은 먼 곳을 표시하므로 색상이 실제 거리에 대응합니다. |
내보내기#
YOLO26n-depth 모델을 ONNX, CoreML 등 다른 형식으로 내보냅니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-depth.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델을 내보냅니다
model.export(format="onnx")
YOLO26 깊이 추정에 사용할 수 있는 내보내기 형식은 아래 표에 나와 있습니다. format 인수를 사용해 원하는 형식으로 내보낼 수 있습니다(예: format='onnx' 또는 format='engine'). 내보낸 모델에서 직접 예측 또는 검증을 수행할 수 있습니다(예: yolo predict model=yolo26n-depth.onnx). 내보내기가 완료되면 해당 모델의 사용 예제가 표시됩니다.
| 형식 | format 인수 | 모델 | 메타데이터 | 인수 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None은 외부 NMS를 위한 원시 출력을 기본값으로 사용합니다. 사용 가능한 NMS-free head를 선택하려면 nms=False을 설정합니다. 지원되지 않는 형식은 해당 형식의 기본 출력 경로로 대체됩니다. 위의 nms 항목은 nms=True을 사용해 NMS를 포함할 수 있는 형식을 나타냅니다.
자세한 export 내용은 내보내기 페이지를 참조하세요.
자주 묻는 질문#
쌍을 이루는 RGB 이미지와 16비트 깊이 PNG 또는 미터 단위의 부동 소수점 NPY 깊이 맵을 준비한 다음,
images/디렉터리를 가리키는 데이터셋 YAML을 만듭니다. 로더는 경로의images을depth로 바꾸어 깊이 파일을 자동으로 찾으며,.png을 우선 사용하고 없으면.npy를 사용합니다.사전 학습된 가중치에서 시작하고 AdamW와 함께 낮은 학습률을 사용하여 미세 조정 중에도 모델이 이미 학습한 내용을 유지하도록 합니다(이유는 자체 데이터로 미세 조정하기 참조).
예제from ultralytics import YOLO # 사전 학습된 YOLO26 깊이 모델을 불러옵니다 model = YOLO("yolo26s-depth.pt") # 사용자 지정 깊이 데이터셋으로 미세 조정합니다 results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )사용 가능한 인수에 대한 자세한 내용은 Configuration 페이지를 참조하세요.
깊이 추정 검증에서는 Depth Anything 및 관련 단안 깊이 연구에서 사용하는 지표 집합을 보고합니다.
- delta1 / delta2 / delta3 — 예측 깊이와 정답 깊이의 비율(또는 그 역수)이 각각 1.25, 1.25², 1.25³ 미만인 픽셀의 비율입니다. 높을수록 좋습니다.
- abs_rel — 평균 절대 상대 오차입니다. 낮을수록 좋습니다.
- rmse — 미터 단위의 제곱 평균 제곱근 오차입니다. 낮을수록 좋습니다.
- silog — 스케일 불변 로그 오차입니다. 낮을수록 좋습니다.
각 이미지에서 예측값을 정답값에 중앙값 기준으로 정렬하고, 해당 이미지의 각 지표를 산출한 다음, 검증 세트에서 이미지별 결과를 평균합니다. 따라서 유효한 깊이 픽셀 수와 관계없이 모든 이미지의 가중치는 같습니다. 유효한 정답 깊이 픽셀이 10개 미만인 이미지는 제외되어 평균에 포함되지 않습니다. 픽셀 몇 개의 중앙값을 정렬하는 것은 의미가 없기 때문입니다. 유한하지 않은 예측값은 깊이 범위의 경계값으로 점수를 계산합니다. 이 방식은 Depth Anything V2에서 사용하는 샘플별 평균 및 최소 10픽셀 기준과 일치합니다.
깊이 맵은
(H, W)형태의torch.Tensor으로 저장되며, 각 값은 미터 단위의 예측 깊이입니다(NumPyfloat32배열에는result.depth.data.cpu().numpy()를 사용하세요). 예측을 실행한 후result.depth.data를 통해 접근할 수 있습니다. 맵은 입력 이미지 해상도에 맞춰 정렬됩니다.Ultralytics YOLO26에는 NYU Depth V2, KITTI, Hypersim, SUN RGB-D, ARKitScenes 등 여러 깊이 추정 데이터셋에 대한 기본 데이터셋 YAML 구성이 포함되어 있습니다. 전체 목록과 형식 세부 정보는 깊이 추정 데이터셋 가이드를 참조하세요.
평가에 사용할 데이터셋 YAML을 지정하여 사전 학습된 YOLO26 깊이 모델을 검증합니다.
예제from ultralytics import YOLO # 사전 학습된 모델 불러오기 model = YOLO("yolo26n-depth.pt") # 모델을 검증합니다 metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Python 또는 CLI를 사용해 YOLO26 깊이 모델을 ONNX로 내보냅니다.
예제from ultralytics import YOLO # 사전 학습된 모델 불러오기 model = YOLO("yolo26n-depth.pt") # 모델을 ONNX 형식으로 내보내기 model.export(format="onnx")다양한 형식으로 내보내는 방법에 대한 자세한 내용은 Export 페이지를 참조하세요.