Qualcomm QNN 내보내기
Qualcomm AI Engine Direct은 QNN이라고도 하며, Snapdragon 및 Dragonwing 프로세서의 Hexagon NPU용 Qualcomm 런타임입니다. format="qnn"를 사용하여 Ultralytics YOLO26 모델을 내보내면 yolo26n_qnn.onnx이 생성됩니다. 이는 사용자가 name 인수로 선택한 Hexagon Tensor Processor(HTP) 세대용으로 INT8 가중치와 16비트 활성화 함수를 사용해 컴파일된 QNN 컨텍스트 바이너리만 포함하는 ONNX 모델입니다. 내보내기는 ONNX Runtime을 사용해 사용자의 컴퓨터에서 실행되며 Qualcomm 계정이나 장치가 필요하지 않습니다.
한눈에 보기#
| 속성 | 세부 정보 |
|---|---|
format 인수 | qnn |
| 출력 | yolo26n_qnn.onnx, 하나의 ONNX 파일, 컴파일된 QNN 컨텍스트 바이너리를 포함하는 EPContext 노드, 클래스 이름, task 및 이미지 크기를 메타데이터로 제공합니다. |
| 실행 환경 | name으로 설정된 HTP 세대의 Hexagon NPU: Snapdragon 888부터 8 Elite Gen 5까지의 Snapdragon 휴대폰, Snapdragon X Elite 노트북, Dragonwing IQ-8275입니다. 지원되는 HTP 대상을 참조하세요. |
| 런타임 | QNN Execution Provider를 사용하는 ONNX Runtime: Windows 및 Linux에서는 onnxruntime-qnn Python 패키지를 사용하거나, Android 앱에서 QNN을 포함한 ONNX Runtime을 사용합니다. |
| 정밀도 | W8A16만 지원합니다. data의 이미지로 보정한 INT8 가중치와 16비트 활성화입니다. YOLO26n은 3.6 MB입니다. |
| 내보내기 호스트 | Python 3.11 이상이 설치된 Linux x86-64 또는 ARM64, Windows x64 또는 ARM64가 필요합니다. macOS는 지원하지 않습니다. x86-64 Ubuntu 24.04에서 테스트했습니다. 내보내기는 CPU에서 실행되므로 GPU나 Snapdragon 장치가 필요하지 않습니다. |
Ultralytics Platform에서 학습된 모델을 선택한 HTP 대상용 QNN으로 내보낼 수 있으므로 로컬 내보내기 환경이 필요하지 않습니다.
빠른 시작#
ONNX 내보내기 종속성과 QNN Execution Provider를 포함하여 Ultralytics 패키지를 설치합니다:
pip install "ultralytics[export-base]" onnxruntime-qnnonnxruntime-qnn에는 Qualcomm AI Runtime (QAIRT) 라이브러리가 포함되어 있으며, 필수 패키지인 onnxruntime과 함께 설치됩니다. 기본 pip install ultralytics를 사용하는 경우 첫 내보내기에서 onnx, onnxslim, onnxruntime, onnxruntime-qnn을 직접 설치하고 Restart runtime or rerun command for updates to take effect을 로그에 남기지만, 동일한 실행에서 내보내기를 완료합니다. 내보내기에는 다음 버전 요구 사항이 적용됩니다:
| 요구 사항 | 버전 |
|---|---|
| Python | 3.11~3.14이며, onnxruntime-qnn 2.x 패키지가 제공되는 버전입니다. Python 3.11, 3.12, 3.14에서 내보내기를 실행했습니다. |
| 운영 체제 | glibc 2.35 이상을 사용하는 Linux x86-64, glibc 2.34 이상을 사용하는 Linux ARM64, Windows x64 또는 ARM64가 필요합니다. onnxruntime-qnn에는 macOS용 패키지가 없습니다. 제한 사항을 참조하세요. |
onnxruntime-qnn | 이 페이지의 모든 내보내기에는 onnxruntime 1.32.0과 함께 2.8.0을 사용했습니다. Ultralytics는 버전을 고정하지 않습니다. |
다른 설치 방법은 설치 가이드를 참조하세요. 그런 다음 모델을 내보냅니다.
from ultralytics import YOLO

# YOLO26 모델 로드
model = YOLO("yolo26n.pt")

# Snapdragon 8 Elite Gen 5(HTP v81)용으로 모델을 QNN 형식으로 내보냅니다.
model.export(format="qnn", name="81", imgsz=640)  # 'yolo26n_qnn.onnx'를 생성합니다.
내보내기는 yolo26n_qnn.onnx을 yolo26n.pt 옆에 기록하며, 해당 파일이 이미 있으면 실패합니다. 다시 내보내기 전에 파일을 삭제하거나 이름을 변경하세요. data를 지정하지 않으면 task의 소규모 기본 데이터셋(예: coco8.yaml의 이미지 4장)을 사용해 보정합니다. 이는 내보내기 테스트에는 충분하지만, 모델을 배포하기 전에 배포 데이터의 이미지로 보정해야 합니다. 보정을 참조하세요.
그런 다음 yolo26n_qnn.onnx을 Snapdragon 장치로 복사합니다. 배포를 참조하세요. Predict와 Validate도 x86-64 Linux 내보내기 호스트에서 느리게 실행되므로, 파일을 복사하기 전에 내보낸 파일을 확인할 수 있습니다. 한 프로세스에서 두 번째 QNN 모델을 실행하면 실패하므로 각 명령을 새 Python 프로세스에서 실행하세요. 제한 사항을 참조하세요:
from ultralytics import YOLO

# 내보낸 QNN 모델을 불러옵니다.
model = YOLO("yolo26n_qnn.onnx")

# 추론 실행
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# 내보낸 QNN 모델을 불러옵니다.
model = YOLO("yolo26n_qnn.onnx")
# COCO8 데이터셋에서 정확도 검증
metrics = model.val(data="coco8.yaml")지원 작업#
QNN 내보내기는 Ultralytics의 7가지 task인 객체 탐지, 세그멘테이션, 시맨틱 세그멘테이션, 깊이 추정, 분류, 포즈 추정, OBB를 모두 지원합니다. 시맨틱 세그멘테이션과 깊이 추정은 해당 헤드를 제공하는 유일한 제품군인 YOLO26에서만 사용할 수 있습니다. 모든 task의 YOLO26n 체크포인트와 YOLO11 객체 탐지 모델을 내보내기 호스트에서 내보내고 실행했습니다. 다른 모델 제품군은 테스트하지 않았습니다.
내보내기 인수#
| 인수 | 유형 | 기본값 | 설명 |
|---|---|---|---|
format | str | 'qnn' | 내보낸 모델의 대상 형식으로, 다양한 배포 환경과의 호환성을 정의합니다. |
name | str | '73' | 컨텍스트 바이너리를 컴파일하는 HTP 세대 또는 SoC입니다(예: '81' 또는 'iq-8275'). 지원되는 HTP 대상을 참조하세요. |
imgsz | int 또는 tuple | 640 | 컨텍스트 바이너리에 고정되는 모델 입력 이미지 크기입니다. 정사각형 이미지에는 정수를, 그 외에는 튜플 (height, width)을 사용합니다. 지정하지 않으면 체크포인트 학습에 사용된 크기를 사용합니다. 예를 들어 OBB에는 1024, 분류에는 224를 사용합니다. |
quantize | int 또는 str | None | 정밀도입니다. 설정하지 않거나 'w8a16'을 지정하면 유일하게 지원되는 정밀도인 INT8 가중치와 16비트 활성화로 빌드합니다. 8, 16, 32을 지정하면 오류가 발생합니다. 정밀도를 참조하세요. 더 이상 사용되지 않는 half/int8 플래그를 대체합니다. |
data | str | None | 보정 이미지가 포함된 데이터셋 YAML입니다. 분류의 경우 데이터셋 디렉터리 또는 기본 제공 데이터셋 이름을 사용합니다. split을 설정하지 않으면 val 분할을 사용해 보정합니다. 생략하면 Ultralytics는 task의 소규모 기본 데이터셋(예: coco8.yaml)을 사용합니다. |
fraction | float, int 또는 list | 1.0 | 보정 하위 집합: 비율, 이미지 개수(1보다 큰 정수) 또는 [train, val, test] 목록을 지정할 수 있으며, 이 경우 보정 분할에 해당하는 항목이 사용됩니다. |
batch | int | 1 | 내보낸 모델의 배치 크기이며 입력 형상에 고정됩니다. 보정에 사용되는 배치 크기이기도 합니다. |
nms | bool, 선택 사항 | None | 효과가 없습니다. 모든 값에서 None의 원시 출력을 기록합니다. 출력 형식을 참조하세요. |
opset | int | None | 중간 ONNX 그래프의 ONNX opset 버전입니다. 지정하지 않으면 PyTorch 버전에서 지원하는 가장 높은 opset을 사용하되 18을 초과하지 않습니다. PyTorch 2.4 이상에서는 18입니다. ONNX Runtime 양자화기는 16비트 활성화를 위해 opset을 21로 올립니다. |
simplify | bool | True | onnxslim을 사용하여 중간 ONNX 그래프를 간소화합니다. |
device | str | None | 중간 ONNX 그래프를 추적하는 장치입니다. 기본값은 cpu입니다. |
모든 형식에 공통으로 적용되는 인수는 내보내기 모드 문서를 참조하세요.
공식 QNN, LiteRT, Core ML 모바일 모델은 imgsz=640로 내보내며, 분류 모델은 imgsz=224으로 내보냅니다. Cityscapes 시맨틱, 깊이, OBB 체크포인트는 기본적으로 더 큰 크기로 내보내므로, 해당 모델과 크기를 맞추려면 imgsz=640를 지정하세요. 모든 크기의 7가지 task용 QNN 모델(HTP v73 및 v81)은 yolo-flutter-app v0.7.0 릴리스에 있습니다.
지원되는 HTP 대상#
컨텍스트 바이너리는 하나의 HTP 세대용으로 컴파일되므로 장치의 name을 사용해 내보내세요. Flutter 플러그인 README에서는 공식 _v73 모델의 요구 사항으로 Snapdragon 8 Gen 2 이상을 명시합니다. 그 외 내보내기 세대와 장치 세대 조합은 테스트하지 않았습니다. name에는 세대를 입력할 때 앞에 v을 붙이거나 생략할 수 있습니다. 예를 들어 81, v81, V81 또는 두 SoC 이름 중 하나를 대소문자 구분 없이 사용할 수 있습니다. 크기는 imgsz=640의 YOLO26n 객체 탐지 모델 기준입니다:
name | Hexagon HTP | 예시 장치 | ONNX Runtime 옵션 | YOLO26n 파일 |
|---|---|---|---|---|
68 | v68 | Snapdragon 888 | htp_arch=68 | 3.7 MB |
69 | v69 | Snapdragon 8 Gen 1 | htp_arch=69 | 3.8 MB |
73(기본값) | v73 | Snapdragon 8 Gen 2, Snapdragon X Elite | htp_arch=73 | 3.6 MB |
75 | v75 | Snapdragon 8 Gen 3 | htp_arch=75 | 3.6 MB |
79 | v79 | Snapdragon 8 Elite (SM8750) | soc_model=69 | 3.6 MB |
81 | v81 | Snapdragon 8 Elite Gen 5 | htp_arch=81 | 3.6 MB |
iq-8275 | v75 | Dragonwing IQ-8275 | soc_model=82 | 3.5 MB |
qcs8275 | v75 | Dragonwing QCS8275 | soc_model=82 | 3.5 MB |
Snapdragon 장치는 세대별 예시이며 전체 목록은 아닙니다. name을 지정하지 않으면 내보내기에서 Qualcomm QNN export requires a missing 'name' arg for the target Hexagon HTP architecture. Using default name='73' (Snapdragon 8 Gen 2).을 로그에 남깁니다. 다른 값을 지정하면 Invalid Qualcomm QNN target '66'. Valid targets are ('68', '69', '73', '75', '79', '81', 'iq-8275', 'qcs8275').와 함께 실패합니다. Dragonwing IQ-615(QCS615)에는 Hexagon v66 DSP가 있지만 Ultralytics에서 지원하는 QNN 대상이 없습니다. 대신 CPU 또는 GPU용 표준 ONNX 모델을 내보내세요.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="qnn", name="iq-8275", imgsz=640) # 'yolo26n_qnn.onnx'를 생성합니다.정밀도#
모든 QNN 내보내기는 ONNX Runtime의 QNN QDQ 흐름으로 양자화되어 INT8 가중치와 16비트 활성화(W8A16)를 사용합니다. FP32 또는 FP16 내보내기, 8비트 활성화를 사용하는 INT8 내보내기는 지원하지 않습니다:
quantize | 결과 |
|---|---|
설정 해제 또는 'w8a16' | W8A16 컨텍스트 바이너리입니다. YOLO26n은 3.6 MB입니다. quantize을 지정하지 않으면 내보내기에서 qnn export requires INT8 quantization, enabling it.을 로그에 남깁니다. |
8 | quantize=8 (INT8) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations).에서 실패합니다. |
16 | quantize=16 (FP16) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations).에서 실패합니다. |
32 | quantize=32 (FP32) is not supported; format='qnn' supports quantize='w8a16' (INT8 weights + INT16 activations).에서 실패합니다. |
입력과 출력은 float32으로 유지됩니다. 단, 시맨틱 클래스 맵은 예외입니다. 입력 양자화와 출력 역양자화가 컨텍스트 바이너리 내에서 실행되기 때문입니다.
보정#
내보내기는 data의 val 분할에서 전체 배치마다 활성화 범위를 보정하거나, split로 지정한 분할을 사용하며, 이미지가 300장 미만이면 >300 images recommended for INT8 calibration, found 4 images. 경고를 표시합니다. 배포 데이터와 유사한 이미지를 포함한 data를 전달하고, 이미지 수를 제한하려면 fraction를 사용하세요. 처음 사용할 때 coco.yaml은 COCO 데이터셋 전체(약 20 GB)를 다운로드합니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# COCO 검증 이미지의 10%(이미지 500개)로 보정합니다. coco.yaml을 자체 데이터셋으로 바꾸세요.
model.export(format="qnn", name="81", imgsz=640, data="coco.yaml", fraction=0.1)
보정에 사용되지 않은 COCO val2017의 마지막 이미지 500장을 대상으로, YOLO26n은 x86-64 내보내기 호스트에서 val 기준으로 다음 점수를 기록했습니다. 같은 이미지에서 PyTorch 체크포인트 및 FP32 ONNX 내보내기와 비교한 결과입니다:
| 모델 | mAPval 50-95 | mAPval 50 |
|---|---|---|
| PyTorch | 42.1 | 57.1 |
| ONNX FP32 | 42.0 | 56.9 |
coco8.yaml(이미지 4장)으로 보정한 QNN | 38.9 | 54.6 |
coco.yaml과 fraction=0.1(이미지 500장)로 보정한 QNN | 39.1 | 54.5 |
coco8.yaml의 이미지 4장 대신 COCO 이미지 500장으로 보정했을 때 mAPval 50-95는 0.2포인트 상승하고 mAPval 50은 0.1포인트 하락했습니다. 두 QNN 모델 모두 mAPval 50-95에서 FP32 ONNX 내보내기보다 2.9~3.1포인트 낮은 점수를 기록했습니다. 기본 소규모 데이터셋에서는 깊이 추정의 성능 하락이 가장 컸습니다. 보정 이미지와 동일한 depth8.yaml의 검증 이미지 4장에서 QNN 깊이 모델의 delta1은 56.0%로, FP32 ONNX 내보내기의 89.7%와 비교됩니다. 배포 전에 자체 데이터에서 내보낸 모델을 검증하세요.
출력 형식#
내보내기는 파일 하나를 기록하고 중간 ONNX 모델은 그 파일 옆에 보관합니다:
| 파일 | 내용 |
|---|---|
yolo26n_qnn.onnx | 컴파일된 QNN 컨텍스트 바이너리를 포함하는 하나의 EPContext 노드가 있는 ONNX 모델입니다. 또한 클래스 이름, task, 이미지 크기, 배치 크기, stride 및 내보내기 인수를 ONNX 메타데이터로 저장하며, Ultralytics는 모델을 불러올 때 이를 읽습니다. |
yolo26n.onnx | 양자화된 FP32 ONNX 그래프이며, 입력은 동일한 channels-last 형식입니다. 같은 디렉터리에서 동일한 체크포인트를 이전에 내보낸 yolo26n.onnx 파일이 있으면 이를 대체합니다. 배포에는 필요하지 않습니다. YOLO()은 이 파일을 실행할 수 없으며 Got invalid dimensions for input: images와 함께 실패합니다. |
모델은 (batch, height, width, 3) 형태의 images 입력 하나를 받습니다. 입력은 RGB, channels-last(NHWC), float32이며, 값은 0~1 범위로 정규화됩니다. 이는 ONNX 내보내기의 channels-first 입력과 다르며 카메라 프레임 및 HTP의 레이아웃과 일치합니다. 출력 형태는 기본 ONNX 내보내기와 같습니다. 아래 형태는 공식 모바일 모델 크기인 imgsz=640의 YOLO26n 체크포인트와 분류용 imgsz=224를 기준으로 하며, 시맨틱 세그멘테이션에는 Cityscapes 체크포인트 yolo26n-sem.pt을 사용합니다:
| 작업 | imgsz | 출력 |
|---|---|---|
| 감지 | 640 | (1, 84, 8400) |
| 분할 | 640 | (1, 116, 8400) 및 (1, 32, 160, 160) |
| 의미론적 | 640 | (1, 640, 640), uint8: 각 픽셀의 클래스 인덱스 |
| 깊이 | 640 | (1, 1, 640, 640): 깊이 맵 |
| 분류 | 224 | (1, 1000): 클래스 확률 |
| 포즈 | 640 | (1, 56, 8400) |
| OBB | 640 | (1, 20, 8400) |
- 원시 출력: 각 anchor마다 입력 픽셀 단위의 박스 중심 x, 중심 y, 너비, 높이가 나오고, 이어서 클래스 점수와 task 값(마스크 계수 32개, 키포인트 값 17 x 3개 또는 라디안 단위의 OBB 각도)이 출력됩니다. NMS를 직접 적용해야 합니다. 각 task의 레이아웃은 ONNX 출력 형식을 참조하세요. NMS가 없는 출력이나 NMS가 내장된 출력은 없습니다.
nms=False은This export format does not support end2end models, disabling the end2end branch.를 로그에 남기고nms=True은format=qnn does not support embedded NMS; using nms=None.를 로그에 남기며, 두 경우 모두 이 원시 출력을 기록합니다. - 시맨틱 세그멘테이션: 출력은 모든 픽셀의 클래스 인덱스를
uint8으로 표시합니다(클래스가 256개를 초과하는 모델은int32). 각 클래스의 점수가 아니라 NPU에서 계산된 결과입니다. - 인스턴스 분할: 두 번째 출력에는 마스크 프로토타입이 들어 있습니다.
- ONNX와 동일한 레이아웃: 각 task의 이미지 하나에서 모든 QNN 모델 출력은 동일한 체크포인트의 FP32 ONNX 내보내기 출력과 형태 및 유형이 같았습니다. 객체 탐지, 세그멘테이션, 포즈, OBB의 첫 번째 출력은 0.999 이상의 상관관계를 보였고 세그멘테이션 마스크 프로토타입은 0.95였습니다. 분류(상관관계 0.76), 시맨틱 세그멘테이션(픽셀의 69% 일치), 깊이 추정(상관관계 0.24)은 원시 출력 차이가 더 컸습니다. 소규모 기본 데이터셋의
val에서는 깊이 추정의 성능 하락이 가장 컸습니다. 보정을 참조하세요.
YOLO("yolo26n_qnn.onnx")은 ONNX 메타데이터에서 레이아웃을 읽으므로, 자체 코드에서 모델을 실행할 때만 이 세부 정보가 필요합니다. 메타데이터 키에는 names, task, imgsz, stride, batch, end2end, args이 포함되며 포즈 모델에는 kpt_shape도 포함됩니다.
ONNX Runtime으로 실행#
Ultralytics 패키지 외부에서 모델을 실행하려면 onnxruntime-qnn의 QNN Execution Provider를 ONNX Runtime에 등록하고 HTP 백엔드 라이브러리 경로를 지정하세요. onnxruntime-qnn 2.x가 필요하며, 해당 버전에서 onnxruntime_qnn 모듈을 제공합니다. x86-64 내보내기 호스트에서 실행했으며 Snapdragon 장치에서는 실행하지 않았습니다:
# 먼저 내보냅니다: yolo export model=yolo26n.pt format=qnn name=81 imgsz=640
import ast

import numpy as np
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]
options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)

image = np.zeros((1, 640, 640, 3), dtype=np.float32)  # 레터박스 처리된 이미지: RGB, NHWC, 0-1
output = session.run(None, {session.get_inputs()[0].name: image})[0]
assert output.shape == (1, 84, 8400), "export a detection model at imgsz=640"

names = ast.literal_eval(session.get_modelmeta().custom_metadata_map["names"]) # {0: 'person', 1: 'bicycle', ...}배포#
Windows on Snapdragon 노트북 또는 BSP가 HTP 런타임을 제공하는 Linux ARM64 보드(Qualcomm Linux 보드 참조)에서 pip install ultralytics onnxruntime-qnn을 사용해 패키지를 설치하고 yolo26n_qnn.onnx를 해당 장치로 복사합니다. 그러면 YOLO("yolo26n_qnn.onnx")이 QNN Execution Provider를 등록하고 HTP 백엔드로 컨텍스트 바이너리를 실행합니다. 이 페이지용으로 onnxruntime-qnn 2.8.0을 사용해 내보낸 모델은 Snapdragon 장치에서 실행하지 않았습니다. Windows 측정값은 이전 v73 내보내기를 사용했습니다.
- HTP 일치: 장치의 HTP 세대에 해당하는
name으로 내보내세요. - Android 앱: Flutter 플러그인 README에는
_qnn.onnx모델에 사용하는 설정이 나와 있습니다.com.microsoft.onnxruntime1.29.0및com.qualcomm.qti2.51.0패키지와packagingOptions.jniLibs의useLegacyPackaging = true가 필요합니다. Hexagon DSP 로더에는 실제.so파일이 필요하기 때문입니다. 또한onnxruntime-qnn2.4 이상을 사용해 Ultralytics 8.4.188 이전에 내보낸 모델은Input name not found오류와 함께 로드에 실패한다고 명시되어 있습니다. 이 페이지의 내보내기 모델로는 이 설정을 실행하지 않았습니다. - NPU 전용: Snapdragon 장치에서 컨텍스트 바이너리는 HTP에서만 실행됩니다. Adreno GPU 또는 CPU를 사용하려면 대신 LiteRT 또는 표준 ONNX 모델을 내보내세요. Android 측정값에서는 CPU 및 GPU의 LiteRT와 NPU의 QNN을 비교합니다.
- 고정 입력 형태: 모델은 항상 내보내기 시 지정한
imgsz및batch에서 실행되며, Ultralytics는 이를 ONNX 메타데이터에서 읽습니다.predict또는val에 전달된imgsz는 무시됩니다. 더 작은 배치는 패딩 처리되며batch=2모델은 이미지 1장 및 3장으로도 예측을 실행했습니다. - 프로세스당 QNN 모델 하나: 두 번째 QNN 모델을 불러오거나
predict실행 후val을 실행하려면 새 Python 프로세스에서 실행하세요. 제한 사항을 참조하세요. - 파일 이름: 파일 이름 끝에
_qnn.onnx을 유지하세요. Ultralytics는 이를 기준으로 형식을 인식합니다.yolo26n_npu.onnx이라는 이름으로 복사하면 일반 ONNX 모델로 불러오며EPContext node generated by 'QNNExecutionProvider' is not compatible with any execution provider added to the session.와 함께 실패합니다.
Ultralytics Flutter Plugin#
Ultralytics YOLO Flutter 플러그인은 7가지 YOLO26 task의 QNN 내보내기를 Android에서 실행하여 실시간 카메라 추론과 단일 이미지 예측을 지원합니다. QNN 지원은 기본적으로 비활성화되어 있습니다. 플러그인 README의 안내에 따라 QNN 런타임을 활성화하고 ONNX Runtime 종속성을 추가하세요. 이 페이지의 Android 측정값은 이 플러그인으로 측정했습니다. iOS는 Ultralytics iOS SDK 및 Core ML 통합을 참조하세요.
Qualcomm Linux 보드#
Qualcomm Linux 또는 Yocto BSP를 사용하는 IQ-8275 등의 Dragonwing 보드에서는 런타임이 보드 공급업체의 QAIRT 지원 BSP에 포함되며 내보낸 모델에는 포함되지 않습니다. HTP 추론을 위해 BSP는 ONNX Runtime QNN Execution Provider, libQnnSystem.so, libQnnHtp.so, 보드의 HTP 세대(IQ-8275의 경우 v75)에 해당하는 HTP 스텁 및 스켈레톤 라이브러리, libcdsprpc.so 등의 FastRPC 사용자 공간 지원, DSP 펌웨어, 그리고 이에 맞는 FastRPC 커널 드라이버를 제공해야 합니다. 스켈레톤 라이브러리는 BSP의 DSP 라이브러리 경로에 있어야 합니다. GPU 실행에는 대신 libQnnGpu.so과 Adreno 사용자 공간 드라이버가 필요하며, 표준 ONNX 내보내기를 사용해야 합니다. _qnn.onnx 파일은 HTP를 대상으로 하기 때문입니다.
배포 가이드#
- ONNX Runtime QNN Execution Provider: 옵션, 지원되는 연산자, 그리고
_qnn.onnx파일을 로드하는 Provider의 Android 및 Windows 패키지입니다. - Qualcomm AI Engine Direct SDK: QNN 및 QAIRT에 대한 Qualcomm의 참조 자료입니다.
- Ultralytics YOLO Flutter 플러그인: QNN, LiteRT, Core ML 모델을 사용하는 Android 앱입니다.
- LiteRT 및 MediaTek Dimensity: CPU 및 GPU, MediaTek NPU에서의 Android 배포입니다.
- 모델 배포 옵션: QNN을 다른 내보내기 형식과 비교합니다.
제한 사항 및 문제 해결#
- macOS 및 Python 3.10:
onnxruntime-qnn2.x는 Linux 및 Windows에서 Python 3.11~3.14용 패키지만 제공합니다. macOS 및 Python 3.10을 사용하는 Linux에서는onnxruntime-qnn설치가 실패합니다(pip에서No matching distribution found for onnxruntime-qnn를 보고함). 내보내기는 계속 진행되어 모델을 양자화한 뒤Failed to load library .../onnxruntime/capi/libonnxruntime_providers_qnn.so오류와 함께 실패합니다. Python 3.10을 사용하는 Windows x64에서는 pip가 이전 버전인onnxruntime-qnn1.23.2를 설치하지만, 해당 버전은 테스트하지 않았습니다. Python 3.11 이상을 사용하는 Linux 또는 Windows, 또는 Ultralytics Platform에서 내보내세요. - 자동 설치 비활성화:
YOLO_AUTOINSTALL=false을 사용하고onnxruntime-qnn이 없으면 내보내기에서Ultralytics requirement ['onnxruntime-qnn'] not found, AutoUpdate disabled by YOLO_AUTOINSTALL=False를 로그에 남기고 동일한Failed to load library오류와 함께 실패합니다. 빠른 시작의 안내에 따라 설치하세요. - 기존 출력 파일: 내보내기는
yolo26n_qnn.onnx을.pt파일 옆에 기록하지만 ONNX Runtime은 해당 파일을 덮어쓰지 않습니다. 파일이 이미 있으면 내보내기가Failed to generate EP context model since the file '"yolo26n_qnn.onnx"' exists already. Please remove the EP context model if you want to re-generate it.와 함께 실패하며 Python 프로세스가 세그멘테이션 폴트로 종료될 수 있습니다. 다른name,imgsz,data를 내보낼 때도 이전 파일을 삭제하거나 이름을 변경하세요. - 한 프로세스에서 두 번째 QNN 모델 실행: 두 번째
_qnn.onnx모델을 불러오거나 QNN 모델로predict를 실행한 뒤val또는 내보내기를 실행하면EP library is already registered under QNNExecutionProvider오류와 함께 실패합니다. 동일한YOLO객체로 여러 번 예측하는 것은 가능하며, 내보내기 직후predict를 실행하는 것도 가능합니다.yoloCLI처럼 모델마다 새 Python 프로세스를 사용하세요. - 고정 입력 형태:
dynamic=True은argument 'dynamic' is not supported for format='qnn'오류와 함께 실패합니다. 이미지 크기나 배치 크기를 변경하려면 다시 내보내세요. data없이 보정: 내보내기에서INT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.을 로그에 남기고 task의 소규모 기본 데이터셋을 사용해 보정합니다. 배포 데이터를 대표하는 이미지가 포함된data를 전달하세요.- Opset 경고:
opset=21을 전달하지 않으면 ONNX Runtime 양자화기가The original model opset version is 18, which does not support 16-bit integer quantization natively. Please update the model to opset >= 21. Automatically update the model to opset 21. Please verify the quantized model.을 로그에 남깁니다. 이때 18 대신 내보내기의 opset을 사용하고 그래프를 opset 21로 올립니다. 내보내기는 계속 진행되며 별도 조치는 필요하지 않습니다. quantize=8으로 학습된 체크포인트: 양자화 인식 학습으로 미세 조정한 체크포인트는format='qnn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends와 함께 실패합니다. 대신 미세 조정을 시작할 때 사용한 체크포인트를 내보내세요.- 내보내기 호스트에서의 추론: x86-64 Linux에서
onnxruntime-qnn은name=73및name=81컨텍스트 바이너리를 CPU에서 실행했습니다. 부하가 높은 서버 CPU에서는 YOLO26n 기준 이미지당 약 0.3초(분류)~16초(깊이)가 걸렸으며, 휴대폰에서는 밀리초 단위였습니다. 내보내기 결과 확인에 사용하고 속도 측정에는 사용하지 마세요.
그 밖의 오류는 일반적인 문제 가이드를 참조하세요.
측정 성능#
아래 표는 두 Snapdragon 장치에서 이미지 한 장의 지연 시간을 보여줍니다. 게시된 v0.7.0 HTP v81 모델(Android)과 이전 HTP v73 내보내기(Windows)에서 측정했으며, 이 페이지용으로 x86-64 Linux 서버에서 내보낸 모델의 크기도 표시합니다. 각 지연 시간 셀에는 전처리/추론/후처리 내역이 아래에 표시된 총 시간(밀리초)이 포함되며, 모델별 최단 시간 열은 굵게 표시됩니다. YOLO26 모델 페이지에서 PyTorch 체크포인트의 정확도를 확인할 수 있습니다.
Android 휴대폰#
하드웨어: 12 GB LPDDR5X 메모리와 Android 17 / API 37을 탑재한 Xiaomi 17입니다. 3 nm 공정의 Snapdragon 8 Elite Gen 5(SM8850)에는 8코어 Qualcomm Oryon CPU(최대 4.6 GHz의 Prime 코어 2개 및 최대 3.62 GHz의 Performance 코어 6개), Adreno GPU, Hexagon NPU(HTP v81)가 탑재되어 있습니다.
| 모델 | 작업 | 크기 (픽셀) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | 감지 | 640 | 36.9 1.9 / 32.6 / 2.3 | 10.6 1.8 / 6.2 / 2.6 | 10.2 1.9 / 6.0 / 2.3 |
| YOLO26n-seg | 분할 | 640 | 50.5 1.9 / 42.9 / 5.8 | 18.0 1.9 / 9.5 / 6.6 | 16.2 2.1 / 8.4 / 5.7 |
| YOLO26n-sem | 의미론적 | 640 | 45.7 1.9 / 35.7 / 8.2 | 30.6 1.9 / 20.5 / 8.3 | 10.8 2.0 / 6.2 / 2.6 |
| YOLO26n-depth | 깊이 | 640 | 66.8 2.2 / 55.0 / 9.7 | 21.9 2.1 / 10.1 / 9.8 | 19.3 2.2 / 7.4 / 9.7 |
| YOLO26n-cls | 분류 | 224 | 3.6 0.3 / 3.3 / 0.0 | 2.0 0.4 / 1.4 / 0.2 | 0.8 0.3 / 0.5 / 0.0 |
| YOLO26n-pose | 포즈 | 640 | 39.9 2.0 / 36.5 / 1.4 | 10.0 1.8 / 6.7 / 1.4 | 9.7 1.9 / 5.9 / 1.8 |
| YOLO26n-obb | OBB | 640 | 36.3 2.0 / 33.2 / 1.2 | 10.1 2.6 / 5.9 / 1.6 | 8.1 1.9 / 5.1 / 1.0 |
- 속도 값은 단일 이미지 버스트 지연 시간입니다.
bus.jpg에서 워밍업 3회 후 15회 실행한 평균값이며, Flutter 플러그인의0.7.1온디바이스 벤치마크 하니스와 공식v0.7.0에셋(Ultralytics 8.4.188 내보내기)을 사용해 측정했습니다. 하나의 순차 실행 과정에서 task마다 백엔드 순서를 바꾸었습니다. 네이티브 로그를 통해 모든 CPU 행은 LiteRT CPU/XNNPACK을 사용하고, 모든 GPU 행은 전체 그래프를 LiteRT OpenCL(LITERT_CL)에 위임하며, 모든 NPU 행은 QNN Hexagon HTP 백엔드를 사용하는 것을 확인했습니다. - CPU 및 GPU 열은 동일 릴리스의
w8a32LiteRT 모델을 나타내므로, 표에서 NPU를 동일한 휴대폰의 다른 프로세서와 비교할 수 있습니다. - 자세한 벤치마크 기록은 Flutter 성능 문서에서 확인할 수 있습니다.
- LiteRT 통합에서 MediaTek Dimensity 가이드를 포함한 다른 Android 장치를, Core ML 통합에서 Apple 장치를 비교하세요.
Snapdragon 탑재 Windows 노트북#
하드웨어: 메모리 32 GB와 Windows 11을 탑재한 Lenovo 노트북입니다. Snapdragon X Elite(X1E78100)에는 12코어 Qualcomm Oryon CPU, Adreno GPU, Hexagon NPU(HTP v73)가 탑재되어 있습니다. 정확한 Lenovo 모델명은 기록되지 않았습니다.
이전 측정에서는 PyTorch FP32 CPU 기준 성능과 Hexagon NPU의 QNN 모델을 비교했습니다. ultralytics 8.4.67, onnxruntime-qnn 2.2.0, torch 2.10.0+cpu, Python 3.12.10으로 측정했습니다. 224/640 모바일 크기가 표준이 되기 전에 내보낸 v73 모델을 사용했으므로 시맨틱 및 OBB 모델은 1024픽셀에서 실행되었으며 깊이 행은 없습니다. 각 셀에는 전체 model.predict() 경과 시간이 표시되고, 아래에는 보고된 전처리/추론/후처리 내역이 표시됩니다. 총 시간에는 이 세 단계 외부의 프레임워크 오버헤드가 포함될 수 있습니다.
| 모델 | 작업 | 크기 (픽셀) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | 감지 | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | 분할 | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | 의미론적 | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | 분류 | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | 포즈 | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- 속도 값은 단일 이미지 버스트 지연 시간입니다. 열적으로 안정된 장치에서
bus.jpg으로 워밍업 10회 후 100회 실행한 평균값이며,model.predict()전체 호출 시간을time.perf_counter()로 측정했습니다. - Hexagon NPU는 640 및 1024픽셀에서 PyTorch CPU 기준 성능보다 2.2~4.1배 빨랐고, 고정 전처리 시간이 더 큰 비중을 차지하는 224픽셀 분류 모델에서는 1.3배 빨랐습니다.
모델 크기#
YOLO26 객체 탐지 모델의 크기(MB, 10^6바이트)입니다. PyTorch 체크포인트와 imgsz=640 크기의 HTP v81용 _qnn.onnx 파일을 비교합니다. 내보내기 로그에는 크기가 MiB로 표시됩니다. YOLO26n v81의 경우 (3.5 MB)입니다:
| 모델 | PyTorch | QNN v81 |
|---|---|---|
| YOLO26n | 5.5 | 3.6 |
| YOLO26s | 20.4 | 11.1 |
| YOLO26m | 44.3 | 22.8 |
| YOLO26l | 53.2 | 27.9 |
| YOLO26x | 118.7 | 60.6 |
Snapdragon 하드웨어가 없는 x86-64 Linux 서버에서 ultralytics 8.4.215, onnxruntime-qnn 2.8.0, onnxruntime 1.32.0을 사용해 내보냈습니다. 보정 섹션에서 YOLO26n 내보내기의 COCO 정확도를 확인할 수 있습니다.
Qualcomm QNN 소개#
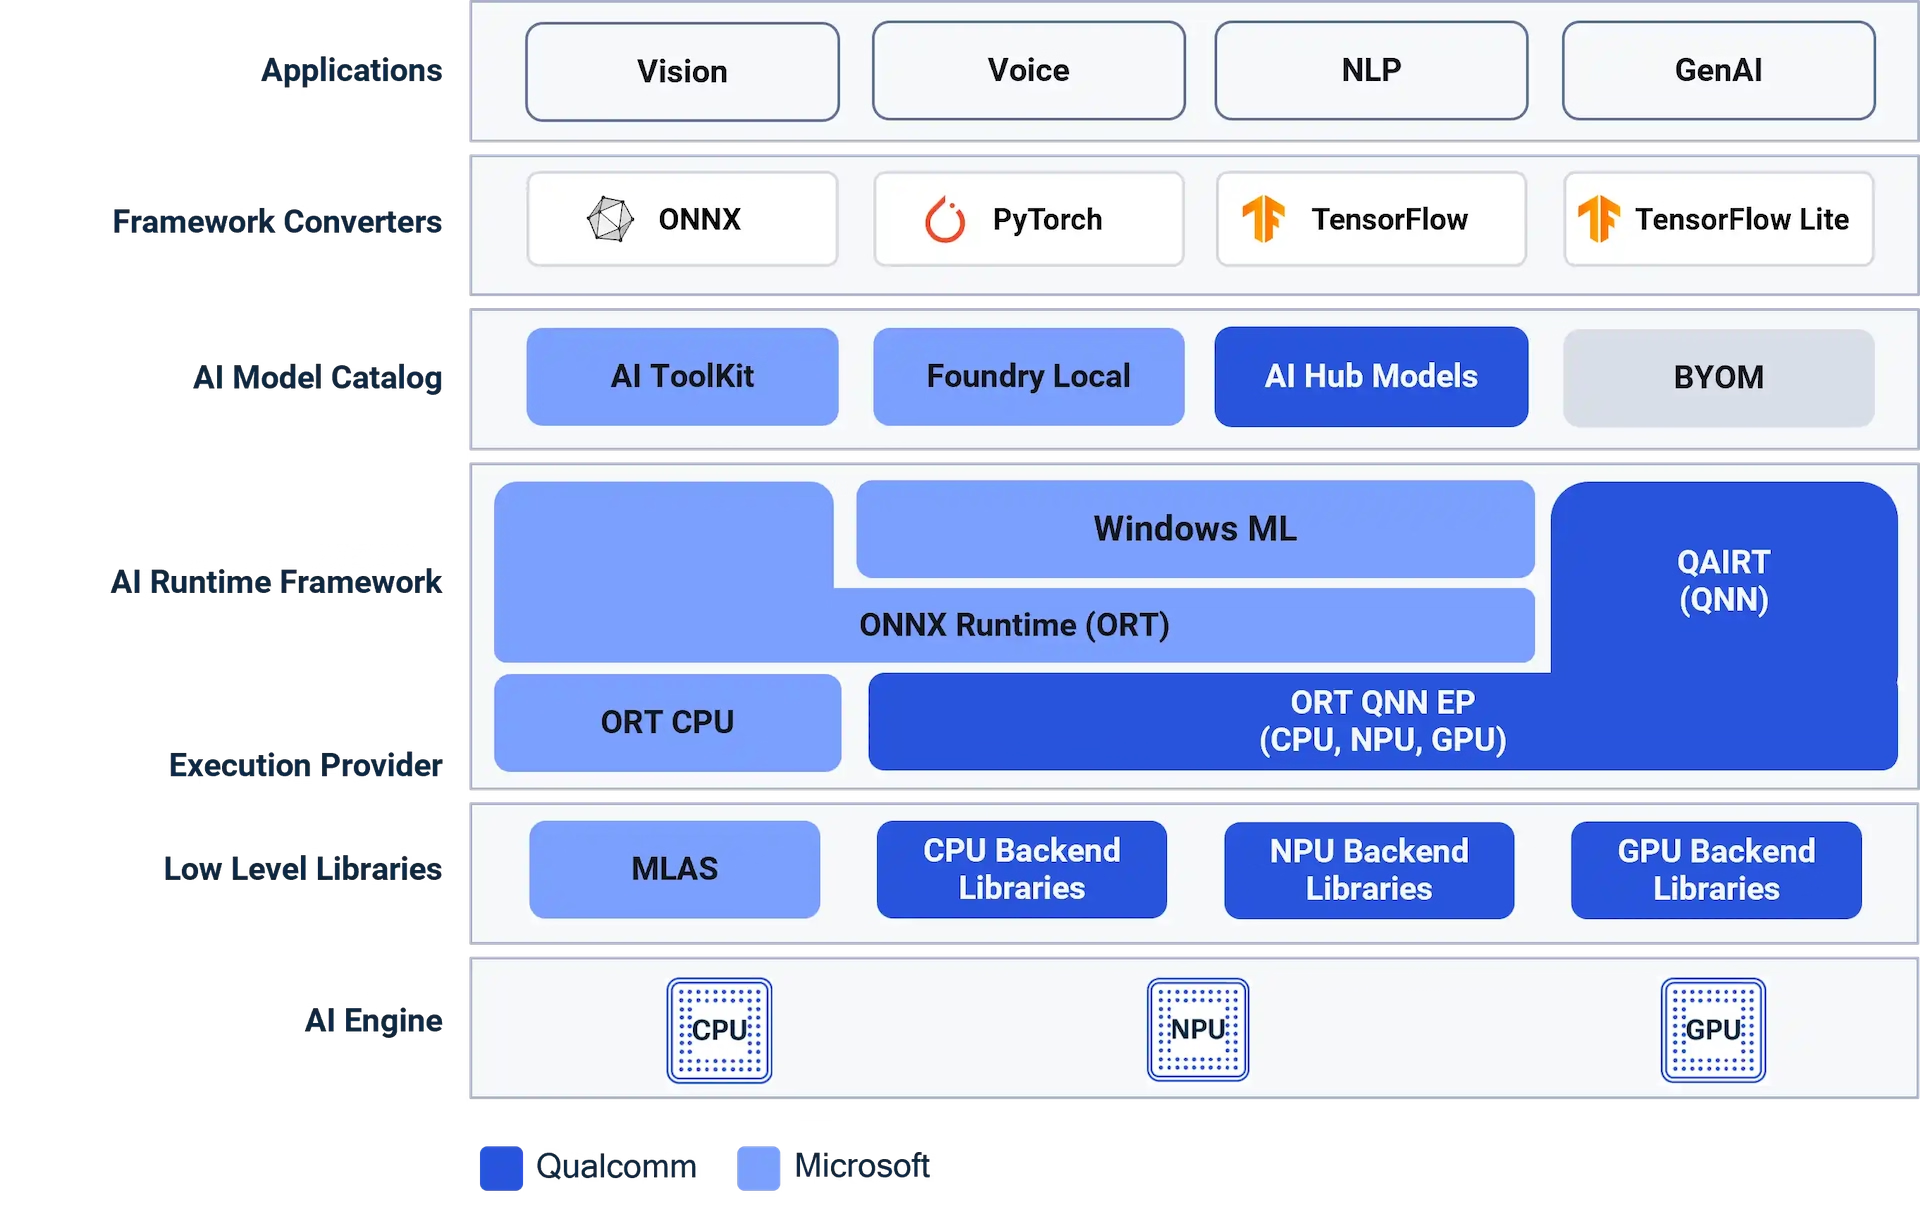
Qualcomm AI Engine Direct (QNN)는 Qualcomm AI Runtime (QAIRT) SDK의 일부이며, 각 프로세서에 해당하는 백엔드 라이브러리를 통해 Snapdragon 및 Dragonwing 프로세서의 CPU, Adreno GPU, Hexagon NPU에서 신경망을 실행합니다. 이전 Snapdragon Neural Processing Engine (SNPE) SDK를 대체합니다. Ultralytics는 ONNX Runtime QNN Execution Provider를 통해 HTP 백엔드를 사용합니다. 전체 참조 자료는 Qualcomm AI Engine Direct SDK를 참조하세요.
자주 묻는 질문#
아니요. 내보내기는 QAIRT 라이브러리가 포함된 PyPI의
onnxruntime-qnn패키지로 실행되며, 이 페이지용 내보내기는 모두 Qualcomm 계정, SDK 다운로드, Snapdragon 하드웨어 없이 x86-64 Linux 서버에서 실행했습니다. NPU 속도로 모델을 실행하려면 장치가 필요합니다.Qualcomm AI Hub는 호스팅된 Snapdragon 디바이스에서 모델을 컴파일하고 프로파일링하며 벤치마킹하는 Qualcomm의 클라우드 서비스이며, Qualcomm 계정이 필요합니다. Ultralytics 내보내기는
export(format="qnn")호출 한 번으로 동일한 Hexagon NPU용 QNN 컨텍스트 바이너리를 자체 컴퓨터에서 컴파일하므로 계정이나 업로드가 필요하지 않으며, 자체 디바이스에서 속도를 측정할 수 있습니다.


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.