Ultralytics YOLO를 사용한 시맨틱 세그멘테이션#
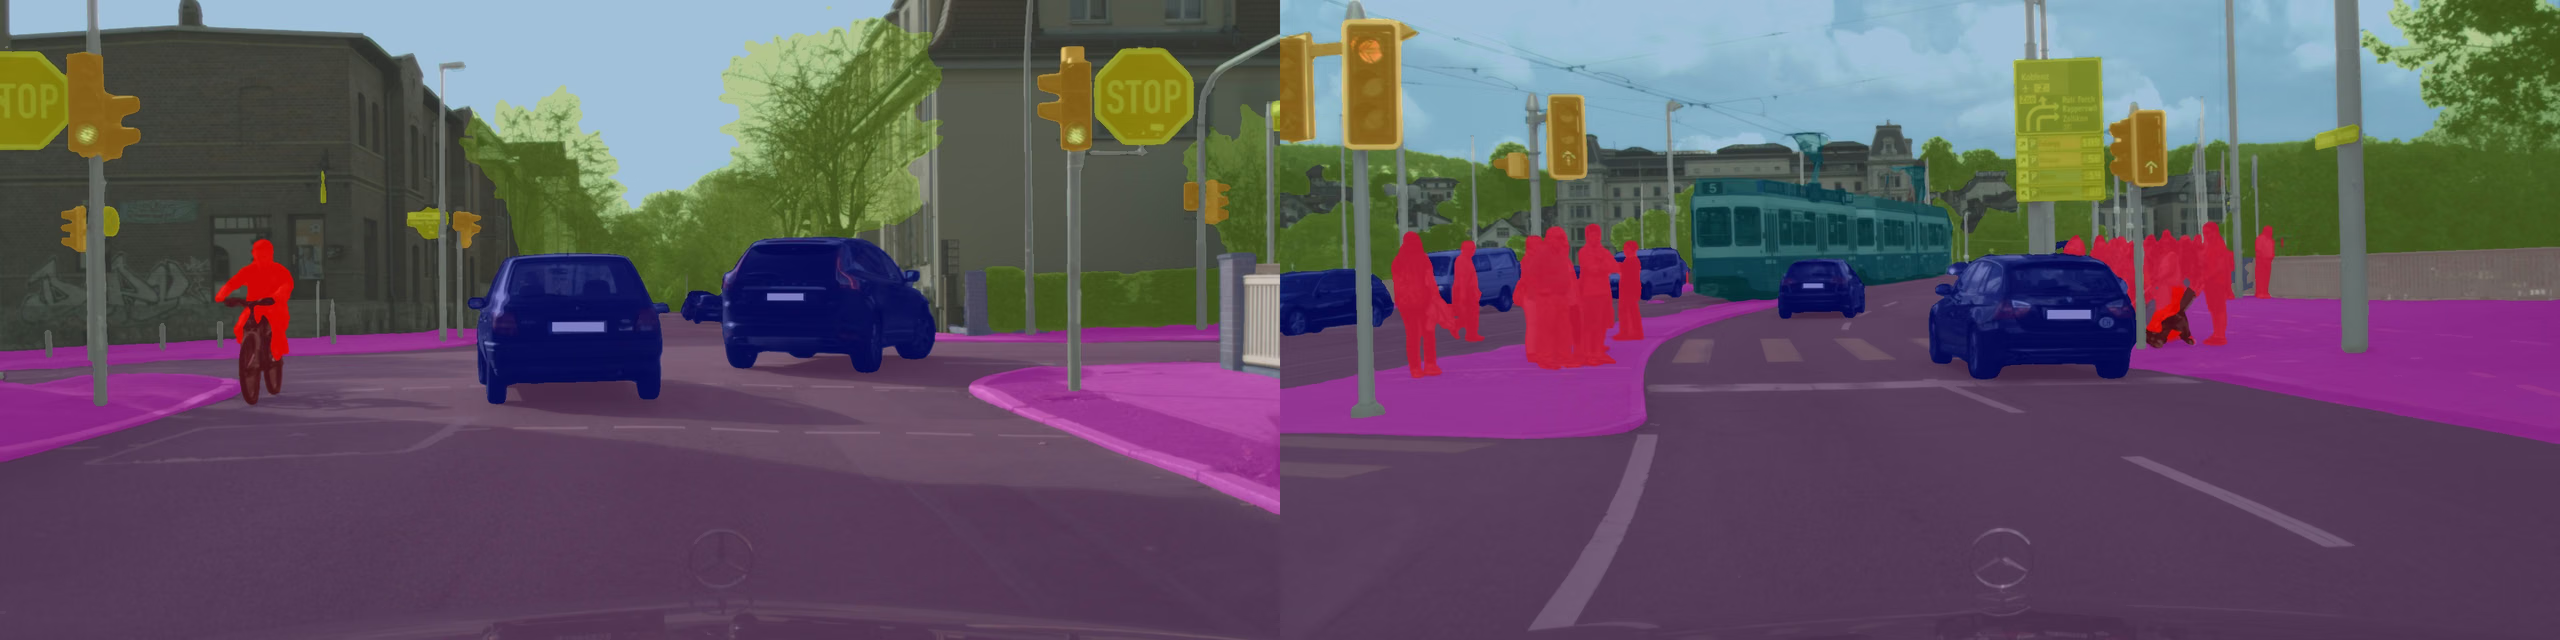
시맨틱 세그멘테이션은 이미지의 모든 픽셀에 클래스 레이블을 할당하여 장면 전체를 포함하는 조밀한 클래스 맵을 생성합니다. 개별 객체를 분리하는 인스턴스 세그멘테이션과 달리, 시맨틱 세그멘테이션은 서로 다른 객체의 수와 관계없이 동일 클래스의 모든 픽셀을 하나로 묶습니다.
시청: Ultralytics YOLO26을 사용한 시맨틱 분할 | 빠른 시작 튜토리얼
시맨틱 세그멘테이션 모델은 높이와 너비로 구성된 단일 클래스 맵을 출력하며, 각 픽셀 값은 예측된 클래스 ID에 해당합니다. 따라서 시맨틱 세그멘테이션은 자율 주행, 의료 영상 및 토지 피복 매핑과 같은 장면 파싱 작업에 적합합니다.
시맨틱 세그멘테이션에는 task=semantic 또는 yolo semantic CLI 작업을 사용합니다. YOLO26 시맨틱 세그멘테이션 모델 파일은 -sem 접미사를 사용하며, 예를 들면 yolo26n-sem.pt입니다.
모델#
Cityscapes 데이터셋으로 사전 학습된 YOLO26 Semantic 모델은 아래와 같습니다.
모델은 처음 사용할 때 최신 Ultralytics 릴리스에서 자동으로 다운로드됩니다.
| 모델 | 크기 (픽셀) | mIoU검증 | 속도 RTX3090 PyTorch (ms) | 파라미터 (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- mIoUval 값은 Cityscapes 검증 세트에서 단일 모델, 단일 스케일로 측정한 결과입니다.
yolo semantic val data=cityscapes.yaml device=0 imgsz=2048로 재현할 수 있습니다. - 속도 메트릭은 RTX3090 인스턴스를 사용하여 Cityscapes 검증 이미지에서 평균을 낸 값입니다.
yolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048로 재현할 수 있습니다. - Params 및 FLOPs 값은 Conv 및 BatchNorm 레이어를 병합하는
model.fuse()이후의 융합 모델 기준입니다. 사전 학습된 체크포인트에는 전체 학습 아키텍처가 유지되므로 더 높은 값이 표시될 수 있습니다.
ADE20K 데이터셋으로 사전 학습된 YOLO26 Semantic 모델은 아래와 같습니다.
| 모델 | 크기 (픽셀) | mIoU검증 | 속도 RTX3090 PyTorch (ms) | 파라미터 (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- mIoUval 값은 ADE20K 검증 세트에서 단일 모델, 단일 스케일로 측정한 결과입니다.
yolo26n-sem-ade20k.pt를 원하는yolo26*-sem-ade20k.pt체크포인트로 바꾸고yolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640로 재현할 수 있습니다. - 속도 메트릭은 RTX3090 인스턴스를 사용하여 ADE20K 검증 이미지에서 평균을 낸 값입니다.
yolo26n-sem-ade20k.pt를 원하는yolo26*-sem-ade20k.pt체크포인트로 바꾸고yolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640로 재현할 수 있습니다. - Params 및 FLOPs 값은 Conv 및 BatchNorm 레이어를 병합하는
model.fuse()이후의 융합 모델 기준입니다. 사전 학습된 체크포인트에는 전체 학습 아키텍처가 유지되므로 더 높은 값이 표시될 수 있습니다.
예비 Cityscapes mIoU 결과는 미출시 YOLO27 미리 보기를 참조하세요.
학습#
Cityscapes8 데이터셋에서 이미지 크기 1024로 100 에포크 동안 YOLO26n-sem을 학습합니다. 사용 가능한 인수의 전체 목록은 Configuration 페이지를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-sem.yaml")  # YAML에서 새 모델을 생성합니다.
model = YOLO("yolo26n-sem.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # YAML에서 모델을 생성하고 가중치를 전이합니다.

# 모델 학습
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
train 모드의 전체 세부 정보는 Train 페이지를 참조하세요. 시맨틱 세그멘테이션 모델은 Ultralytics Platform 클라우드 학습으로도 학습할 수 있습니다.
데이터셋 형식#
시맨틱 세그멘테이션 데이터셋은 일반적으로 PNG 형식의 단일 채널 마스크 이미지를 사용하며, 각 픽셀 값은 클래스 ID를 나타냅니다. 값이 255인 픽셀은 "무시"로 처리되어 손실 계산에서 제외됩니다. 데이터셋 YAML에는 이미지 경로와 해당 마스크 디렉터리 경로를 지정해야 합니다. YOLO 다각형 레이블이 있는 데이터셋은 마스크로 즉석 변환되어 바로 학습에 사용됩니다(인스턴스 세그멘테이션 데이터를 사용할 수 있나요 참조). 형식에 대한 자세한 내용은 Semantic Segmentation Dataset Guide를 참조하세요. 지원되는 데이터셋에는 Cityscapes와 ADE20K가 포함됩니다. Ultralytics Platform 어노테이션으로 시맨틱 데이터셋을 관리하고 레이블을 지정할 수 있습니다.
검증#
학습된 YOLO26n-sem 모델의 정확도를 시맨틱 세그멘테이션 데이터셋에서 검증합니다. 검증 시 의도한 데이터셋 YAML을 사용하도록 data을 명시적으로 전달하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-sem.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델을 검증합니다
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # 평균 교집합 대비 합집합
metrics.pixel_accuracy # 전체 픽셀 정확도예측#
학습된 YOLO26n-sem 모델을 사용하여 이미지에서 예측을 실행합니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-sem.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델로 예측을 수행합니다
results = model("https://ultralytics.com/images/bus.jpg")  # 이미지에 대해 예측을 수행합니다

# 결과에 액세스합니다
for result in results:
    semantic_mask = result.semantic_mask.data  # 클래스 맵, shape (H,W), 클래스 수에 따라 선택되는 정수 dtype
Predict 페이지에서 predict 모드의 전체 세부 정보를 확인하세요.
결과 출력#
YOLO 시맨틱 세그멘테이션은 이미지마다 하나의 Results 객체를 반환합니다. 각 결과에는 객체 마스크 목록 대신 전체 이미지에 대한 하나의 조밀한 클래스 맵이 저장됩니다. 서로 분리된 객체에 속하더라도 예측 클래스가 같은 픽셀은 동일한 클래스 ID를 공유합니다.
| 속성 | 유형 | 형태 | 설명 |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | 조밀한 클래스 맵입니다. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | 클래스 ID이며, dtype은 클래스 수에 따라 선택됩니다. |
result.masks | - | - | 인스턴스 마스크가 없습니다. |
result.boxes | - | - | 인스턴스 박스/신뢰도 값이 없습니다. |
모든 작업에서 작업별 Results 필드를 확인하려면 작업별 예측 결과 섹션을 참조하세요.
시맨틱 세그멘테이션은 조밀한 클래스 맵을 예측한 다음 시각화와 후속 작업을 위해 맵을 이미지 shape에 맞게 다시 조정합니다. 따라서 차선 표시, 코트 라인, 기둥 또는 전선처럼 매우 가는 구조는 추론을 원본 이미지 해상도보다 훨씬 낮은 imgsz에서 실행할 때 계단처럼 보일 수 있습니다. 경계가 들쭉날쭉해 보이면 먼저 기본 PyTorch .pt 모델을 더 큰 imgsz 값으로 다시 테스트하세요. 예를 들면 1024, 1280 또는 원본 이미지 크기에 최대한 가까운 실용적인 값을 사용할 수 있습니다. 예측된 클래스 맵에 포함되지 않은 세부 정보는 저해상도 입력으로 복원할 수 없으므로, .pt 출력이 허용 가능한지 확인한 후에만 내보낸 모델을 사용하세요.
인스턴스 세그멘테이션과 시맨틱 세그멘테이션 비교#
| 항목 | 인스턴스 세그멘테이션(task="segment") | 시맨틱 세그멘테이션(task="semantic") |
|---|---|---|
| 예측 목표 | 감지된 각 객체를 개별적으로 세그멘테이션 | 모든 픽셀에 하나의 클래스 ID 할당 |
| 출력 필드 | result.masks | result.semantic_mask |
| 주요 데이터 | result.masks.data | result.semantic_mask.data |
| 형태 | (N,H,W) | (H,W) |
| 픽셀 값 | 이진 마스크 값: 0 또는 1 | 클래스 ID: 0, 1, 2, ... |
| 데이터형 | torch.uint8 | torch.uint8torch.int16torch.int32 |
| 동일 클래스 객체 | 별도 인스턴스로 유지 | 동일 클래스 영역으로 병합 |
| 다각형 | 예, result.masks.xy 및 result.masks.xyn을 통해 제공됩니다. | 기본적으로 다각형 출력 없음 |
| 박스 및 신뢰도 | 예, result.boxes을 통해 제공됩니다. | 인스턴스별 박스 또는 신뢰도 점수 없음 |
| 일반적인 용도 | 계수, 추적, 크롭, 객체 수준 측정 | 조밀한 장면 레이블링, 주행 가능 영역, 토지 피복, 의료 영역 |
내보내기#
YOLO26n-sem 모델을 ONNX, CoreML 등의 다른 형식으로 내보냅니다.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n-sem.pt")  # 공식 모델을 불러옵니다
model = YOLO("path/to/best.pt")  # 사용자 지정 모델 로드

# 모델을 내보냅니다
model.export(format="onnx")
사용 가능한 YOLO26 시맨틱 세그멘테이션 내보내기 형식은 아래 표에 나와 있습니다. format 인수를 사용하여 모든 형식으로 내보낼 수 있습니다. 예를 들면 format='onnx' 또는 format='engine'입니다. 내보낸 모델에서 바로 예측 또는 검증을 실행할 수 있습니다. 예를 들면 yolo predict model=yolo26n-sem.onnx입니다. 내보내기가 완료되면 모델의 사용 예제가 표시됩니다.
| 형식 | format 인수 | 모델 | 메타데이터 | 인수 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-sem_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None은 외부 NMS를 위한 원시 출력을 기본값으로 사용합니다. 사용 가능한 NMS-free head를 선택하려면 nms=False을 설정합니다. 지원되지 않는 형식은 해당 형식의 기본 출력 경로로 대체됩니다. 위의 nms 항목은 nms=True을 사용해 NMS를 포함할 수 있는 형식을 나타냅니다.
자세한 export 내용은 내보내기 페이지를 참조하세요.
자주 묻는 질문#
사용자 지정 데이터셋으로 YOLO26 시맨틱 세그멘테이션 모델을 학습하려면 각 픽셀 값이 클래스 ID(0, 1, 2, ...)를 나타내고 값이 255인 픽셀은 학습 중 무시되는 PNG 마스크 이미지를 준비해야 합니다. 이미지 및 마스크 디렉터리를 가리키는 데이터셋 YAML 파일을 만든 다음 모델을 학습합니다:
예제from ultralytics import YOLO # 사전 학습된 YOLO26 시맨틱 세그멘테이션 모델을 불러옵니다 model = YOLO("yolo26n-sem.pt") # 모델 학습 results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=1024)사용 가능한 인수에 대한 자세한 내용은 Configuration 페이지를 참조하세요.
인스턴스 세그멘테이션과 시맨틱 세그멘테이션은 모두 픽셀 수준 작업이지만, 중요한 차이가 있습니다:
- 시맨틱 세그멘테이션은 모든 픽셀에 클래스 레이블을 할당하지만, 같은 클래스에 속한 개별 객체는 구분하지 않습니다. 예를 들어 장면 속 모든 자동차는 동일한 클래스 레이블을 공유합니다.
- 인스턴스 세그멘테이션은 각 개별 객체를 따로 식별하여, 같은 클래스에 속하더라도 각 객체에 대해 서로 다른 마스크를 생성합니다.
시맨틱 세그멘테이션은 자율 주행 및 토지 피복 매핑과 같은 장면 이해 작업에 가장 적합하며, 개별 객체의 수를 세거나 추적해야 하는 경우에는 인스턴스 세그멘테이션을 사용하는 것이 좋습니다.
예. 데이터셋에서 Ultralytics YOLO 폴리곤 레이블(이미지당
.txt하나)을 사용하는 경우, 데이터셋 YAML에서masks_dir을 생략하고 데이터셋 루트에서 이미지 옆에masks/폴더가 없는지 확인하세요(masks_dir이 설정되지 않았더라도 해당 폴더가 있으면 PNG 마스크 모드가 활성화됩니다). 그러면 로더가 폴리곤을 이미지별 시맨틱 마스크로 즉시 변환합니다. 다중 클래스 데이터셋(N > 1)의 경우background클래스가names에 자동으로 추가됩니다. 단일 클래스 데이터셋(N == 1)은 학습 시 1개 클래스로 유지됩니다. 선언한 클래스는 마스크에서1이 되고, 미지정 픽셀은0가 됩니다. 자세한 내용은 시맨틱 세그멘테이션 데이터셋 가이드를 참조하세요.Ultralytics YOLO26은 여러 시맨틱 세그멘테이션 데이터셋에 대한 내장 구성을 제공합니다:
- Cityscapes: 자율 주행 연구에 널리 사용되는 19개 클래스의 도심 도로 장면 데이터셋입니다.
- ADE20K: 150개 클래스를 포함하는 대규모 장면 파싱 데이터셋입니다.
픽셀 값이 클래스 ID에 대응하는 PNG 마스크 어노테이션을 제공하는 사용자 지정 데이터셋도 사용할 수 있습니다.
평가에 사용되는 데이터셋 YAML을 사용하여 사전 학습된 YOLO26 시맨틱 세그멘테이션 모델을 검증합니다:
예제from ultralytics import YOLO # 사전 학습된 모델 불러오기 model = YOLO("yolo26n-sem.pt") # 모델을 검증합니다 metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)이 단계를 통해 평균 교집합 대비 합집합(mIoU) 및 픽셀 정확도와 같은 검증 지표를 얻을 수 있습니다. 이러한 지표는 시맨틱 세그멘테이션 성능을 평가하는 표준 측정값입니다.
Python 또는 CLI 명령을 사용하여 YOLO26 시맨틱 세그멘테이션 모델을 ONNX 형식으로 내보냅니다:
예제from ultralytics import YOLO # 사전 학습된 모델 불러오기 model = YOLO("yolo26n-sem.pt") # 모델을 ONNX 형식으로 내보내기 model.export(format="onnx")다양한 형식으로 내보내는 방법에 대한 자세한 내용은 Export 페이지를 참조하세요.