模型部署最佳实践
简介#
模型部署是计算机视觉项目中的一个步骤,负责将模型从开发阶段带入实际应用。模型部署选项有多种:云端部署提供可扩展性和便捷访问,边缘部署通过让模型靠近数据源来降低延迟,本地部署则能确保隐私和控制权。选择合适的策略取决于应用需求,需要平衡速度、安全性和可扩展性。
观看: 如何优化和部署 AI 模型:最佳实践、故障排查与安全注意事项
遵循模型部署最佳实践也很重要,因为部署会显著影响模型性能的有效性和可靠性。在本指南中,我们将重点介绍如何确保模型部署顺畅、高效且安全。
模型部署选项#
模型经过训练、评估和测试后,通常需要转换为特定格式,才能在云端、边缘端或本地设备等各种环境中有效部署。
借助 YOLO26,你可以根据部署需求将模型导出为多种格式。例如,将 YOLO26 导出为 ONNX非常简单,也非常适合在不同框架之间迁移模型。如需了解更多集成选项,并确保模型在不同环境中顺利部署,请访问我们的模型集成目录。
选择部署环境#
选择在哪里部署你的计算机视觉模型取决于多个因素。不同环境各有优点和挑战,因此务必选择最符合你需求的环境。
云端部署#
云端部署非常适合需要快速扩展并处理大量数据的应用。AWS、Google Cloud和 Azure 等平台让你可以轻松地管理从训练到部署的模型。它们提供 Amazon SageMaker、Google Vertex AI和 Azure Machine Learning等服务,在整个过程中为你提供帮助。Ultralytics Platform还可将 YOLO 模型部署到全球 42 个区域的专用端点。
不过,使用云端服务可能成本高昂,尤其是在数据用量较大的情况下;如果用户距离数据中心较远,你还可能遇到延迟问题。为控制成本并保障性能,优化资源使用并确保遵守数据隐私规则非常重要。
边缘部署#
边缘部署适用于需要实时响应和低延迟的应用,尤其是在互联网连接有限或无法连接的场所。在智能手机或 IoT 设备等边缘设备上部署模型,可以确保快速处理并将数据保留在本地,从而提升隐私保护水平。边缘部署还可以减少发送到云端的数据,节省带宽。
不过,边缘设备的处理能力通常有限,因此你需要优化模型。LiteRT和 NVIDIA Jetson等运行时和硬件平台可以提供帮助。尽管边缘部署有诸多优势,但维护和更新大量设备仍然具有挑战性。
本地部署#
如果数据隐私至关重要,或者互联网连接不稳定或无法连接,本地部署是最佳选择。在本地服务器或台式机上运行模型,可以让你完全掌控模型并确保数据安全。如果服务器靠近用户,还可以降低延迟。
不过,本地扩展可能很困难,维护也可能耗时。使用 Docker 等工具进行容器化,并使用 Kubernetes 进行管理,有助于提高本地部署的效率。定期更新和维护是确保一切顺利运行的必要措施。
通过容器化简化部署#
容器化会将模型及其所有依赖打包成一个称为容器的标准化单元。这项技术可确保模型在不同环境中保持一致的性能,并简化部署流程。
使用 Docker 部署模型的优势#
出于以下多种原因,Docker 已成为机器学习部署中容器化的行业标准:
- 环境一致性:Docker 容器封装模型及其所有依赖项,确保模型在开发、测试和生产环境中的行为一致,从而解决“在我的机器上能运行”的问题。
- 隔离性:容器将应用彼此隔离,防止不同软件版本或库之间发生冲突。
- 可移植性:Docker 容器可以在任何支持 Docker 的系统上运行,因此你无需修改模型即可轻松将其部署到不同平台。
- 可扩展性:你可以根据需求轻松扩缩容器,Kubernetes 等编排工具还能自动完成这一过程。
- 版本控制:你可以为 Docker 镜像设置版本,以便跟踪更改,并在需要时回退到先前版本。
使用 Docker 部署 YOLO26#
要将 YOLO26 模型容器化,你可以创建一个 Dockerfile,用于指定所有必需的依赖项和配置。下面是一个基本示例:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
这种方法可确保模型部署具有可复现性,并在开发、测试和生产环境中保持一致。
模型优化技术#
优化计算机视觉模型有助于提升运行效率,尤其是在边缘设备等资源有限的环境中部署时。以下是一些优化模型的关键技术。
模型剪枝#
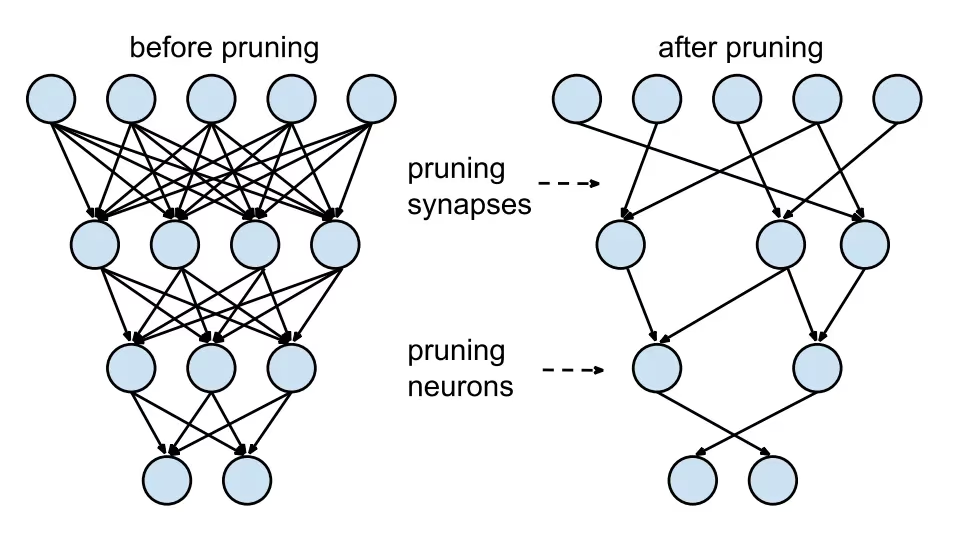
剪枝会移除对最终输出贡献很小的权重,从而缩小模型体积。它可以在不显著影响准确率的情况下,让模型更小、运行更快。剪枝需要识别并删除不必要的参数,最终得到计算需求更低的轻量模型。这项技术尤其适合在资源有限的设备上部署模型。
模型量化#
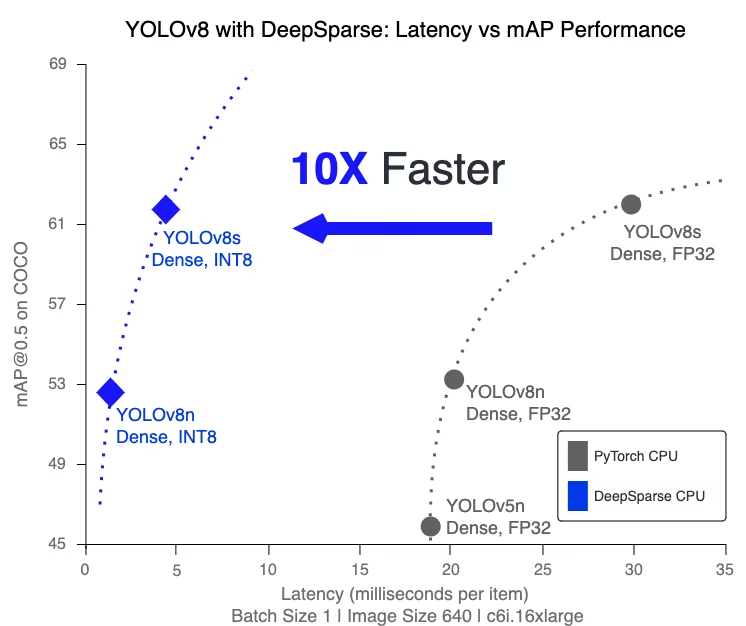
量化会将模型的权重和激活值从高精度(例如 32 位浮点数)转换为低精度(例如 8 位整数)。缩小模型体积的同时,量化还能加快推理速度。量化感知训练(QAT)是一种在训练时考虑量化的方法,与训练后量化相比,它能更好地保留准确率。在训练阶段处理量化后,模型可以学会适应较低精度,在降低计算需求的同时维持性能。在 Ultralytics YOLO 中,导出时设置 quantize=8 可进行训练后 INT8 量化;训练时设置该参数则可进行量化感知训练(QAT)。
知识蒸馏#
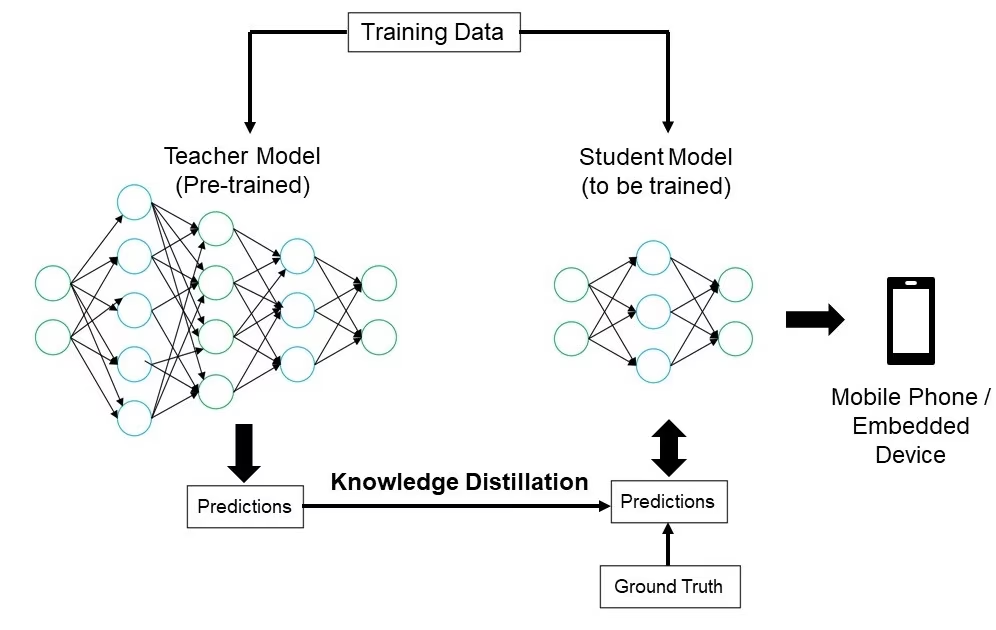
知识蒸馏是指训练一个更小、更简单的模型(学生模型),使其模仿一个更大、更复杂的模型(教师模型)的输出。学生模型会学习近似教师模型的预测结果,从而生成一个紧凑模型,同时保留教师模型的大部分准确率。这项技术有助于创建高效模型,以便部署在资源受限的边缘设备上。Ultralytics YOLO 通过 distill_model 训练参数支持知识蒸馏。
部署问题故障排查#
部署计算机视觉模型时可能会遇到挑战,但了解常见问题和解决方案可以让整个过程更加顺畅。以下是一些通用的故障排查建议和最佳实践,帮助你应对部署问题。
部署后模型准确率下降#
模型部署后准确率下降可能由多种因素导致。以下步骤可以帮助你找出并解决问题:
- 检查数据一致性:确保模型部署后处理的数据与训练时使用的数据一致。数据分布、质量或格式上的差异都可能显著影响性能。
- 验证预处理步骤:确认训练期间应用的所有预处理步骤在部署时也得到了一致应用。这包括调整图像尺寸、归一化像素值以及其他数据转换。
- 评估模型运行环境:确保部署时使用的硬件和软件配置与训练时相符。库、版本和硬件能力方面的差异可能会造成不一致。
- 监控模型推理:记录推理流程各个阶段的输入和输出,以检测异常。这有助于发现数据损坏或模型输出处理不当等问题。
- 检查模型导出和转换:重新导出模型,并确保转换过程保留模型权重和架构的完整性。
- 使用受控数据集进行测试:在测试环境中部署模型,使用你可以控制的数据集,并将结果与训练阶段进行比较。这样可以判断问题出在部署环境还是数据上。
部署 YOLO26 时,有几个因素可能影响模型准确率。将模型转换为 TensorRT 等格式时,会进行权重量化和层融合等优化,这可能造成轻微的精度损失。使用 FP16(半精度)而非 FP32(全精度)可以加快推理速度,但可能引入数值精度误差。此外,Jetson Nano 等设备的硬件限制,例如 CUDA 核心数量较少、内存带宽较低,也会影响性能。
推理耗时超出预期#
部署机器学习模型时,确保模型高效运行非常重要。如果推理耗时超出预期,用户体验和应用效果都可能受到影响。以下是一些帮助你找出并解决问题的步骤:
- 执行预热运行:初次运行通常包含额外的初始化开销,可能会影响延迟测量结果。测量延迟前,先执行几次预热推理。排除这些初次运行后,才能更准确地测量模型性能。
- 优化推理引擎:再次确认推理引擎已针对你的 GPU 架构进行充分优化。使用适配硬件的最新驱动程序和软件版本,以确保性能和兼容性达到最佳状态。
- 使用异步处理:异步处理有助于更高效地管理工作负载。使用异步处理技术并发执行多次推理,有助于分散负载并缩短等待时间。
- 分析推理流程:找出推理流程中的瓶颈有助于定位延迟来源。使用分析工具检查推理过程的每个步骤,找出并解决造成明显延迟的环节,例如效率低下的层或数据传输问题。
- 使用合适的精度:使用超出实际需求的高精度会拖慢推理速度。你可以尝试使用 FP16(导出时设置
quantize=16),而不是 FP32(全精度)。FP16 虽然可以缩短推理时间,但也要注意它可能影响模型准确率。
如果你在部署 YOLO26 时遇到这个问题,可以考虑 YOLO26 提供的多种模型尺寸,例如适用于内存容量较低设备的 YOLO26n(nano),以及适用于性能更强 GPU 的 YOLO26x(extra-large)。为硬件选择合适的模型变体,有助于平衡内存使用量和处理时间。
还要注意,输入图像的尺寸会直接影响内存使用量和处理时间。较低的分辨率可以减少内存使用量并加快推理速度,而较高的分辨率则能提升准确率,但需要更多内存和处理能力。
模型部署中的安全注意事项#
部署的另一个重要方面是安全性。保护已部署模型的安全,对于保护敏感数据和知识产权至关重要。以下是一些你可以采用的安全模型部署最佳实践。
安全传输数据#
保护客户端与服务器之间传输的数据至关重要,这样可以防止数据被拦截或遭未授权方访问。你可以使用 TLS(传输层安全协议)等加密协议对传输中的数据进行加密。即使有人拦截了数据,也无法读取。你还可以使用端到端加密,让数据从源头到目的地的整个传输过程都受到保护,确保中间环节无人能够访问数据。
访问控制#
控制哪些人可以访问模型及其数据至关重要,这样可以防止未授权使用。使用强身份验证方法,核实尝试访问模型的用户或系统身份,并考虑通过多重身份验证(MFA)加强安全性。设置基于角色的访问控制(RBAC),根据用户角色分配权限,确保每个人只能访问所需内容。保留详细的审计日志,跟踪对模型及其数据的所有访问和更改,并定期检查日志以发现可疑活动。
模型混淆#
你可以通过模型混淆来防止模型被逆向工程或滥用。模型混淆会对神经网络中的权重和偏置等模型参数进行加密,让未授权人员难以理解或篡改模型。你还可以通过重命名层和参数或添加虚拟层来混淆模型架构,增加攻击者逆向工程的难度。在安全飞地或可信执行环境(TEE)等安全环境中提供模型服务,也能在推理期间提供额外保护。
总结与后续步骤#
我们介绍了部署计算机视觉模型时应遵循的一些最佳实践。通过保护数据、控制访问并混淆模型细节,你可以保护敏感信息,同时确保模型平稳运行。我们还讨论了如何解决准确率下降和推理速度慢等常见问题,方法包括预热运行、优化引擎、异步处理、分析流程以及选择合适的精度。
部署模型后,下一步是监控、维护并记录你的应用。定期监控有助于及时发现并修复问题,维护可确保模型保持最新且正常运行,完善的文档则能记录所有变更和更新。这些步骤将帮助你实现计算机视觉项目的目标。
常见问题#
部署机器学习模型,尤其是使用 Ultralytics YOLO26 时,需要遵循多项最佳实践,以确保效率和可靠性。首先,选择适合你需求的部署环境:云端、边缘或本地。通过剪枝、量化和知识蒸馏等技术优化模型,以便在资源受限的环境中高效部署。可以考虑使用 Docker 容器化,确保模型在不同环境中的一致性。最后,确保数据一致性和预处理步骤与训练阶段相符,以维持性能。你还可以参考模型部署选项,了解更详细的指南。
排查部署问题可以分为几个关键步骤。如果模型部署后准确率下降,请检查数据一致性、验证预处理步骤,并确保硬件和软件环境与训练时使用的环境相符。如果推理速度较慢,请执行预热运行、优化推理引擎、使用异步处理并分析推理流程。有关这些最佳实践的详细指南,请参阅部署问题排查。
针对边缘设备优化 Ultralytics YOLO26 模型,需要采用多种技术,例如通过剪枝缩小模型尺寸、通过量化将权重转换为较低精度,以及通过知识蒸馏训练能够模仿大型模型的小型模型。这些技术可确保模型在计算能力有限的设备上高效运行。LiteRT 和 NVIDIA Jetson 等工具特别适合这些优化。你可以在模型优化部分了解这些技术的更多信息。
部署机器学习模型时,安全性至关重要。使用 TLS 等加密协议确保数据传输安全。实施完善的访问控制,包括强身份验证和基于角色的访问控制(RBAC)。模型混淆技术(例如加密模型参数,以及在可信执行环境(TEE)等安全环境中提供模型服务)可以提供额外保护。有关详细做法,请参阅安全注意事项。


评论10
提出问题、分享结果,或帮助其他人。
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.