Labelbox連携#
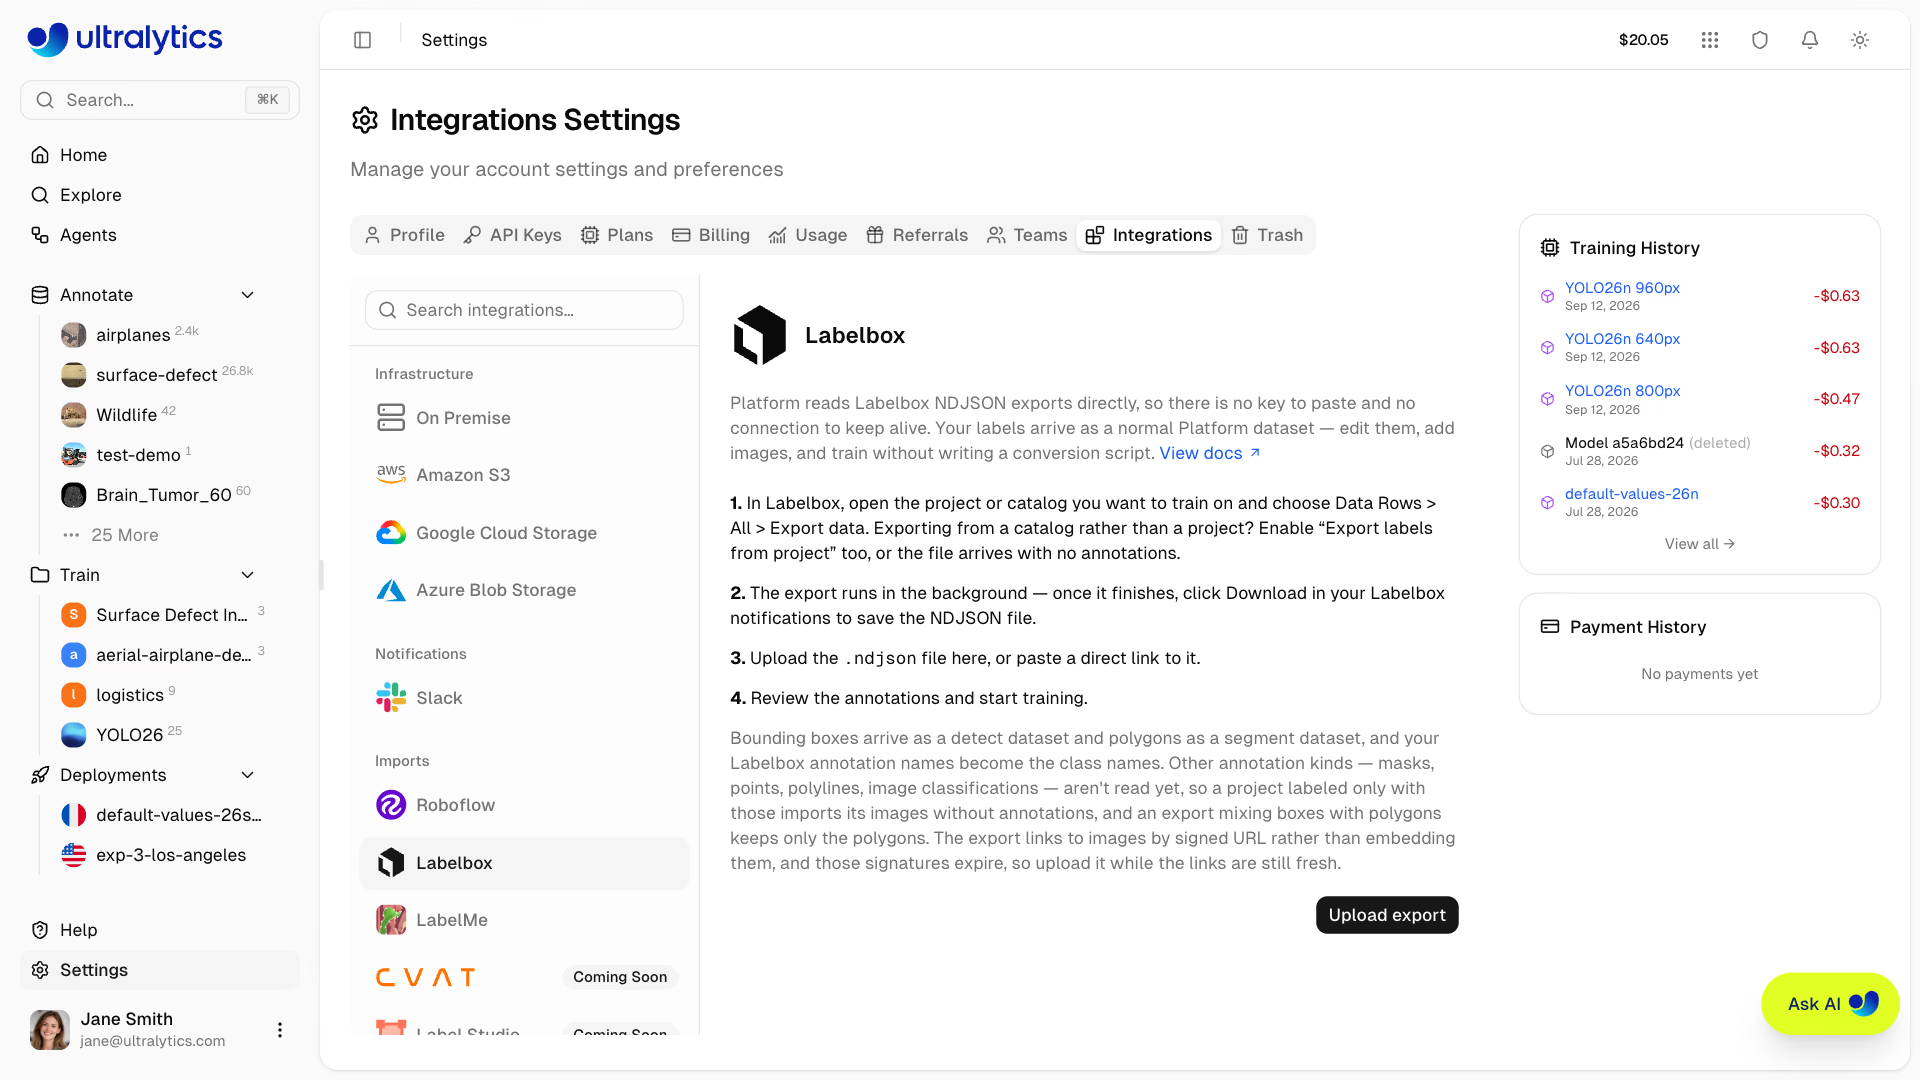
Ultralytics PlatformはLabelboxのNDJSONエクスポートを直接読み込みます。キーの貼り付けも、維持する接続も、管理が必要な変換スクリプトもありません。Labelboxからエクスポートしてファイルをアップロードするだけで、ラベルが通常のPlatformデータセットとして取り込まれます。
Labelboxからインポート#
- Labelboxからエクスポートします。 ラベリングプロジェクトを開き、Data RowsタブでAllを選択し、Export dataをクリックして、含めるフィールドを選択して確定します。Catalogからデータ行を選択する場合は、Manage selection > Export dataを選択してからExport labels from projectをオンにし、プロジェクトを選択してください。そうしないと、アノテーションがまったく含まれないファイルが生成されます。
- ファイルをダウンロードします。 Labelboxはバックグラウンドジョブとしてエクスポートを実行します。通知で完了を確認し、終了したらDownloadをクリックして
.ndjsonファイルを保存します。 - Platformにアップロードします。 新しいデータセットを作成して
.ndjsonファイルをアップロードするか、ファイルへの直接リンクを貼り付けます。また、Settings > Integrations > Labelboxから開始することもできます。 - トレーニングします。 処理が完了したら、他のPlatformデータセットと同様にアノテーションを編集し、トレーニングします。
CVATやLabel Studioとは異なり、選択するフォーマットはありません。サポートされているのはLabelbox独自のエクスポート形式です。
SDKでエクスポートする#
LabelboxではPython SDKからもエクスポートタスクを実行できます。これは再現可能なパイプラインを構築する場合に、より簡単な方法です。タスクをストリーム処理し、1行につき1つのJSONオブジェクトを書き込みます。
import json

import labelbox

client = labelbox.Client(api_key="YOUR_LABELBOX_API_KEY")
export_task = labelbox.ExportTask.get_task(client, "YOUR_EXPORT_TASK_ID")
export_task.wait_till_done()  # # COMPLETEではないタスクをストリーミングすると、例外が発生します

with open("dataset.ndjson", "w") as f:
f.writelines(json.dumps(data_row.json) + "\n" for data_row in export_task.get_buffered_stream())NDJSONは、1行につき1つのJSONオブジェクトで構成されます。json.dump(list_of_rows, f)は代わりに単一の配列を書き込みます。PlatformはJSONオブジェクトではない行をすべてスキップするため、インポート対象のデータ行が見つかりません。上記のループまたは"\n".join(json.dumps(r) for r in rows)を使用してください。
インポートされる内容#
PlatformはLabelbox形式を自動で認識し、バウンディングボックスとポリゴンを対応するYOLOタスクタイプにマッピングします。
各オブジェクトのnameがクラス名になります。そのため、"name": "Dog"アノテーションは小文字のvalueではなく、クラスDogとしてインポートされます。ピクセル座標は、エクスポート内のmedia_attributesの寸法を基準に正規化されます。そのため、エクスポートにはメディア属性を含めてください。幅と高さのない行は、アノテーションなしで画像がインポートされます。Platformがインポートできるオブジェクトのみがクラスとして登録されるため、マスク、ポイント、ポリラインのツールによって空のクラスがデータセットに追加されることはありません。各画像の名前にはdata_row.external_idが使われ、次にglobal_keyが使われます。エクスポートにどちらも含まれていない場合は、署名付きURL内のファイル名が使われます。画像のデータ行はインポートされますが、動画、テキストなど、画像以外のデータ行はスキップされます。アノテーションのないCatalogエクスポートは、ラベル付けされていない画像データセットとしてインポートされ、Platformのアノテーションエディターですぐにラベル付けできます。
1つのデータ行は次のようになります。Platformが読み込むフィールドだけを抜粋しています。
{
    "data_row": {
        "external_id": "000000000307.jpg",
        "global_key": "000000000307.jpg",
        "row_data": "https://storage.labelbox.com/...?Expires=...&Signature=..."
    },
    "media_attributes": { "height": 480, "width": 640, "mime_type": "image/jpeg" },
    "projects": {
        "<project-id>": {
            "labels": [
                {
                    "annotations": {
                        "objects": [
                            {
                                "name": "Dog",
                                "annotation_kind": "ImageBoundingBox",
                                "bounding_box": { "top": 200.0, "left": 407.0, "height": 172.0, "width": 176.0 }
                            }
                        ]
                    }
                }
            ]
        }
    }
}エクスポート内のその他すべての項目(embeddings、metadata_fields、attachments、project_details)は無視されます。エクスポート時に埋め込みを選択解除することをおすすめします。サンプルのエクスポートでは、ファイルの約5分の4を埋め込みが占めており、Platformが実際に読み込むフィールドは約5分の1でした。
現在読み込まれるのはバウンディングボックスとポリゴンのみで、オブジェクトアノテーションに含まれるものに限られます。画像レベルの分類はエクスポート内の別の場所にあるため、スキップされます。セグメンテーションマスク(ブラシ)ツール、ポイント、ポリライン、または分類だけでラベル付けされたプロジェクトは、画像のみがインポートされ、アノテーションはインポートされませんが、エラーも発生しません。データセットページで確認できます。ラベルが保持されたインポート済みデータセットでは、画像数の横にラベル数とアノテーション数が表示されます。ラベルが失われたデータセットでは、どちらも表示されません。
Labelboxエクスポートではピクセルデータを埋め込まず、署名付きURLで各画像を参照します。署名には有効期限があります。Platformは画像のダウンロードを開始する前にサンプルを確認するため、すべてのリンクが期限切れになったエクスポートはすぐに失敗し、理由が表示されます。その場合はLabelboxから再エクスポートし、新しいファイルをアップロードしてください。一部のリンクだけが期限切れのエクスポートでは、アクセスできる画像をインポートし、残りをスキップします。エクスポート後は早めにアップロードしてください。
バウンディングボックスとポリゴンの両方を含むエクスポートは、セグメントデータセットとしてインポートされます。セグメントデータセットに含まれるのはポリゴンの形状のみです。バウンディングボックスのアノテーションはトレーニングに使用されず、バージョンのエクスポートにも含まれません。両方が必要な場合は、バウンディングボックスとポリゴンを別々のLabelboxプロジェクトとしてエクスポートしてください。ポリゴンを読み込むには、少なくとも3つの点も必要です。
よくある質問#
Platformが読み込むのはNDJSONで、1行につき1つのJSONオブジェクトが必要です。単一のJSON配列として保存されたエクスポートは、すべてスキップされます。上記のSDKループを使うか、Labelbox独自のExport dataダウンロードを使用してください。こちらはすでにNDJSON形式です。
Labelboxエクスポートは署名付きURLで画像を参照しており、署名には有効期限があります。Labelboxから再エクスポートし、完了後すぐに新しいファイルをアップロードしてください。
いいえ。混在したエクスポートはセグメントデータセットとしてインポートされ、ポリゴンのみが使用されます。両方が必要な場合は、バウンディングボックスとポリゴンを別々のLabelboxプロジェクトとしてエクスポートしてください。