快速入门指南:使用 Ultralytics YOLO26 和 NVIDIA Jetson#
本指南全面介绍了如何在 NVIDIA Jetson 设备上部署 Ultralytics YOLO26,并提供性能基准测试,展示 YOLO26 在这些小巧而强大的设备上的能力。
我们已更新本指南,纳入最新的 NVIDIA Jetson AGX Thor Developer Kit,该设备可提供高达 2070 FP4 TFLOPS 的 AI 算力和 128 GB 内存,功耗可在 40 W 至 130 W 之间配置。其 AI 算力超过 NVIDIA Jetson AGX Orin 的 7.5 倍,能效提升 3.5 倍,可流畅运行最热门的 AI 模型。
观看: 如何在 NVIDIA Jetson 设备上使用 Ultralytics YOLO26
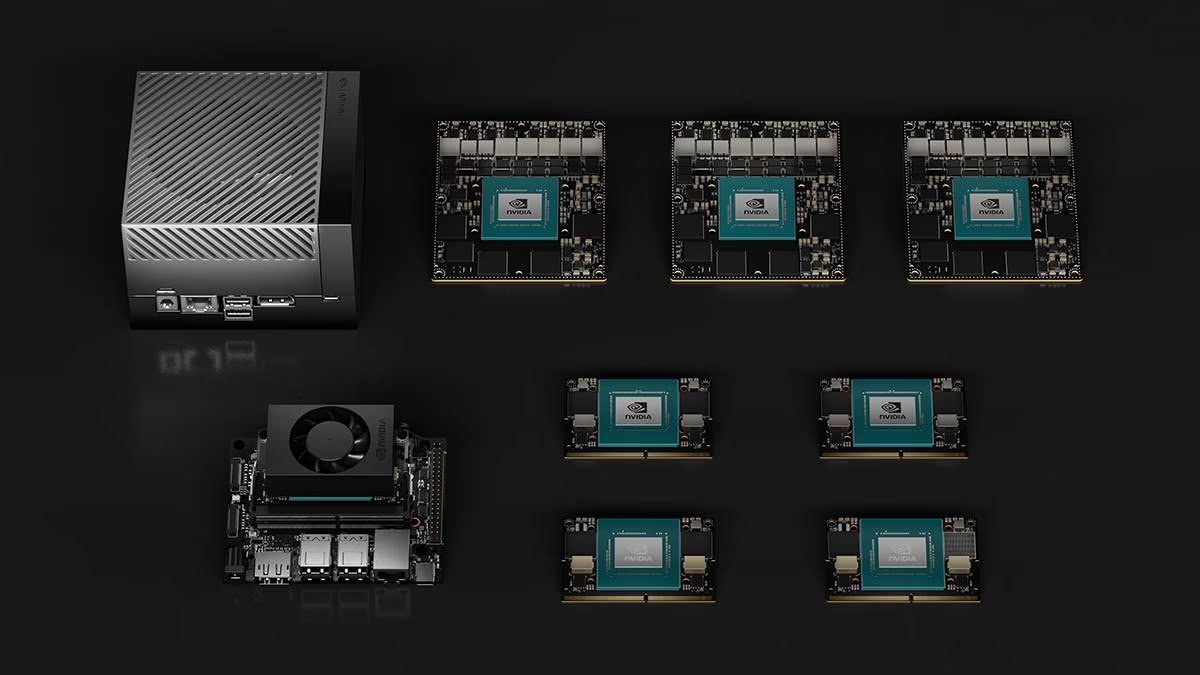
本指南已在搭载最新稳定版 JetPack 7.2 的 NVIDIA Jetson AGX Thor Developer Kit (Jetson T5000) 和 NVIDIA Jetson AGX Orin Developer Kit (64GB) 上进行测试;在运行 JP6.1 版 JetPack 的 NVIDIA Jetson Orin Nano Super Developer Kit 上进行测试;在基于 NVIDIA Jetson Orin NX 16GB、运行 JP6.0/JP5.1.3 版 JetPack 的 Seeed Studio reComputer J4012 上进行测试;以及在基于 NVIDIA Jetson Nano 4GB、运行 JP4.6.1 版 JetPack 的 Seeed Studio reComputer J1020 v2 上进行测试。预计本指南适用于整个 NVIDIA Jetson 硬件产品系列,包括最新设备和旧款设备。
什么是 NVIDIA Jetson?#
NVIDIA Jetson 是一系列嵌入式计算板,旨在为边缘设备提供加速 AI(人工智能)计算能力。这些小巧而强大的设备采用 NVIDIA GPU 架构,可直接在设备上运行复杂的 AI 算法和深度学习模型,而无需依赖云计算资源。Jetson 板常用于机器人、自动驾驶汽车、工业自动化等需要在本地以低延迟、高效率执行 AI 推理的应用场景。此外,这些板基于 ARM64 架构,与传统 GPU 计算设备相比功耗更低。
NVIDIA Jetson 系列对比#
NVIDIA Jetson AGX Thor 是 NVIDIA Jetson 系列的最新产品,基于 NVIDIA Blackwell 架构,与前几代产品相比,AI 性能大幅提升。下表对比了该生态系统中的部分 Jetson 设备。
| Jetson AGX Thor (T5000) | Jetson AGX Orin 64GB | Jetson Orin NX 16GB | Jetson Orin Nano Super | Jetson AGX Xavier | Jetson Xavier NX | Jetson Nano | |
|---|---|---|---|---|---|---|---|
| AI 性能 | 2070 TFLOPS | 275 TOPS | 100 TOPS | 67 TOPS | 32 TOPS | 21 TOPS | 472 GFLOPS |
| GPU | 配备 96 个 Tensor Core 的 2560 核 NVIDIA Blackwell 架构 GPU | 配备 64 个 Tensor Core 的 2048 核 NVIDIA Ampere 架构 GPU | 配备 32 个 Tensor Core 的 1024 核 NVIDIA Ampere 架构 GPU | 配备 32 个 Tensor Core 的 1024 核 NVIDIA Ampere 架构 GPU | 配备 64 个 Tensor Core 的 512 核 NVIDIA Volta 架构 GPU | 配备 48 个 Tensor Core 的 384 核 NVIDIA Volta™ 架构 GPU | 128 核 NVIDIA Maxwell™ 架构 GPU |
| GPU 最高频率 | 1.57 GHz | 1.3 GHz | 918 MHz | 1020 MHz | 1377 MHz | 1100 MHz | 921MHz |
| CPU | 14 核 Arm® Neoverse®-V3AE 64 位 CPU,1MB L2 + 16MB L3 | 12 核 NVIDIA Arm® Cortex A78AE v8.2 64 位 CPU,3MB L2 + 6MB L3 | 8 核 NVIDIA Arm® Cortex A78AE v8.2 64 位 CPU,2MB L2 + 4MB L3 | 6 核 Arm® Cortex®-A78AE v8.2 64 位 CPU,1.5MB L2 + 4MB L3 | 8 核 NVIDIA Carmel Arm®v8.2 64 位 CPU,8MB L2 + 4MB L3 | 6 核 NVIDIA Carmel Arm®v8.2 64 位 CPU,6MB L2 + 4MB L3 | 四核 Arm® Cortex®-A57 MPCore 处理器 |
| CPU 最高频率 | 2.6 GHz | 2.2 GHz | 2.0 GHz | 1.7 GHz | 2.2 GHz | 1.9 GHz | 1.43GHz |
| 内存 | 128GB 256 位 LPDDR5X,273GB/s | 64GB 256 位 LPDDR5,204.8GB/s | 16GB 128 位 LPDDR5,102.4GB/s | 8GB 128 位 LPDDR5,102 GB/s | 32GB 256 位 LPDDR4x,136.5GB/s | 8GB 128 位 LPDDR4x,59.7GB/s | 4GB 64 位 LPDDR4,25.6GB/s |
如需查看更详细的对比表,请访问 NVIDIA 官方 Jetson 页面中的 规格对比 部分。
什么是 NVIDIA JetPack?#
为 Jetson 模块提供支持的 NVIDIA JetPack SDK 是最全面的解决方案,它提供完整的开发环境,可用于构建端到端加速 AI 应用并缩短产品上市时间。JetPack 包含 Jetson Linux,其中包括引导加载程序、Linux 内核、Ubuntu 桌面环境,以及一套用于加速 GPU 计算、多媒体、图形和计算机视觉的完整库。它还包含适用于主机和开发套件的示例、文档和开发者工具,并支持更高级别的 SDK,例如用于流媒体视频分析的 DeepStream、用于机器人技术的 Isaac,以及用于对话式 AI 的 Riva。
将 JetPack 刷写到 NVIDIA Jetson#
拿到 NVIDIA Jetson 设备后,第一步是将 NVIDIA JetPack 刷写到设备上。刷写 NVIDIA Jetson 设备有多种不同方式。
- 对于搭载 JetPack 7.2 的官方 Jetson AGX Thor、AGX Orin 或 Orin Nano Developer Kit,请下载统一版 Jetson ISO,将其写入 USB 闪存驱动器,然后按照对应设备的快速入门指南操作:AGX Thor、AGX Orin 或 Orin Nano。从 JetPack 7.2 开始,Orin Nano 不再使用可下载的 SD 卡映像;ISO USB 安装程序会将 Jetson Linux 安装到设备的 microSD 卡或 NVMe SSD 上。
- 如果你有意在 Jetson Orin Nano Developer Kit 上使用 JetPack 6,请按照 NVIDIA 的 JetPack 6.x 更新和 SD 卡说明操作。
- 如果你拥有其他 NVIDIA Development Kit,可以使用 SDK Manager 将 JetPack 刷写到设备上。
- 如果你拥有 Seeed Studio reComputer J4012 设备,可以将 JetPack 刷写到随附的 SSD;如果你拥有 Seeed Studio reComputer J1020 v2 设备,可以将 JetPack 刷写到 eMMC/ SSD。
- 如果你拥有其他由 NVIDIA Jetson 模块驱动的第三方设备,建议按照命令行刷写的方式操作。
对于上面的方法 1、4 和 5,在刷写系统并启动设备后,请在设备终端中输入 "sudo apt update && sudo apt install nvidia-jetpack -y",以安装所需的其余 JetPack 组件。
基于 Jetson 设备的 JetPack 支持情况#
下表列出了不同 NVIDIA Jetson 设备支持的 NVIDIA JetPack 版本。
| JetPack 4 | JetPack 5 | JetPack 6 | JetPack 7 | |
|---|---|---|---|---|
| Jetson Nano | ✅ | ❌ | ❌ | ❌ |
| Jetson TX2 | ✅ | ❌ | ❌ | ❌ |
| Jetson Xavier NX | ✅ | ✅ | ❌ | ❌ |
| Jetson AGX Xavier | ✅ | ✅ | ❌ | ❌ |
| Jetson AGX Orin | ❌ | ✅ | ✅ | ✅ |
| Jetson Orin NX | ❌ | ✅ | ✅ | ✅ |
| Jetson Orin Nano | ❌ | ✅ | ✅ | ✅ |
| Jetson AGX Thor | ❌ | ❌ | ❌ | ✅ |
Docker 快速入门#
在 NVIDIA Jetson 上开始使用 Ultralytics YOLO26,最快的方法是运行为 Jetson 预构建的 Docker 镜像。请参阅上表,并根据你拥有的 Jetson 设备选择对应的 JetPack 版本。
t=ultralytics/ultralytics:latest-jetson-jetpack4
sudo docker pull $t && sudo docker run -it --ipc=host --runtime=nvidia $tlatest-nvidia-arm64 镜像使用 NVIDIA PyTorch 26.08,其中包含 CUDA 13.4 和 TensorRT 11.2。NVIDIA 在其兼容性表中列出了 JetPack 7.1 对 PyTorch 的支持,但 TensorRT 11.2.1 不支持 JetPack,包括 Thor。仅在受支持的主机上将此镜像用于 PyTorch 工作负载。对于 Jetson TensorRT 导出,请使用下方的原生安装方式,并使用 JetPack 版本支持的 TensorRT 10.x 运行时。JetPack 7.2 在 Thor 或 Orin 上需要单独验证容器。请针对目标 GPU 和 TensorRT 版本重新构建引擎。
对于 JetPack 4、5 和 6 镜像,请继续参阅在 NVIDIA Jetson 上使用 TensorRT。上面的 JetPack 7.1 镜像仅适用于 PyTorch 工作负载。
从原生安装开始#
如需不使用 Docker 进行原生安装,请参阅以下步骤。
在 JetPack 7.2 上运行#
安装 Ultralytics 包#
这里将在 Jetson 上安装 Ultralytics 包。首次导出模型时会自动安装导出依赖项,因此这里只需安装基础包。我们将主要关注 NVIDIA TensorRT 导出,因为 TensorRT 能确保充分发挥 Jetson 设备的性能。
-
更新软件包列表、安装 pip 并升级到最新版本
sudo apt update sudo apt install python3-pip -y pip install -U pip -
安装
ultralyticspip 包pip install ultralytics -
重启设备
sudo reboot
安装 PyTorch 和 Torchvision#
上述 Ultralytics 安装过程会安装 Torch 和 Torchvision。不过,通过 pip 安装的这两个包与搭载 CUDA 13 的 JetPack 7.2 设备不兼容。因此,我们需要手动安装它们。
根据 JP7.2 安装 torch 和 torchvision
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130安装 onnxruntime-gpu#
使用与你的 JetPack、Python 和 CUDA 版本匹配的 ONNX Runtime GPU wheel。目前 PyPI 发布版本包含 ARM64 wheel,但它们不能替代适用于所有 JetPack 版本的设备专用包。
这里将下载并安装支持 Python3.12 的 onnxruntime-gpu 1.24.0。
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/onnxruntime_gpu-1.24.0-cp312-cp312-linux_aarch64.whl在 JetPack 6.1 上运行#
安装 Ultralytics 包#
这里将在 Jetson 上安装 Ultralytics 包。首次导出模型时会自动安装导出依赖项,因此这里只需安装基础包。我们将主要关注 NVIDIA TensorRT 导出,因为 TensorRT 能确保充分发挥 Jetson 设备的性能。
-
更新软件包列表、安装 pip 并升级到最新版本
sudo apt update sudo apt install python3-pip -y pip install -U pip -
安装
ultralyticspip 包pip install ultralytics -
重启设备
sudo reboot
安装 PyTorch 和 Torchvision#
上述 Ultralytics 安装过程会安装 Torch 和 Torchvision。不过,通过 pip 安装的这两个包与基于 ARM64 架构的 Jetson 平台不兼容。因此,我们需要手动安装预构建的 PyTorch pip wheel,并从源代码编译或安装 Torchvision。
根据 JP6.1 安装 torch 2.10.0 和 torchvision 0.25.0
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torch-2.10.0-cp310-cp310-linux_aarch64.whl
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torchvision-0.25.0-cp310-cp310-linux_aarch64.whl访问 Jetson 版 PyTorch 页面,查看适用于不同 JetPack 版本的所有 PyTorch 版本。如需查看 PyTorch 和 Torchvision 兼容性详情,请访问 PyTorch 和 Torchvision 兼容性页面。
安装 cuDSS,以修复与 torch 2.10.0 相关的依赖问题
wget https://developer.download.nvidia.com/compute/cudss/0.7.1/local_installers/cudss-local-tegra-repo-ubuntu2204-0.7.1_0.7.1-1_arm64.deb
sudo dpkg -i cudss-local-tegra-repo-ubuntu2204-0.7.1_0.7.1-1_arm64.deb
sudo cp /var/cudss-local-tegra-repo-ubuntu2204-0.7.1/cudss-*-keyring.gpg /usr/share/keyrings/
sudo apt-get update
sudo apt-get -y install cudss
安装 onnxruntime-gpu#
使用与你的 JetPack、Python 和 CUDA 版本匹配的 ONNX Runtime GPU wheel。目前 PyPI 发布版本包含 ARM64 wheel,但它们不能替代适用于所有 JetPack 版本的设备专用包。
你可以在 Jetson Zoo ONNX Runtime 兼容性矩阵中找到所有可用的 onnxruntime-gpu 包,其中按 JetPack 版本、Python 版本和其他兼容性详情进行了分类。
对于支持 Python 3.10 的 JetPack 6,你可以安装 onnxruntime-gpu 1.23.0:
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/onnxruntime_gpu-1.23.0-cp310-cp310-linux_aarch64.whl或者,对于 onnxruntime-gpu 1.20.0:
pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/onnxruntime_gpu-1.20.0-cp310-cp310-linux_aarch64.whl在 JetPack 5.1.2 上运行#
安装 Ultralytics 包#
这里将在 Jetson 上安装 Ultralytics 包。首次导出模型时会自动安装导出依赖项,因此这里只需安装基础包。我们将主要关注 NVIDIA TensorRT 导出,因为 TensorRT 能确保充分发挥 Jetson 设备的性能。
-
更新软件包列表、安装 pip 并升级到最新版本
sudo apt update sudo apt install python3-pip -y pip install -U pip -
安装
ultralyticspip 包pip install ultralytics -
重启设备
sudo reboot
安装 PyTorch 和 Torchvision#
上述 Ultralytics 安装过程会安装 Torch 和 Torchvision。不过,通过 pip 安装的这两个包与基于 ARM64 架构的 Jetson 平台不兼容。因此,我们需要手动安装预构建的 PyTorch pip wheel,并从源代码编译或安装 Torchvision。
-
卸载当前已安装的 PyTorch 和 Torchvision
pip uninstall torch torchvision -
根据 JP5.1.2 安装
torch 2.1.0和torchvision 0.16.2pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torch-2.1.0a0+41361538.nv23.06-cp38-cp38-linux_aarch64.whl pip install https://github.com/ultralytics/assets/releases/download/v0.0.0/torchvision-0.16.2+c6f3977-cp38-cp38-linux_aarch64.whl
访问 Jetson 版 PyTorch 页面,查看适用于不同 JetPack 版本的所有 PyTorch 版本。如需查看 PyTorch 和 Torchvision 兼容性详情,请访问 PyTorch 和 Torchvision 兼容性页面。
安装 onnxruntime-gpu#
使用与你的 JetPack、Python 和 CUDA 版本匹配的 ONNX Runtime GPU wheel。目前 PyPI 发布版本包含 ARM64 wheel,但它们不能替代适用于所有 JetPack 版本的设备专用包。
你可以在 Jetson Zoo ONNX Runtime 兼容性矩阵中找到所有可用的 onnxruntime-gpu 包,其中按 JetPack 版本、Python 版本和其他兼容性详情进行了分类。这里将下载并安装支持 Python3.8 的 onnxruntime-gpu 1.17.0。
wget https://nvidia.box.com/shared/static/zostg6agm00fb6t5uisw51qi6kpcuwzd.whl -O onnxruntime_gpu-1.17.0-cp38-cp38-linux_aarch64.whl
pip install onnxruntime_gpu-1.17.0-cp38-cp38-linux_aarch64.whlonnxruntime-gpu 会自动将 NumPy 版本恢复到最新版本。因此,我们需要将 NumPy 重新安装为 1.23.5,以修复问题,执行以下命令:
pip install numpy==1.23.5
在 NVIDIA Jetson 上使用 TensorRT#
在 Ultralytics 支持的所有模型导出格式中,TensorRT 在 NVIDIA Jetson 设备上可提供最高的推理性能,因此是我们对 Jetson 部署的首选推荐。在导出之前,请安装 JetPack 版本提供的 TensorRT Python 绑定,并使用 python3 -c "import tensorrt; print(tensorrt.__version__)" 验证。请在 JetPack 6/7 上使用受支持的 TensorRT 10.x 运行时;不要将其替换为 TensorRT 11.2.1。如需设置说明和高级用法,请参阅我们的专用 TensorRT 集成指南。
你也可以直接在浏览器中导出,无需在本地配置构建环境。在 Ultralytics Platform 模型导出选项卡中,选择 TensorRT 和目标 Jetson 设备。Thor 选项会在实体 Thor 硬件上进行验证。目前,六种 Orin 选项会生成以 AGX-Orin 为目标构建的候选引擎;部署前请在目标 Orin SKU 上进行验证。
TensorRT 会在构建引擎的 GPU 上对引擎进行配置和调优。请确保目标设备的 GPU 架构以及 TensorRT/CUDA 运行时匹配,并在部署设备上验证每个下载的引擎。同架构的 Orin SKU 不一定能够直接兼容;为获得最佳效果,INT8 校准应在目标设备上进行。
将模型转换为 TensorRT 并运行推理#
将 PyTorch 格式的 YOLO26n 模型转换为 TensorRT,以使用导出的模型运行推理。
from ultralytics import YOLO

# 加载 YOLO26n PyTorch 模型
model = YOLO("yolo26n.pt")

# 将模型导出为 TensorRT
model.export(format="engine")  # 创建 'yolo26n.engine'

# 加载导出的 TensorRT 模型
trt_model = YOLO("yolo26n.engine")

# 运行推理
results = trt_model("https://ultralytics.com/images/bus.jpg")访问导出页面,查看将模型导出为不同格式时可用的其他参数
使用 NVIDIA 深度学习加速器 (DLA)#
NVIDIA 深度学习加速器 (DLA)是内置于 NVIDIA Jetson 设备中的专用硬件组件,可优化深度学习推理的能效和性能。DLA 将任务从 GPU 卸载出来(为更繁重的进程释放 GPU 资源),使模型能够以更低的功耗运行,同时保持较高的吞吐量,非常适合嵌入式系统和实时 AI 应用。
NVIDIA 列出的最后一个支持 DLA 的版本是 TensorRT 10.7;TensorRT 11.0、11.1 和 11.2 均不支持 DLA。请使用 JetPack 版本支持的 DLA 兼容 TensorRT 版本。TensorRT 11.2.1 不支持 JetPack,包括仅使用 GPU 的导出。
以下 Jetson 设备配备了 DLA 硬件:
| Jetson 设备 | DLA 核心数 | DLA 最高频率 |
|---|---|---|
| Jetson AGX Orin 系列 | 2 | 1.6 GHz |
| Jetson Orin NX 16GB | 2 | 614 MHz |
| Jetson Orin NX 8GB | 1 | 614 MHz |
| Jetson AGX Xavier 系列 | 2 | 1.4 GHz |
| Jetson Xavier NX 系列 | 2 | 1.1 GHz |
from ultralytics import YOLO

# 加载 YOLO26n PyTorch 模型
model = YOLO("yolo26n.pt")

# 启用 DLA 将模型导出为 TensorRT(仅适用于 FP16 或 INT8)
model.export(format="engine", device="dla:0", quantize=16)  # dla:0 或 dla:1 对应 DLA 核心

# 加载导出的 TensorRT 模型
trt_model = YOLO("yolo26n.engine")

# 运行推理
results = trt_model("https://ultralytics.com/images/bus.jpg")使用 DLA 导出时,某些层可能不受 DLA 支持,因此会回退到 GPU 执行。这种回退可能会增加延迟并影响整体推理性能。因此,与完全在 GPU 上运行 TensorRT 相比,DLA 的主要设计目标并非降低推理延迟,而是提高吞吐量和能效。
NVIDIA Jetson YOLO26 基准测试#
Ultralytics 团队对 YOLO26 进行了基准测试,测试了 11 种不同模型格式的速度和准确率:PyTorch、TorchScript、ONNX、OpenVINO、TensorRT、TF SavedModel、TF GraphDef、TF Lite、MNN、NCNN、ExecuTorch。基准测试设备包括 NVIDIA Jetson AGX Thor Developer Kit、NVIDIA Jetson AGX Orin Developer Kit(64GB)、NVIDIA Jetson Orin Nano Super Developer Kit,以及由 Jetson Orin NX 16GB 驱动的 Seeed Studio reComputer J4012;测试采用 FP32 精度,默认输入图像尺寸为 640。
对比图表#
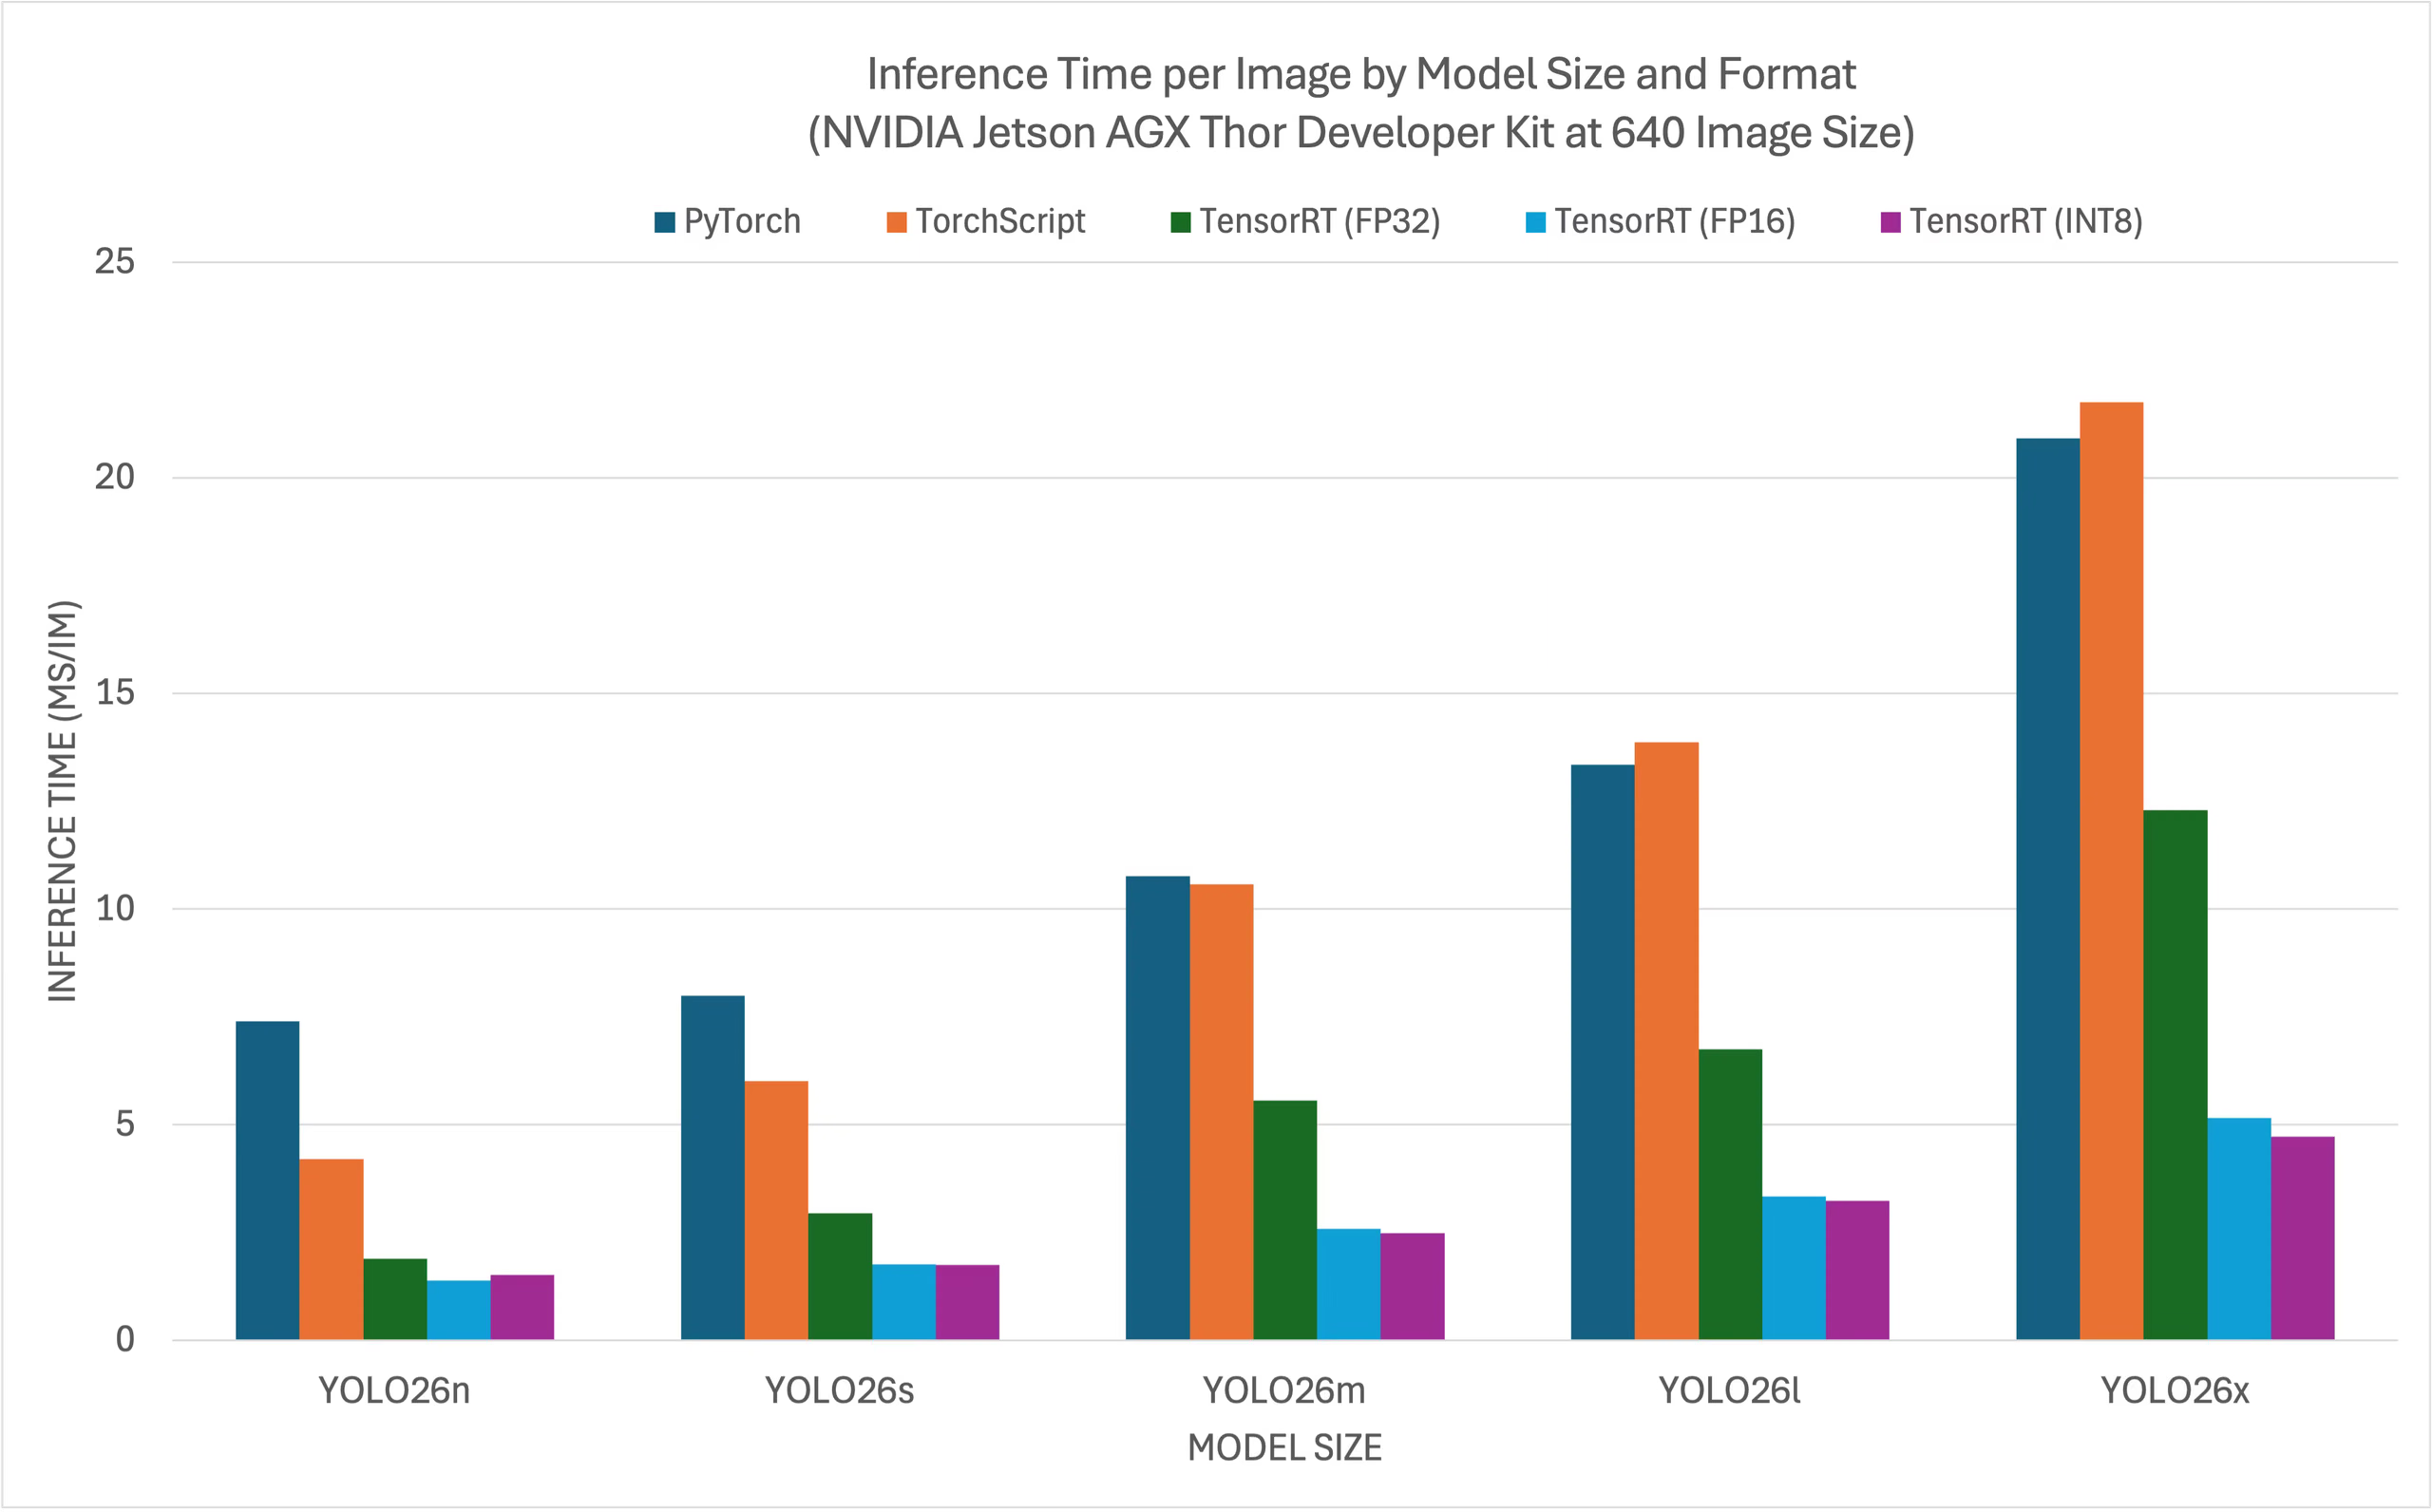
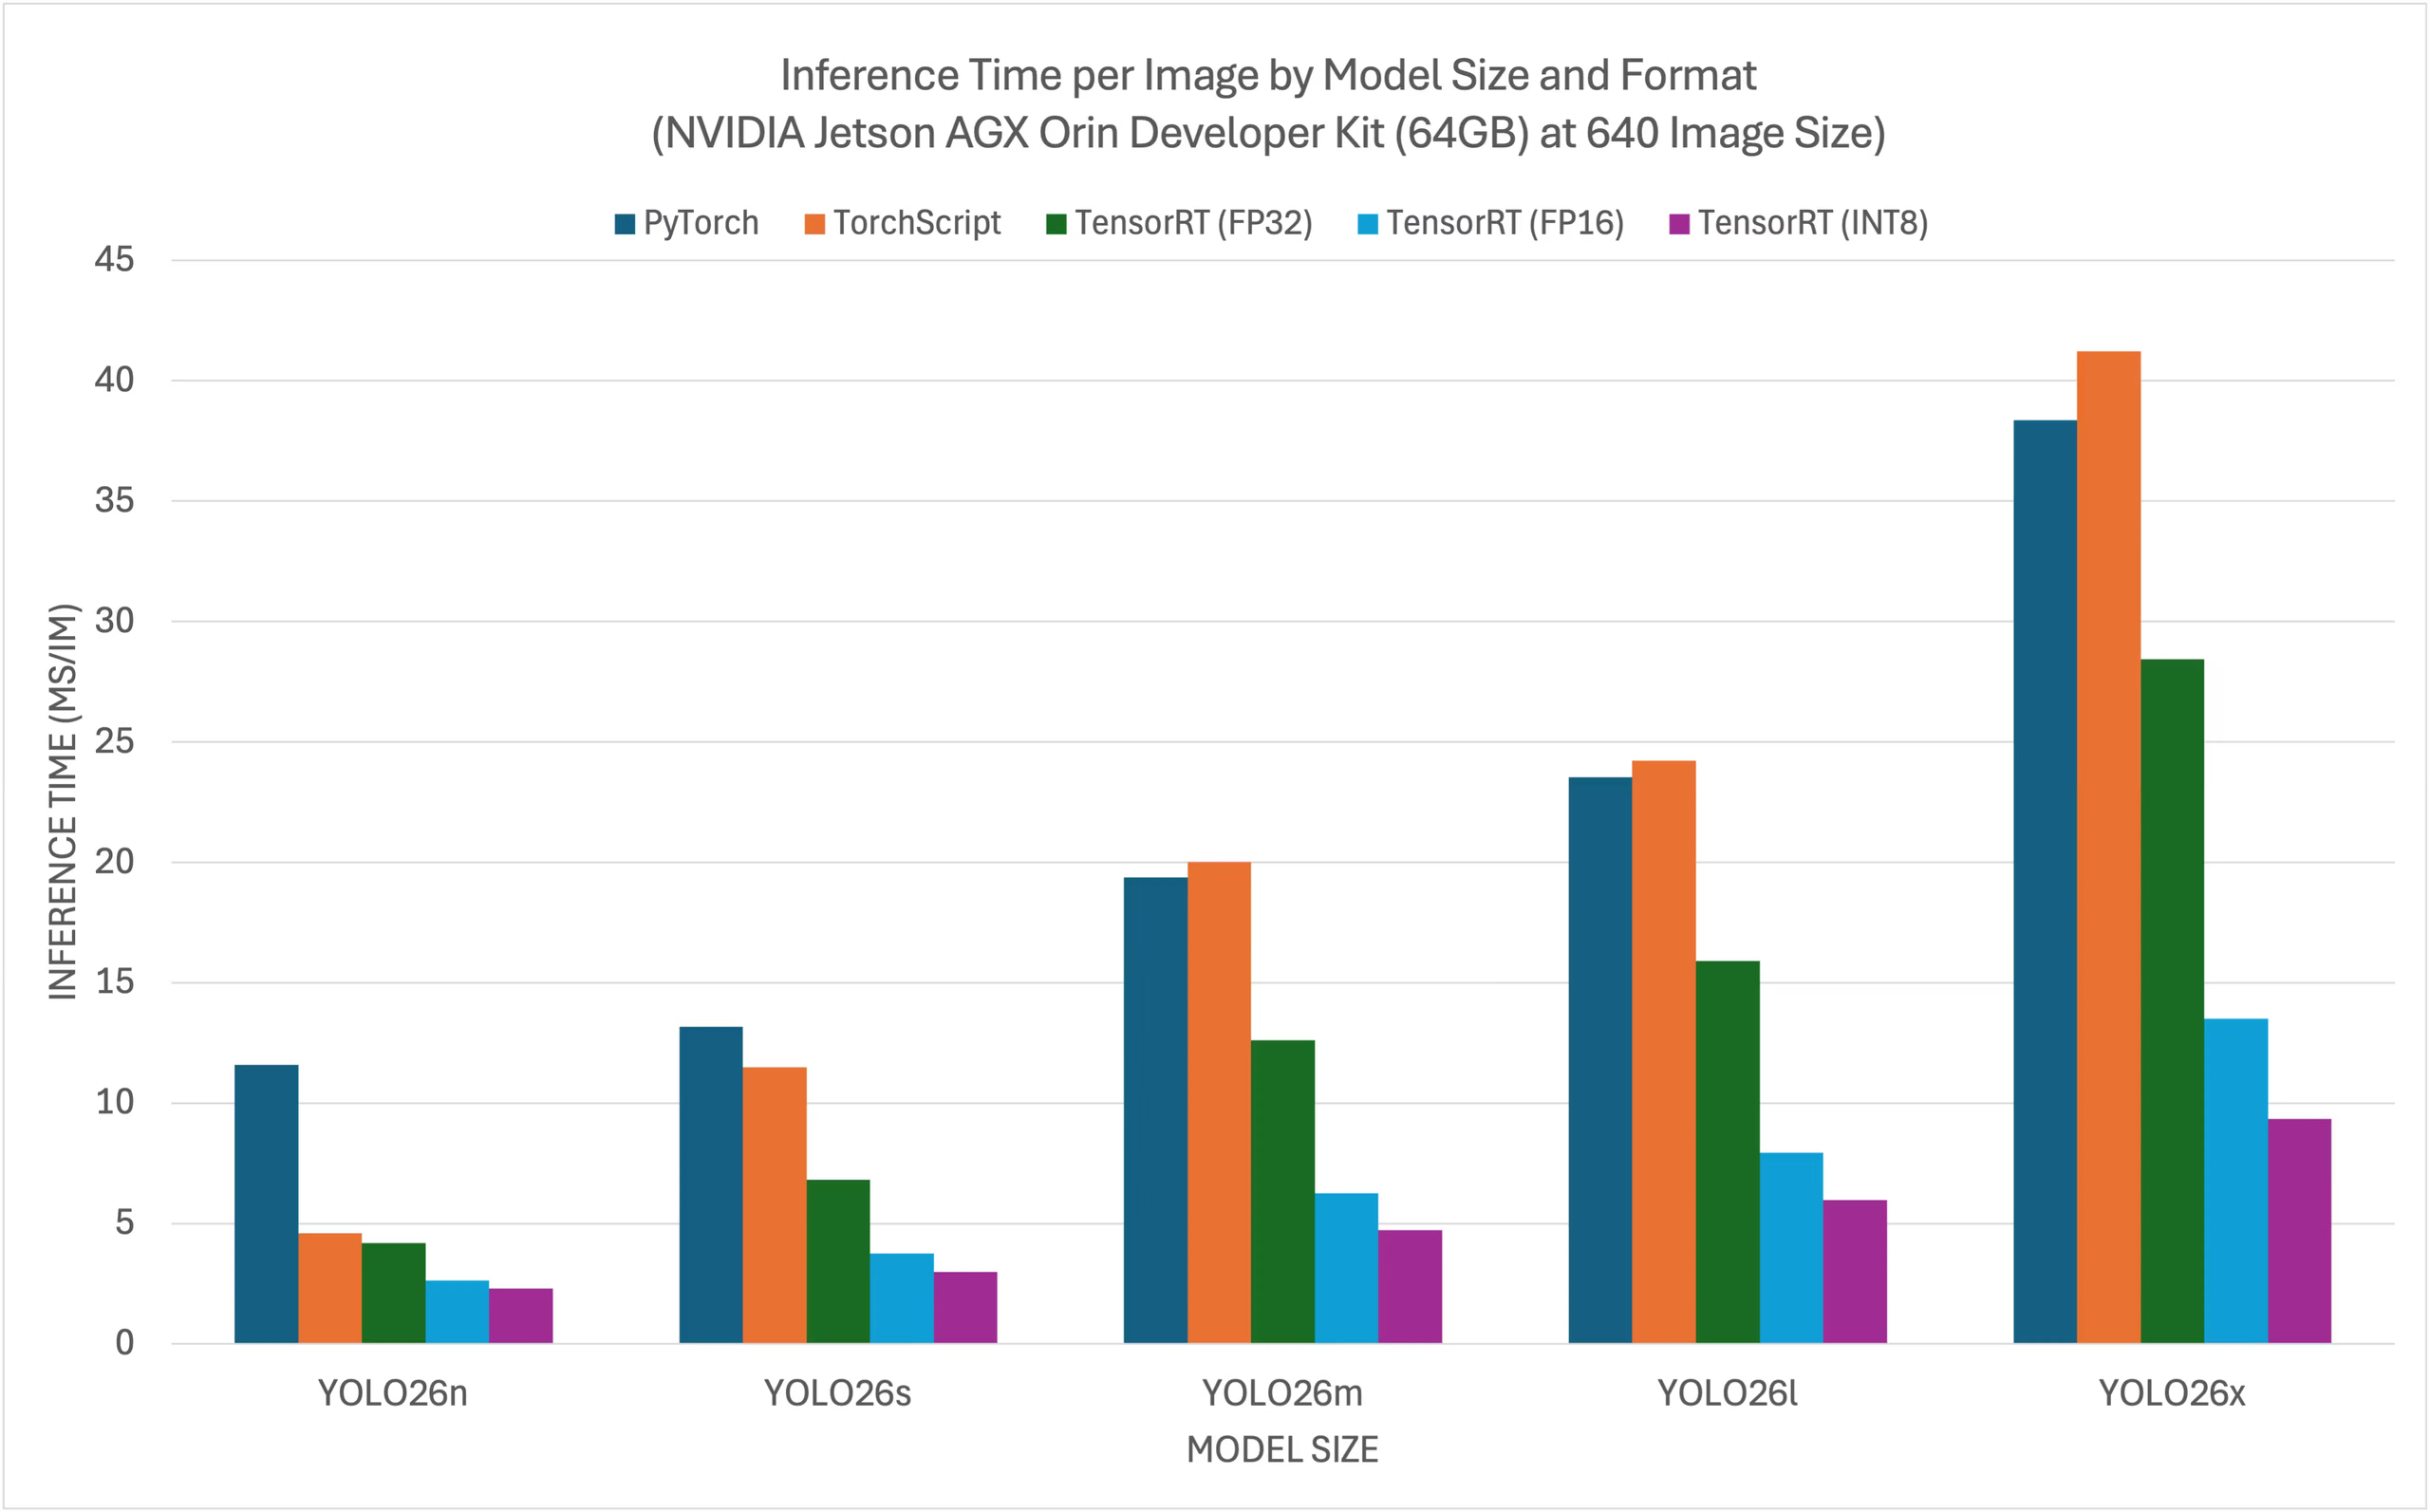
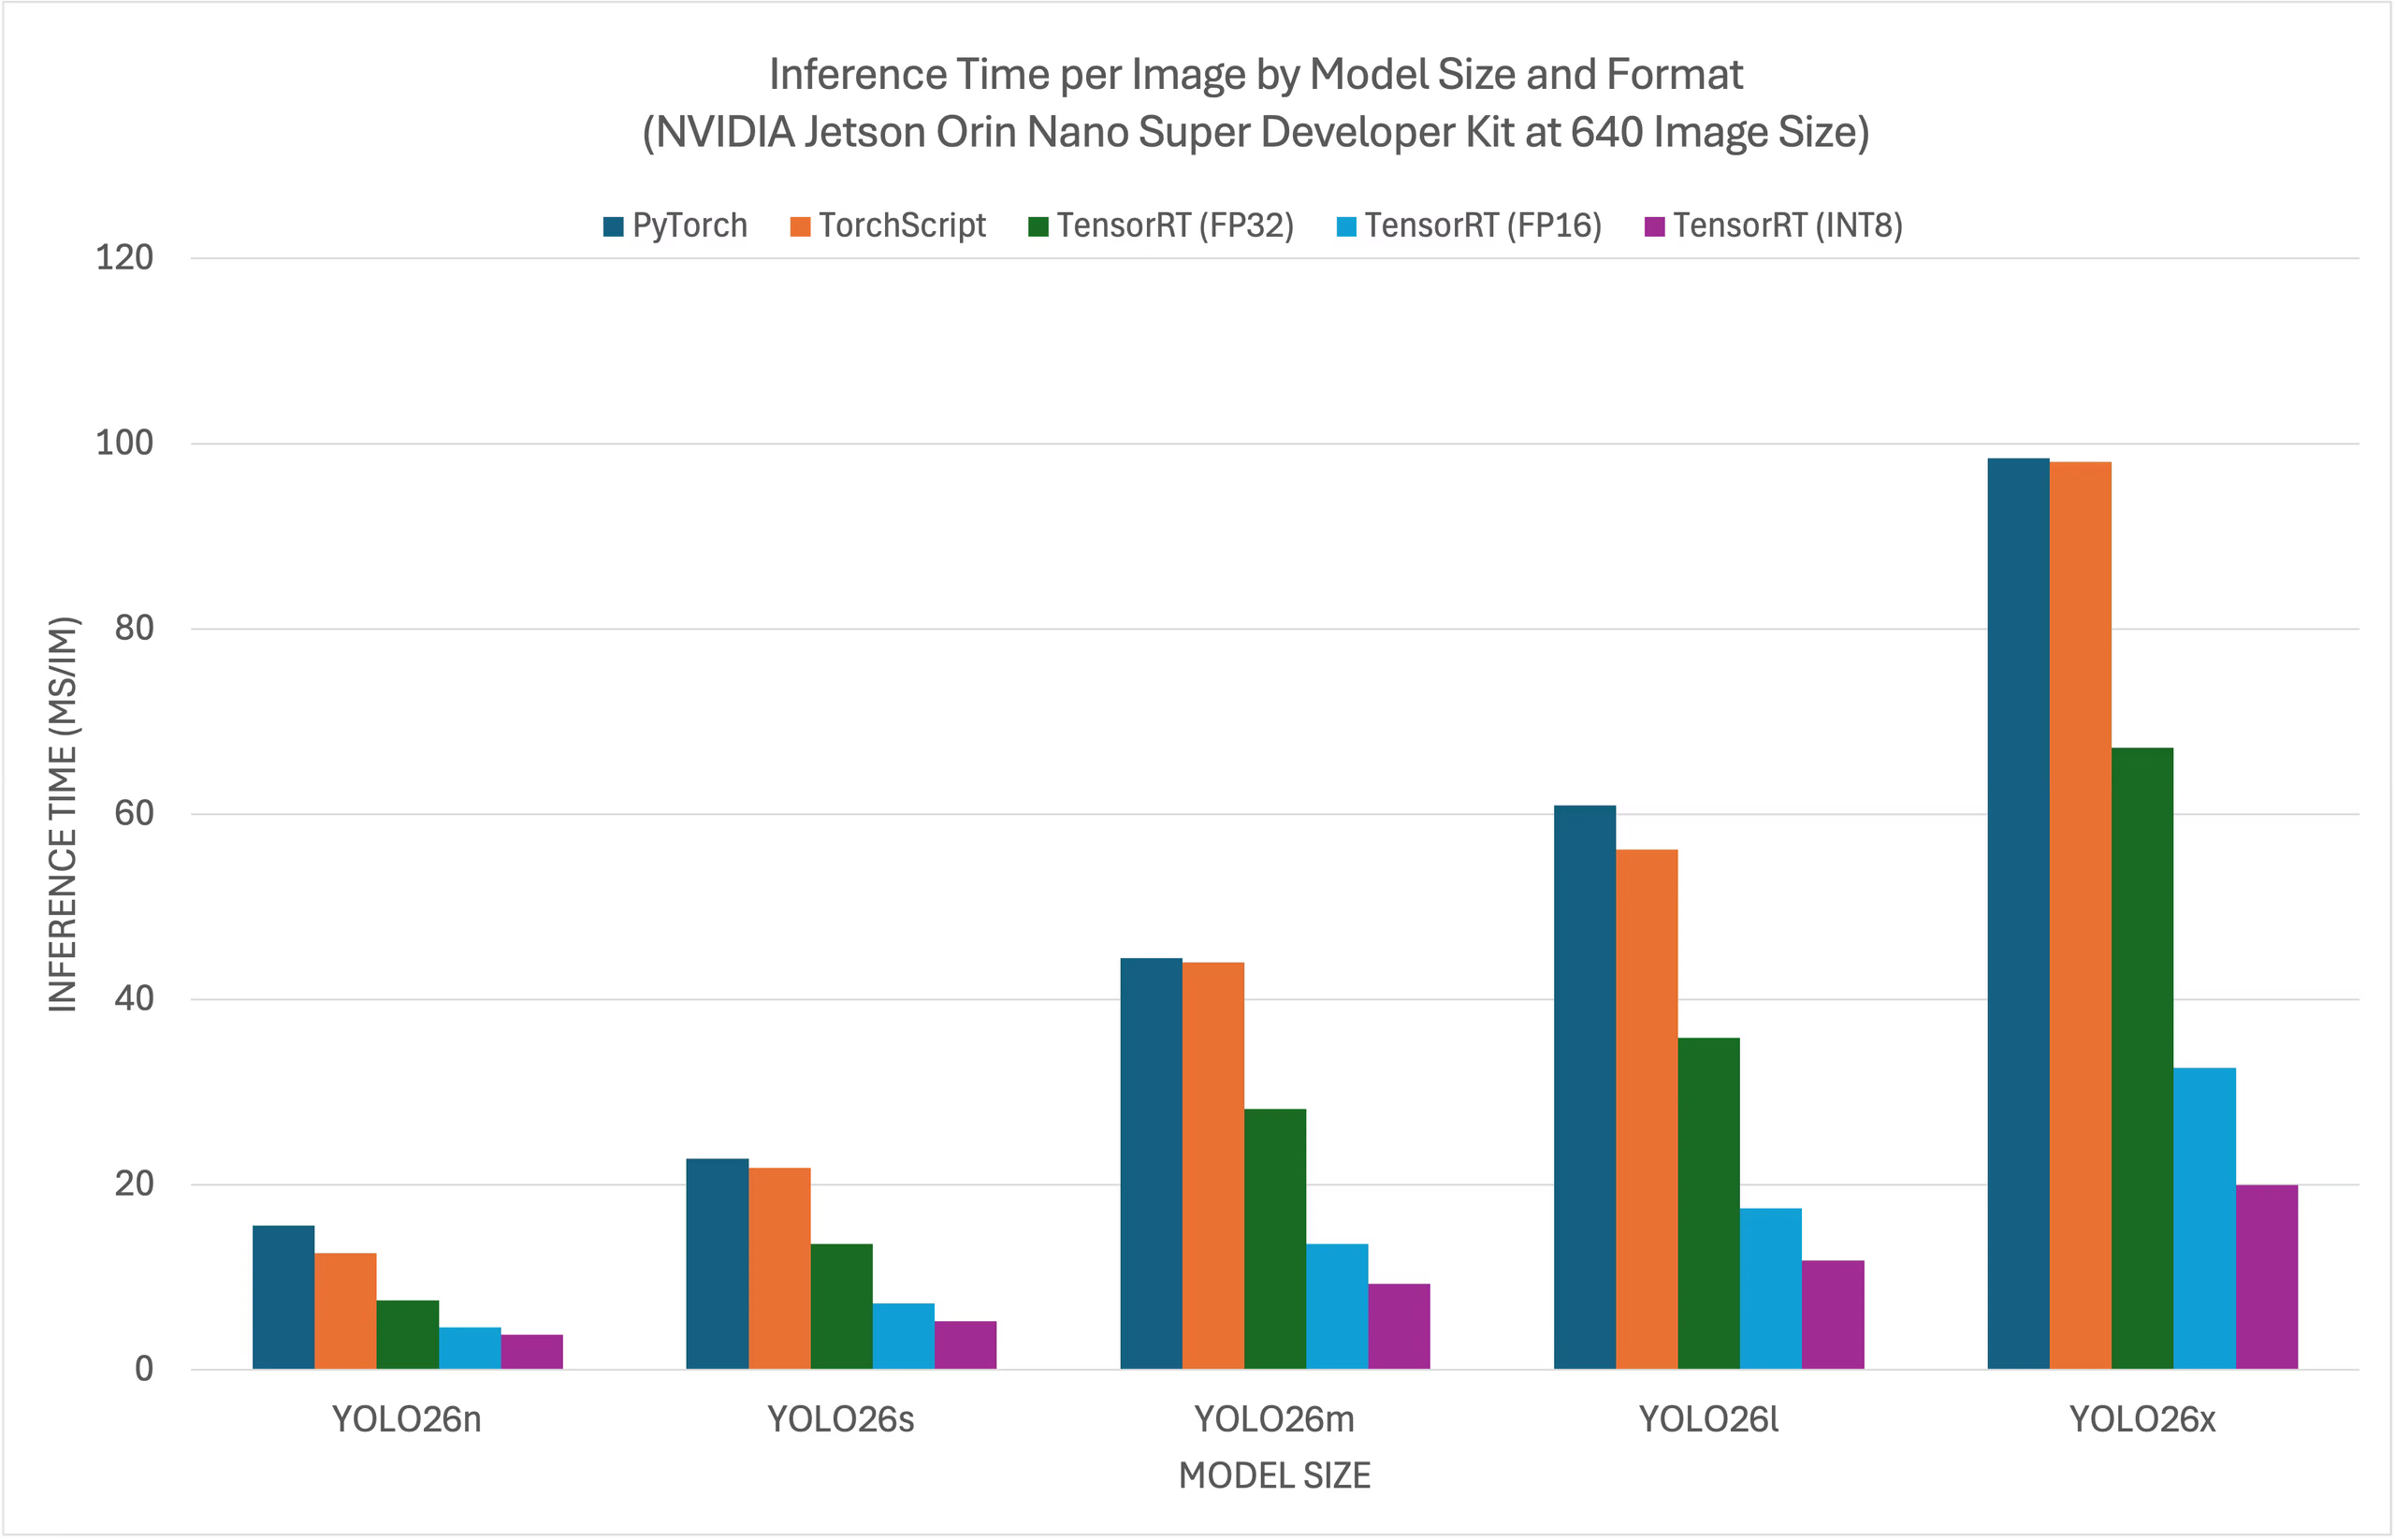
虽然所有模型导出格式都能在 NVIDIA Jetson 上运行,但下方对比图表仅列出 PyTorch、TorchScript、TensorRT,因为这些格式会使用 Jetson 的 GPU,并且能够保证获得最佳结果。其他导出格式都只使用 CPU,性能不如上述三种格式。你可以在此图表后面的部分查看所有导出格式的基准测试结果。
NVIDIA Jetson AGX Thor 开发者套件#
NVIDIA Jetson AGX Orin 开发者套件 (64GB)#
NVIDIA Jetson Orin Nano Super 开发者套件#
NVIDIA Jetson Orin NX 16GB#
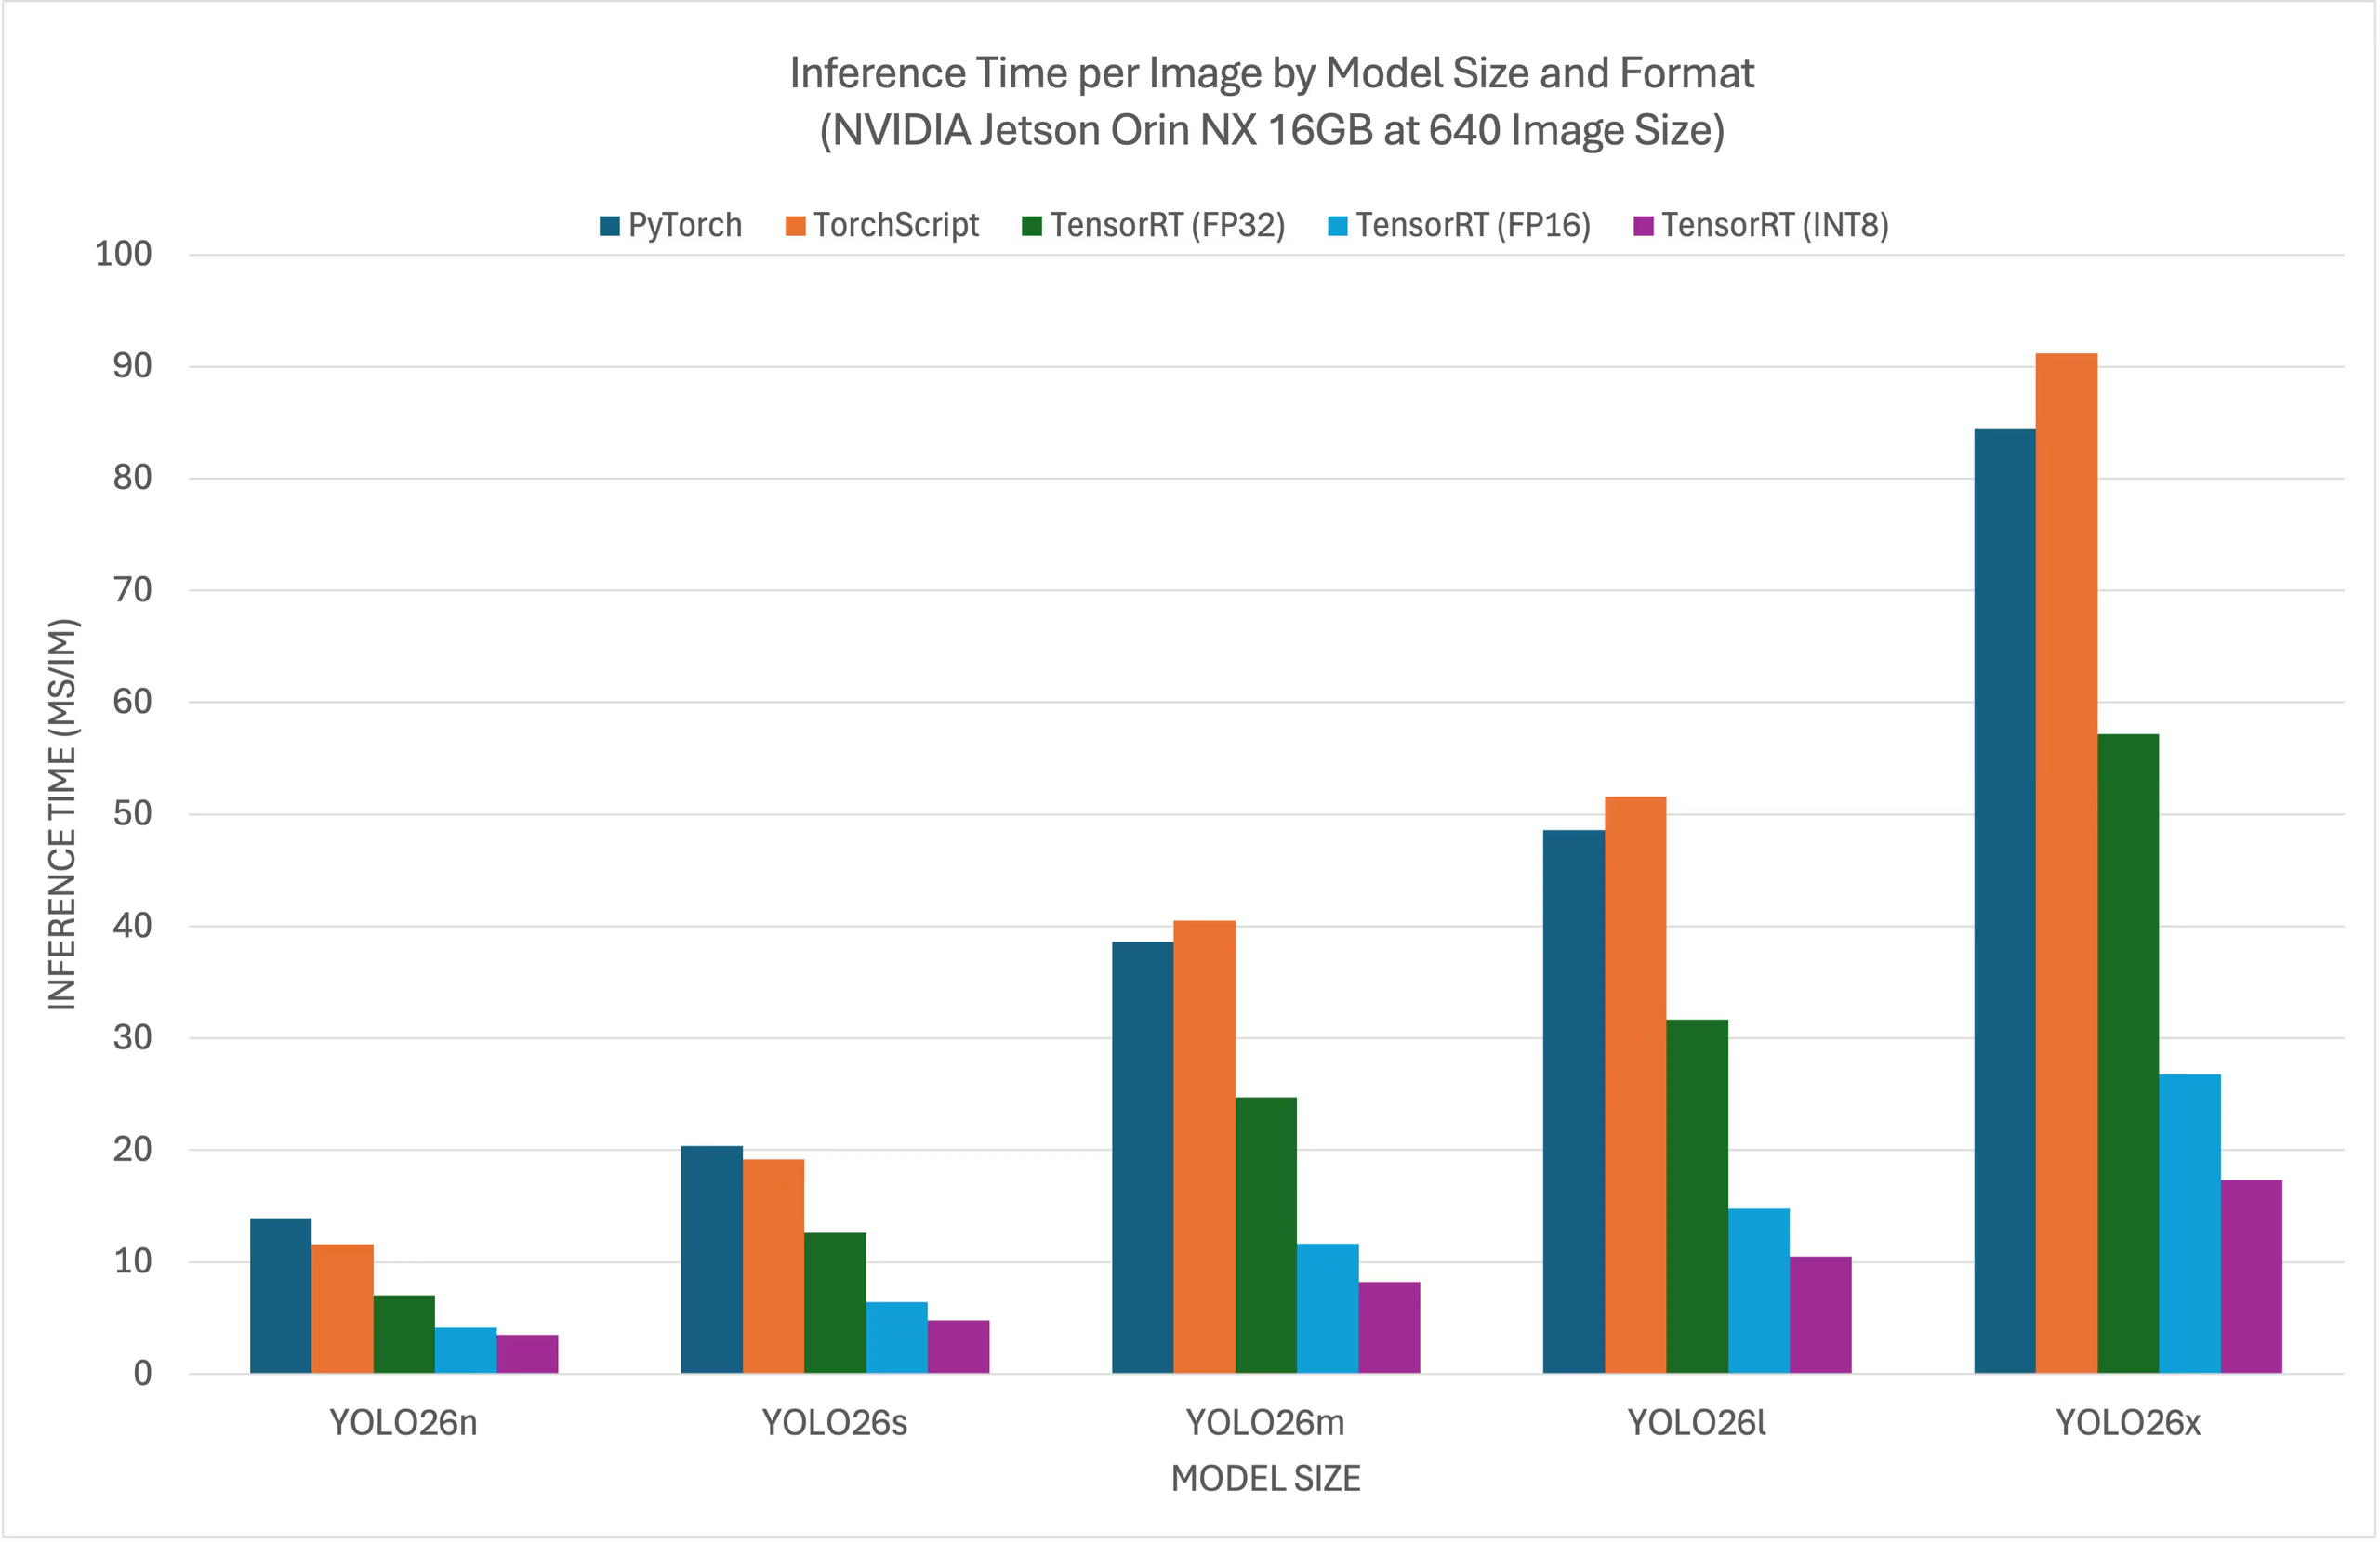
详细对比表#
下表展示了五种不同模型(YOLO26n、YOLO26s、YOLO26m、YOLO26l、YOLO26x)在 11 种不同格式(PyTorch、TorchScript、ONNX、OpenVINO、TensorRT、TF SavedModel、TF GraphDef、TF Lite、MNN、NCNN、ExecuTorch)下的基准测试结果,列出了每种组合的状态、大小、mAP50-95(B) 指标和推理时间。
NVIDIA Jetson AGX Thor 开发者套件#
| 格式 | 状态 | 磁盘占用大小 (MB) | mAP50-95(B) | 推理时间 (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4798 | 7.39 |
| TorchScript | ✅ | 9.8 | 0.4789 | 4.21 |
| ONNX | ✅ | 9.5 | 0.4767 | 6.58 |
| OpenVINO | ✅ | 10.1 | 0.4794 | 17.50 |
| TensorRT (FP32) | ✅ | 13.9 | 0.4791 | 1.90 |
| TensorRT (FP16) | ✅ | 7.6 | 0.4797 | 1.39 |
| TensorRT (INT8) | ✅ | 6.5 | 0.4273 | 1.52 |
| TF SavedModel | ✅ | 25.7 | 0.4764 | 47.24 |
| TF GraphDef | ✅ | 9.5 | 0.4764 | 45.98 |
| TF Lite | ✅ | 9.9 | 0.4764 | 182.04 |
| MNN | ✅ | 9.4 | 0.4784 | 21.83 |
使用 Ultralytics 8.4.7 进行基准测试
推理时间不包括预处理和后处理。
NVIDIA Jetson AGX Orin 开发者套件 (64GB)#
| 格式 | 状态 | 磁盘占用大小 (MB) | mAP50-95(B) | 推理时间 (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4790 | 11.58 |
| TorchScript | ✅ | 9.8 | 0.4770 | 4.60 |
| ONNX | ✅ | 9.5 | 0.4770 | 9.87 |
| OpenVINO | ✅ | 9.6 | 0.4820 | 28.80 |
| TensorRT (FP32) | ✅ | 11.5 | 0.4770 | 4.18 |
| TensorRT (FP16) | ✅ | 7.9 | 0.4789 | 2.62 |
| TensorRT (INT8) | ✅ | 5.4 | 0.4640 | 2.30 |
| TF SavedModel | ✅ | 24.6 | 0.4760 | 71.10 |
| TF GraphDef | ✅ | 9.5 | 0.4760 | 70.02 |
| TF Lite | ✅ | 9.9 | 0.4760 | 227.94 |
| MNN | ✅ | 9.4 | 0.4760 | 32.46 |
| NCNN | ✅ | 9.3 | 0.4810 | 29.93 |
使用 Ultralytics 8.4.32 进行基准测试
推理时间不包括预处理和后处理。
NVIDIA Jetson Orin Nano Super 开发者套件#
| 格式 | 状态 | 磁盘占用大小 (MB) | mAP50-95(B) | 推理时间 (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4790 | 15.60 |
| TorchScript | ✅ | 9.8 | 0.4770 | 12.60 |
| ONNX | ✅ | 9.5 | 0.4760 | 15.76 |
| OpenVINO | ✅ | 9.6 | 0.4820 | 56.23 |
| TensorRT (FP32) | ✅ | 11.3 | 0.4770 | 7.53 |
| TensorRT (FP16) | ✅ | 8.1 | 0.4800 | 4.57 |
| TensorRT (INT8) | ✅ | 5.3 | 0.4490 | 3.80 |
| TF SavedModel | ✅ | 24.6 | 0.4760 | 118.33 |
| TF GraphDef | ✅ | 9.5 | 0.4760 | 116.30 |
| TF Lite | ✅ | 9.9 | 0.4760 | 286.00 |
| MNN | ✅ | 9.4 | 0.4760 | 68.77 |
| NCNN | ✅ | 9.3 | 0.4810 | 47.50 |
使用 Ultralytics 8.4.33 进行基准测试
推理时间不包括预处理和后处理。
NVIDIA Jetson Orin NX 16GB#
| 格式 | 状态 | 磁盘占用大小 (MB) | mAP50-95(B) | 推理时间 (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.3 | 0.4799 | 13.90 |
| TorchScript | ✅ | 9.8 | 0.4787 | 11.60 |
| ONNX | ✅ | 9.5 | 0.4763 | 14.18 |
| OpenVINO | ✅ | 9.6 | 0.4819 | 40.19 |
| TensorRT (FP32) | ✅ | 11.4 | 0.4770 | 7.01 |
| TensorRT (FP16) | ✅ | 8.0 | 0.4789 | 4.13 |
| TensorRT (INT8) | ✅ | 5.5 | 0.4489 | 3.49 |
| TF SavedModel | ✅ | 24.6 | 0.4764 | 92.34 |
| TF GraphDef | ✅ | 9.5 | 0.4764 | 92.06 |
| TF Lite | ✅ | 9.9 | 0.4764 | 254.43 |
| MNN | ✅ | 9.4 | 0.4760 | 48.55 |
| NCNN | ✅ | 9.3 | 0.4805 | 34.31 |
使用 Ultralytics 8.4.33 进行基准测试
推理时间不包括预处理和后处理。
了解 Seeed Studio 开展的更多基准测试,这些测试运行在不同版本的 NVIDIA Jetson 硬件上。
复现我们的结果#
如需在所有导出格式下复现上述 Ultralytics 基准测试,请运行以下代码:
from ultralytics import YOLO

# 加载 YOLO26n PyTorch 模型
model = YOLO("yolo26n.pt")

# 在 COCO128 数据集上对 YOLO26n 的所有导出格式进行速度和精度基准测试
results = model.benchmark(data="coco128.yaml", imgsz=640)
请注意,基准测试结果可能因系统的具体硬件和软件配置,以及运行基准测试时系统的当前负载而有所不同。为获得最可靠的结果,请使用包含大量图像的数据集,例如 data='coco.yaml'(5000 张验证图像)。
使用 NVIDIA Jetson 的最佳实践#
使用 NVIDIA Jetson 时,遵循一些最佳实践可以让运行 YOLO26 的 NVIDIA Jetson 发挥最佳性能。
-
启用 MAX 电源模式
在 Jetson 上启用 MAX 电源模式,可确保所有 CPU、GPU 核心均处于开启状态。
sudo nvpmodel -m 0 -
启用 Jetson Clocks
启用 Jetson Clocks 可确保所有 CPU、GPU 核心均以最高频率运行。
sudo jetson_clocks -
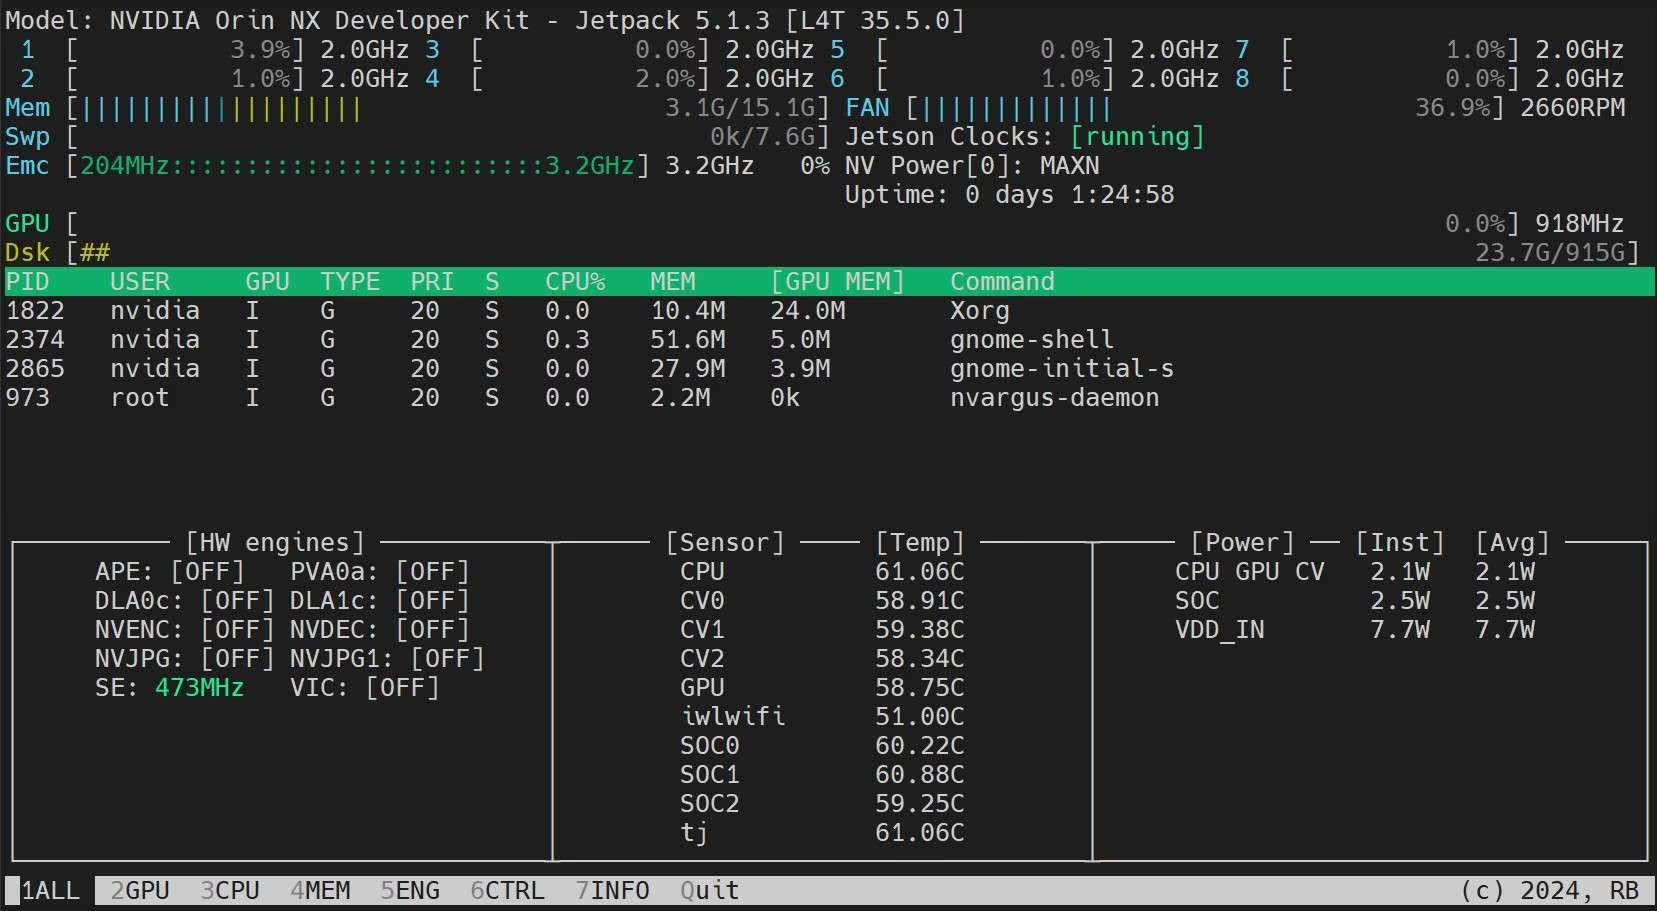
安装 Jetson Stats 应用
我们可以使用 jetson stats 应用监控系统组件的温度,并查看其他系统详情,例如 CPU、GPU 和 RAM 的利用率、更改电源模式、设置最高时钟频率以及查看 JetPack 信息。
sudo apt update
sudo pip install jetson-stats
sudo reboot
jtop
NVIDIA Jetson 内存优化技巧#
可用内存通常是 Jetson 设备的性能瓶颈,尤其是在 Jetson Orin Nano (8 GB) 或 Orin NX 8 GB 等内存较小的型号上。以下技巧都是切实可行且风险较低的调整,综合运用可释放数百 MB 内存,让你运行更大的 YOLO 模型或支持更多并行工作负载。要了解全面的介绍,请参阅 NVIDIA 关于提升 Jetson 内存效率的博客。
1. 切换到无头(无图形界面)启动#
如果你的 Jetson 通过 SSH 连接,或作为未连接显示器的生产设备运行,移除桌面环境和显示服务器最多可释放 865 MB RAM:
sudo systemctl set-default multi-user.target
sudo reboot
稍后如需恢复桌面环境:
sudo systemctl set-default graphical.target
sudo reboot
2. 禁用未使用的系统服务#
非必要的后台服务(蓝牙、连接管理器、未使用的硬件守护进程)合计约占用 32 MB。列出当前运行的服务,并禁用部署不需要的服务:
# List running services
systemctl list-units --type=service --state=running

# Disable a service
sudo systemctl disable SERVICE_NAME
3. 分析内存使用情况#
开始优化前,先找出实际占用 RAM 的进程。procrank 会按 PSS(比例集大小)对进程排序。与 RSS(常驻集大小,即进程映射的物理 RAM 页面总量,包括与其他进程共享的页面)相比,PSS 能更准确地反映每个进程的实际内存占用:
git clone https://github.com/csimmonds/procrank_linux.git
cd procrank_linux && make
sudo ./procrank
查看每个进程的 GPU 和 NvMap(CUDA/视频管线)分配情况:
sudo cat /sys/kernel/debug/nvmap/iovmm/clients4. 在生产环境中不连接显示器运行推理#
对于不需要实时预览的推理管线,禁用显示相关组件(Tiler、OSD、DisplaySink)仅从管线本身就能节省 200+ MB。使用 Ultralytics YOLO 时,关闭查看器并将结果写入磁盘:
from ultralytics import YOLO

model = YOLO("yolo26n.engine")

# show=False 可阻止打开任何显示窗口;save=True 可将带标注的输出写入磁盘
results = model.predict(source="video.mp4", show=False, save=True)累计影响#
| 优化项 | 大约节省的内存 |
|---|---|
| 禁用桌面图形界面 | ~865 MB |
| 禁用未使用的操作系统服务 | ~32 MB |
| 无头推理管线(无显示) | ~200+ MB |
| 合计(轻松实现的优化) | ~1 GB+ |
对于在内存受限设备上运行 TensorRT INT8 模型,这些改动组合起来尤其有价值——它们可能决定更大的模型变体能否装入内存。
后续步骤#
如需进一步学习和获取支持,请参阅 Ultralytics YOLO26 文档。
常见问题#
在 NVIDIA Jetson 设备上部署 Ultralytics YOLO26 的过程很简单。首先,使用 NVIDIA JetPack SDK 为 Jetson 设备刷写系统。然后,你可以使用预构建的 Docker 镜像快速设置,也可以手动安装所需软件包。两种方式的详细步骤请参阅使用 Docker 快速开始和从原生安装开始章节。
YOLO26 模型已在多种 NVIDIA Jetson 设备上进行基准测试,结果显示性能显著提升。例如,TensorRT 格式可提供最佳推理性能。详细对比表章节中的表格全面展示了不同模型格式的 mAP50-95 和推理时间等性能指标。
由于性能出色,强烈建议在 NVIDIA Jetson 上使用 TensorRT 部署 YOLO26 模型。TensorRT 利用 Jetson 的 GPU 能力加速推理,从而确保最高效率和速度。要了解如何转换为 TensorRT 并运行推理,请参阅在 NVIDIA Jetson 上使用 TensorRT章节。
要在 NVIDIA Jetson 上安装 PyTorch 和 Torchvision,请先卸载可能通过 pip 安装的现有版本。然后,手动安装与 Jetson ARM64 架构兼容的 PyTorch 和 Torchvision 版本。有关此过程的详细说明,请参阅安装 PyTorch 和 Torchvision章节。
要在 NVIDIA Jetson 上使用 YOLO26 获得最佳性能,请遵循以下最佳实践:
- 启用 MAX 电源模式,以使用所有 CPU 和 GPU 核心。
- 启用 Jetson Clocks,让所有核心以最高频率运行。
- 安装 Jetson Stats 应用以监控系统指标。
有关命令和更多详情,请参阅使用 NVIDIA Jetson 的最佳实践章节。
可用 RAM 通常是内存较小的 Jetson 设备的瓶颈。以下三项简单优化结合使用,可释放超过 1 GB 内存:
- 切换到无头启动(
sudo systemctl set-default multi-user.target),移除桌面图形界面(可节省约 865 MB)。 - 禁用未使用的服务,例如蓝牙或连接管理器(可节省约 32 MB)。
- 不连接显示器运行推理:在 YOLO 的
predict调用中设置show=False,避免分配显示管线内存(可节省约 200+ MB)。
使用
procrank分析每个进程的 RAM 使用情况,并使用sudo cat /sys/kernel/debug/nvmap/iovmm/clients检查 GPU 分配。完整详情请参阅内存优化技巧章节。- 切换到无头启动(
JetPack 6 附带的 TensorRT 10.3.0 存在一个已知问题,会导致无法构建无 NMS (
nms=False) INT8 引擎。Ultralytics 检测到这种组合时,会自动选择一对多检测头以确保导出成功。要恢复无 NMS INT8 导出,请将 TensorRT 升级到较新版本(例如 10.7.0+):
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/arm64/cuda-keyring_1.1-1_all.deb
sudo dpkg -i cuda-keyring_1.1-1_all.deb
sudo apt-get update
sudo apt-get install -y tensorrt
升级后,请重新运行导出。更多详情请参阅 GitHub issue #23841。