Guide de démarrage rapide de Modal pour Ultralytics
Ce guide explique comment exécuter Ultralytics YOLO26 sur Modal, pour l’inférence GPU sans serveur et l’entraînement des modèles.
Qu’est-ce que Modal ?#
Modal est une plateforme de calcul cloud sans serveur dédiée aux charges de travail d’IA et d’apprentissage automatique. Elle gère automatiquement le provisionnement, la mise à l’échelle et l’exécution : tu écris du code Python en local et Modal l’exécute dans le cloud avec accès au GPU. Elle est ainsi particulièrement adaptée à l’exécution de modèles d’apprentissage profond comme YOLO26 sans avoir à gérer l’infrastructure.
Ce que tu vas apprendre#
- Configurer Modal et s’authentifier
- Exécuter l’inférence YOLO26 sur Modal
- Utiliser des GPU pour accélérer l’inférence
- Entraîner des modèles YOLO26 sur Modal
Prérequis#
- Un compte Modal (inscris-toi gratuitement sur modal.com)
- Python 3.9 ou une version ultérieure installé sur ta machine locale
Installation#
Installe le package Modal pour Python :
pip install modalAuthentifie ensuite la CLI avec ton compte Modal :
modal token newLa commande modal token new ouvre une fenêtre de navigateur pour authentifier ton compte Modal. Une fois authentifié, tu peux exécuter des commandes Modal depuis le terminal.
Exécuter l’inférence YOLO26#
Crée un fichier Python nommé modal_yolo.py pour exécuter l’inférence avec le code suivant :
"""
Modal + Ultralytics YOLO26 Quickstart
Run: modal run modal_yolo.py.
"""

import modal

app = modal.App("ultralytics-yolo")

image = modal.Image.debian_slim(python_version="3.11").apt_install("libgl1", "libglib2.0-0").pip_install("ultralytics")

@app.function(image=image)
def predict(image_url: str):
    """Run YOLO26 inference on an image URL."""
    from ultralytics import YOLO

    model = YOLO("yolo26n.pt")
    results = model(image_url)

    for r in results:
        print(f"Detected {len(r.boxes)} objects:")
        for box in r.boxes:
            print(f"  - {model.names[int(box.cls)]}: {float(box.conf):.2f}")

@app.local_entrypoint()
def main():
    """Test inference with sample image."""
    predict.remote("https://ultralytics.com/images/bus.jpg")
Exécute l’inférence :
modal run modal_yolo.pyRésultat attendu :
✓ Initialized. View run at https://modal.com/apps/your-username/main/ap-xxxxxxxx
✓ Created objects.
├── 🔨 Created mount modal_yolo.py
└── 🔨 Created function predict.
Downloading https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26n.pt to 'yolo26n.pt'...
Downloading https://ultralytics.com/images/bus.jpg to 'bus.jpg'...
image 1/1 /root/bus.jpg: 640x480 4 persons, 1 bus, 377.8ms
Speed: 5.8ms preprocess, 377.8ms inference, 0.3ms postprocess per image at shape (1, 3, 640, 480)

Detected 5 objects:
  - bus: 0.92
  - person: 0.91
  - person: 0.91
  - person: 0.87
  - person: 0.53
✓ App completed.
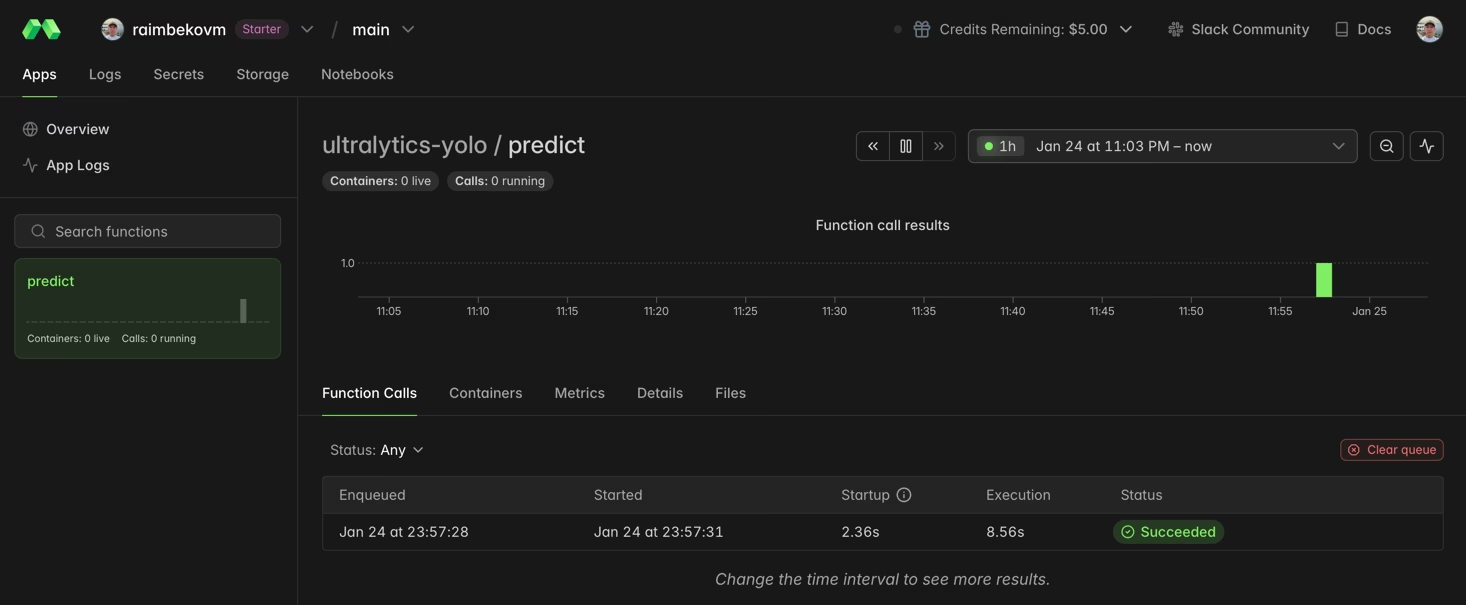
Tu peux surveiller l’exécution de ta fonction dans le tableau de bord Modal :
Utiliser un GPU pour accélérer l’inférence#
Ajoute un GPU à ta fonction en indiquant le paramètre gpu :
@app.function(image=image, gpu="T4")  # Options: "T4", "A10G", "A100", "H100"
def predict_gpu(image_url: str):
    """Run YOLO26 inference on GPU."""
    from ultralytics import YOLO

    model = YOLO("yolo26n.pt")
    results = model(image_url)
print(results[0].boxes)| GPU | Mémoire | Idéal pour |
|---|---|---|
| T4 | 16 GB | Inférence, entraînement de petits modèles |
| A10G | 24 GB | Tâches d’entraînement de taille moyenne |
| A100 | 40 GB | Entraînement à grande échelle |
| H100 | 80 GB | Performances maximales |
Entraîner YOLO26 sur Modal#
Pour l’entraînement, utilise un GPU et les Volumes Modal afin de disposer d’un stockage persistant. Crée un fichier Python nommé train_yolo.py :
import modal

app = modal.App("ultralytics-training")

volume = modal.Volume.from_name("yolo-training-vol", create_if_missing=True)

image = modal.Image.debian_slim(python_version="3.11").apt_install("libgl1", "libglib2.0-0").pip_install("ultralytics")

@app.function(image=image, gpu="T4", timeout=3600, volumes={"/data": volume})
def train():
    """Train YOLO26 model on Modal."""
    from ultralytics import YOLO

    model = YOLO("yolo26n.pt")
    model.train(data="coco8.yaml", epochs=3, imgsz=640, project="/data/runs")

@app.local_entrypoint()
def main():
    train.remote()
Lance l’entraînement :
modal run train_yolo.pyLes volumes Modal conservent les données entre les exécutions de fonctions. Les poids entraînés sont enregistrés dans /data/runs/train/weights/.
La configuration d’Ultralytics YOLO26 sur Modal est terminée. Pour approfondir le sujet :
- Découvre les fonctionnalités avancées dans la documentation Ultralytics YOLO26
- Découvre comment entraîner des modèles personnalisés avec tes propres jeux de données
- Essaie le guide de démarrage rapide Docker pour un déploiement conteneurisé
- Consulte la documentation Modal pour découvrir les fonctionnalités avancées de la plateforme
FAQ#
Pour l’inférence, une NVIDIA T4 (16 Go) est généralement suffisante et économique. Pour l’entraînement ou les modèles plus volumineux comme YOLO26x, envisage des GPU A10G ou A100.
Modal facture à la seconde. Tarifs approximatifs : CPU ~0,05 $/h, T4 ~0,59 $/h, A10G ~1,10 $/h, A100 ~2,10 $/h. Consulte les tarifs Modal pour connaître les tarifs actuels.
Oui, tu peux exécuter ton propre modèle YOLO entraîné sur mesure sur Modal en chargeant le fichier de poids depuis un volume Modal :
model = YOLO("/data/my_custom_model.pt")Pour en savoir plus sur l’entraînement de modèles personnalisés, consulte le guide d’entraînement.


Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.